登录社区云,与社区用户共同成长
邀请您加入社区
本文从零讲解词向量的训练与保存全流程。先用 Numpy 演示 .npy / .npz 的保存与读取,这是深度学习中间产物落盘的基本功;再对比 One-hot 编码与分布式词向量,说明为何需要 Word2Vec。随后基于 PyTorch 实现 CBOW 模型:用上下文词预测中心词,经 Embedding 查表、向量平均、全连接与 log_softmax 输出,用 NLLLoss 训练。最后提取 Em
本文介绍了推荐系统中基于物品相似度的i2i召回算法,重点讲解了Word2Vec/Item2Vec和Swing两种核心方法。Item2Vec将用户行为序列类比自然语言处理中的句子,通过训练获得物品的向量表示来计算相似度。Swing算法则通过计算物品被共同消费的频率来评估相似性,特别适合电商场景。文章还对比了三种i2i算法的优缺点:Item2Vec适用于序列数据,Swing对抗热门物品效果好但计算量大
文章目录简介简单介绍一下word2vec 和item2vec的原理简介本文可以算是一遍item2vector的工程化教程,其基本理论源自于论文《Item2Vec: Neural Item Embedding for Collaborative Filtering》(https://arxiv.org/abs/1603.04259)将引导你了解word2vec背后的思想,以及它在电商推荐系统领域..
本章介绍了推荐系统中u2i召回算法的核心原理与实战应用。首先对比了i2i和u2i的区别,指出u2i的核心在于构建用户embedding并匹配物品embedding。重点讲解了三种模型:FM(特征交叉)、DeepFM(增强特征建模)和双塔模型(工业主流)。双塔模型通过将用户和物品映射到同一向量空间,实现高效向量检索。最后提供了完整的双塔模型代码实现,采用对比损失训练。总结指出:i2i侧重相似性,u2
本文是一份基于gensim库的word2vec实战指南,详细介绍了如何从基础的文本相似度计算过渡到构建一个完整的推荐系统原型。文章重点解析了word2vec的核心参数调优、从词向量到句向量的转换方法(如TF-IDF加权),并提供了可运行的代码示例,帮助开发者解决实际业务中的语义理解和智能推荐问题。
本文记录了使用gensim库的Word2Vec这个词向量工具,基于已经训练好的词向量模型进行词向量预测,以及计算文本相似度
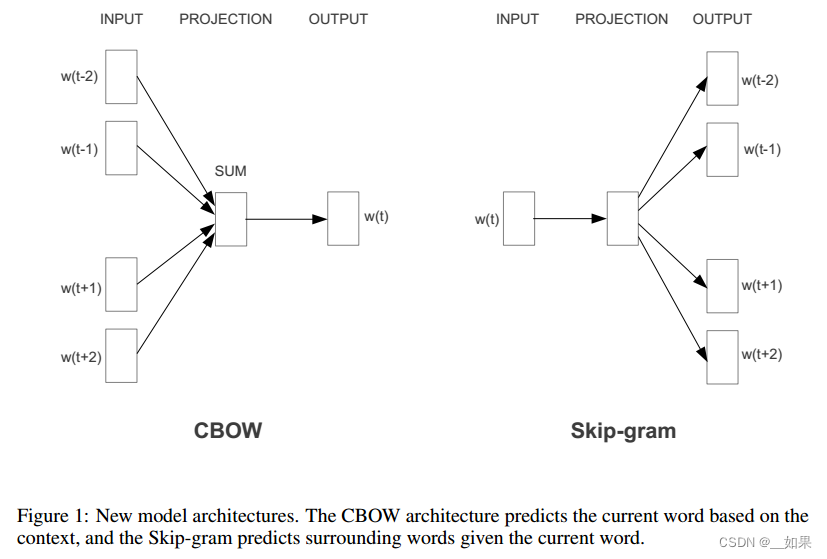
SKIP-GRAM输入层:中心词的one hot表示,looktable查表【Vd 表,每个词作为中心词的表示】得到中心词的embedding 表示[1300]隐藏层: [W 大小为30010000],Vd 大小,是每个词作为背景词的表示输出层:经过softmax,得到每个词的概率。训练数据: ( input word, output word ) 单词对input word和output wor
Gensim—word2vec加载开源预训练词向量其它相关博客:词向量模型Word2Vec模型构建训练加载预训练词向量并使用腾讯AI Lab预训练词向量:https://ai.tencent.com/ailab/nlp/zh/embedding.html本文下载其中最小的文件,点此下载from gensim.models import KeyedVectors# 文件解压,调用txt文件txt_f
EPLAN史上最全部件库,官网下载,部件宏,EDZ格式,大小合适导入容易 部件包含图片宏,尺寸宏,有西门子全系列PLC,s7-1200 1500 300 400 200三菱FX系列,数字模拟,特殊模块,三菱变频器,伺服,触摸屏,台达,施耐徳,正泰,欧姆龙,得力西,ABB等低压电器等等。例如,当你需要设计一个包含西门子S7-1200 PLC的系统时,你可以直接使用库中的宏,这样可以确保你的设计与实物
提供的一个用于测试的小型文本数据集。它包含一些示例句子,格式是一个嵌套的 Python 列表,其中每个子列表代表一个文档,文档由单词(字符串)组成。重新加载,并进行推理(如获取词向量、查找相似词等)。如果你想在自己的数据集上使用类似的处理方式,可以参考。代表余弦相似度,接近 1 说明两个词较为相似。的格式来组织你的文本数据。
负采样是Word2Vec中用来加速模型训练的一种技术。它通过从词汇表中随机选择一些负样本来减少计算量,从而使模型能够在大规模数据集上高效训练。负采样在 Skip-gram 和 CBOW 模型中得到了广泛应用,是生成高质量词向量的核心技术之一。虽然负采样在计算效率上有明显优势,但它也有一定的局限性,特别是在负样本选择和细节学习方面。
在传统的 NLP 方法中,单词通常被表示为稀疏的 one-hot 向量。假设词汇表大小为 ,每个单词都对应于一个长度为 的向量,其中只有一个位置为 1,其余为 0。维度灾难:当词汇量很大时,one-hot 向量的维度也会很高,增加了计算复杂度。缺乏语义信息:one-hot 向量无法捕捉单词之间的语义和语法关系。因此,研究者们开始探索如何将单词表示为低维度的稠密向量(通常是 50-300 维),并且
(3)此时队列中最小的频次(权重)为2,继续取出节点进行合并,过程依次为将1、3合并为node4(权重4),node2、4合并为node5(权重4),node1、node3合并为node6(权重4),node4、node5合并成node7(权重8),然后将node6和1合并成node8(权重9),最后将node7和node8合并为node9(权重17)得到Huffman树,如下图所示。由于CBOW
【小白入门Word2Vec】最近在忙毕设,要学习一些AI的技术。很多资料看来看去,感觉只是在大脑皮层表面略过了一下,遂还是决定采用老方法,写博客!!!对了,我也只是一个萌新,博客的内容仅代表我个人当前的理解,可能会有偏差。若有不对,感谢指正。
数据集 [[0, 1, 2, 3, 4, 5, 6], [7, 8, 9]]中心词 2 的上下文词是 [0, 1, 3, 4]中心词 4 的上下文词是 [2, 3, 5, 6]中心词 1 的上下文词是 [0, 2, 3]中心词 5 的上下文词是 [3, 4, 6]中心词 3 的上下文词是 [2, 4]中心词 6 的上下文词是 [4, 5]中心词 7 的上下文词是 [8, 9]中心词 8 的上下文词
我们希望通过自己训练业务相关的语料word2vec模型来获得词嵌入、词相关性查询等。根据自己的业务场景准备训练数据,比如用户在商城上的同购行为序列或同浏览行为序列。
词嵌入(Word Embedding)是一种将词语表示为实数向量的技术。传统的词表示方法,如one-hot编码,将每个词表示为一个高维的稀疏向量,这种表示方法无法捕捉词语之间的语义关系。而词嵌入通过将词语映射到一个低维的连续向量空间,使得语义相似的词在向量空间中的距离更近,从而更好地捕捉词语之间的关系。
本次作业与代码见上篇翻译。
本文介绍了在 Python 中使用 gensim 库进行 Word2Vec 的基本步骤。通过准备语料、数据预处理、构建模型和使用模型,我们可以将 Word2Vec 应用于文本数据集,并获得词向量和相似词汇,从而提取文本语义信息。希望这篇文章能够帮助你入门 Word2Vec 在 Python 中的应用。
文本表示是自然语言处理中的基础工作,文本表示的好坏直接影响到整个自然语言处理系统的性能。文本向量化就是将文本表示成一系列能够表达文本语义的向量,是文本表示的一种重要方式。目前对文本向量化大部分的研究都是通过词向量化实现的,也有一部分研究者将句子作为文本处理的基本单元,于是产生了 doc2vec 和 str2vec 技术。
具体来说,CBOW是上下文预测中间词,我们将上下文初始化的词嵌入进行求和得到一个X表示,哈夫曼树的每一个节点都是一个逻辑回归判断,从根节点开始,向下判断,直到落到目标节点上,此时把已走的路径的LR值相乘,即得到此时的条件概率,而训练的目标就是使得整个条件概率达到最大。哈夫曼树是带权路径和最短的最优二叉树,所以通过对词表中的词进行树构造,可以生成一个哈夫曼树,越接近根节点的词,其词频是越高的,我们需
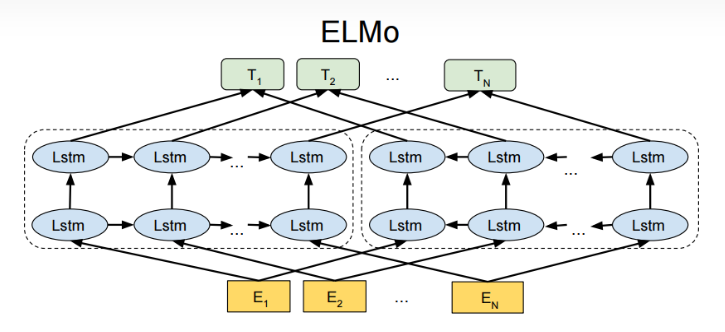
这也是为什么ELMO,GPT,bert问世之后word2vec就不再有以前的光环了,因为ELMO,GPT,bert都是用的动态词向量表示,可以很好的表示上下文语义。word2vec最大的缺陷:由于它是静态词向量表示导致不能表示一词多义的情况,举个例子“苹果”一词,在果蔬的句子中表示的就是水果的含义,Skip-Gram:给定一个词,预测其周围的上下文词汇,侧重于词汇的扩散语义。但是word2vec的
这些参数共同决定了 Word2Vec 模型的训练过程和最终学习到的词向量的质量。根据具体的应用场景和语料库的特点,可以调整这些参数以获得更好的结果。:词向量训练时的上下文窗口大小。在训练时,窗口大小决定了模型考虑的上下文单词数量。:输入的句子集合,可以是一个可迭代对象,每个元素表示一个句子,句子则是由单词组成的列表。:训练时使用的线程数量,用于加速训练过程。:词向量的维度大小。它决定了每个单词在训
【代码】基于Tensorflow实现word2vec。
python实现word2vec,测试模型相似度
我们提出了两种新的模型架构,用于计算来自非常大的数据集的单词的连续向量表示。在单词相似度任务中测量这些表示的质量,并将结果与先前基于不同类型神经网络的最佳表现技术进行比较。我们观察到在更低的计算成本下,准确率有了很大的提高,即从16亿个单词数据集中学习高质量的单词向量只需要不到一天的时间。此外,我们展示了这些向量在我们的测试集上提供了最先进的性能,用于测量句法和语义单词相似度。生成词向量又快又好。
简单介绍关于自然语言处理下的词嵌入向量技术word2vec技术。
如有侵权立即删除。
传统的词向量表示其位置是固定了,不会因为上下文语句不同而产生变化,但是在日常生活中,一词多义是非常常见的,例如“apple”这个词,既可以表示苹果,也可以表示公司;这篇论文解决了单词的一词多义问题,即词的位置可以通过上下文的不同而发生改变;ELMo具有深层次的网络结构,其使用了多层的LSTM,这比仅仅使用单层LSTM层显著提高了性能;同时由于LSTM是循环神经网络,其可以捕捉单词意义的上下文;大量
gensim库中word2vec的使用方式层次 Softmax是什么,使用和不使用有什么区别?哪个好?负采样数是什么?一般训练时候要加吗?什么情况下用?一般值设为多少?
分析Android应用程序的运行行为对于恶意软件检测至关重要。在本文中,我们尝试从函数调用中学习应用程序的行为级特征。这个任务的挑战有两方面。首先,缺乏函数属性阻碍了对应用程序行为的理解。其次,函数调用的图形表示不能直接由传统的机器学习算法处理。在本文中,我们开发了两种方法来克服这些挑战。基于函数嵌入,我们首先提出了增强函数调用图(E-FCGs)的概念,以描述应用程序的运行行为。然后,我们开发了一
训练结束后会产生三个模型文件wiki_zh.model、wiki_zh.model.wv.vectors.npy、wiki_zh.model.syn1neg.npy,找到其中的:opencc-1.0.1-win64,将wiki_zh.txt拷贝到该文件夹下,在opencc-1.0.1-win64文件夹下使用如下命令。命令执行一会,执行结束后会产生一个文件wiki_zh_jian.txt,这个文件就
接下来就是正式使用word2vec的时候了,以下是使用word2vec的文件。然后就全部成了简体了,使用word2vec工具需要做的最后一步是分词。直接浏览,可以看出这里面全是繁体字,所以下面需要把繁体转换成简体。的文件名,第二个是要处理的数据文件名,第三个是要输出的文件名。文件放在同一个目录下,并且用命令行跳转到这个目录,然后执行。然后解压后放在一个能记住的位置,例如我是。其中,这一句是配置需要
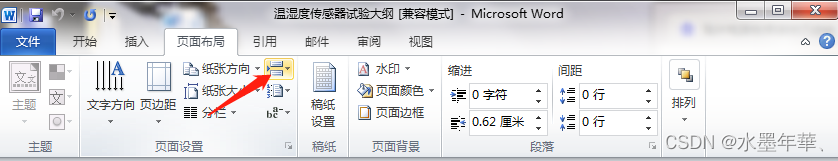
1.文件-更多-选项-自定义功能区-自定义。2.根据中文说明选择需要设置快捷键的功能。②ctrl+backspace删除表格的行。①ctrl+win插入表格。③ctrl+删除表格的列。
1、在Word中,默认为一节,每节的页码是连续的,若想在一个Word文档中,前三页不设页码,从第四页正文开始设置页码,必须插入分节符,使文档分成两节,这样就可以单独设置页码。2、操作步骤:将光标放在第4页的首部,单击页面布局---->插入分页符和分隔符---->分节符---->下一页,如图所示;6、单击页眉和页脚工具设计----->页码----->页面底端----普通数字2即可。4、单击页眉和页脚
word→插入→符号→字体选择<Lucida Sans Unicode>. 子集选择<零杂技术用符号>,分别插入⌊和⌋即可。遇到了一个很严谨的审稿人,他指出我在文章里的取整符号使用[]是不对的,应该是。那么这个符号在word里如何插入呢?
word2vec是早期NLP的必要预处理过程,其用于生成词的向量表示(embeding)。其将单词映射为固定长度的向量(embeding向量),GloVe主要在原来loss函数中引入了两点特性。
解决pycharm运行word2vec缺少C依赖的问题。
word宏设置,批量设置
word交叉引用自动更新
解释了skip-gram,continuous bag-of-word两个word2vec模型与负采样、层序softmax的原理,以及乞丐版skip-gram代码实现
Word里面Mathtype自动编号使用流程
word2vec哈夫曼编码/层次softmax讲解
虚假新闻检测
word2vec——训练自己的word2vec模型
word2vec负采样介绍
word2vec
——word2vec
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 亚马逊云科技技术品牌专区

 天工造物局



 DAMO开发者矩阵
 AtomGit开源社区
 乐奇 Rokid 开放社区