- @laukal


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
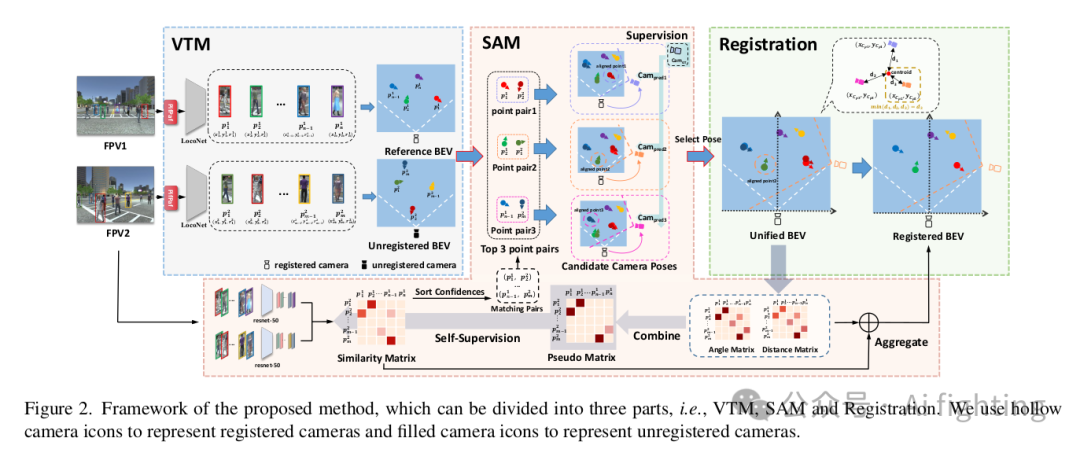
我们解决了一个新的问题,即在鸟瞰视角(BEV)中无需预先给定相机校准的多视角相机和目标注册问题。这将多视角目标注册问题提升到一个新的无需校准的阶段,从而极大地缓解了许多实际应用中的限制。然而,这是一个非常具有挑战性的问题,因为其唯一的输入是来自不同第一人称视角first-person views(FPVs)的多个RGB图像,没有BEV图像和FPVs的校准,而输出是从所有视角聚合到一个统一平面的图像
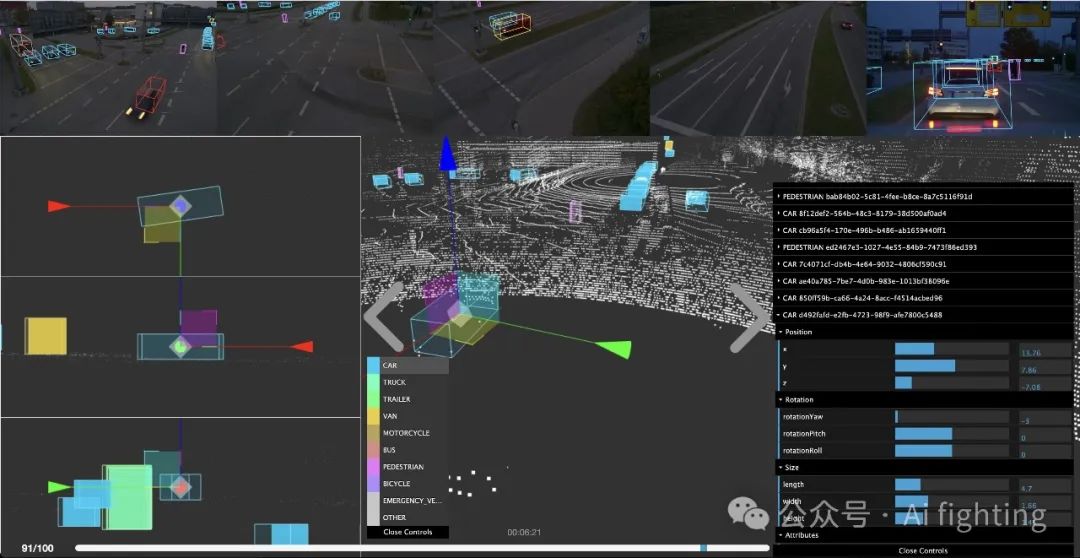
随着人工智能技术的不断发展,点云数据处理在自动驾驶、机器人导航、虚拟现实等领域发挥着越来越重要的作用。作为业界领先的3D物体检测标注工具,3D BAT近日发布了一系列重磅更新,为用户带来了前所未有的便捷与高效。代码地址:3D BAT的这次重磅更新,标志着我们在三维空间标注领域迈出了重要一步。我们坚信,通过不断的技术创新和优化,3D BAT将为用户带来前所未有的标注体验,助力各行各业在三维世界中探索
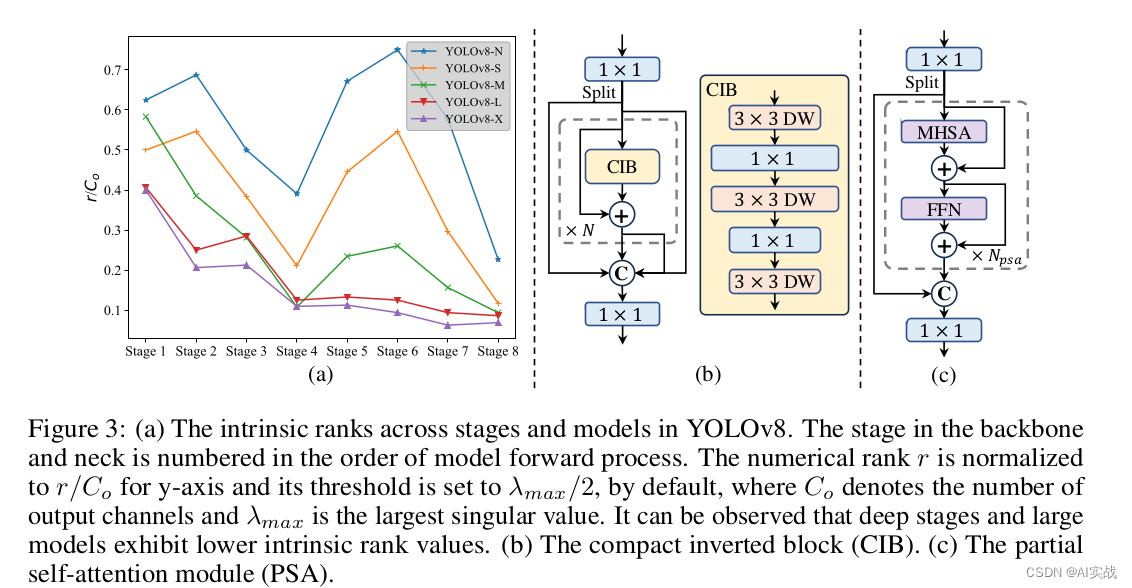
摘要在过去的几年中,YOLOs由于在计算成本和检测性能之间实现了有效的平衡,已经成为实时目标检测领域的主导范式。研究人员已经探索了YOLOs的架构设计、优化目标、数据增强策略等,取得了显著的进展。然而,对非极大值抑制(NMS)的依赖限制了YOLOs的端到端部署,并负面影响了推理延迟。此外,YOLOs中各个组件的设计缺乏全面和彻底的检查,导致明显的计算冗余并限制了模型的能力。这使得效率次优,并且有很
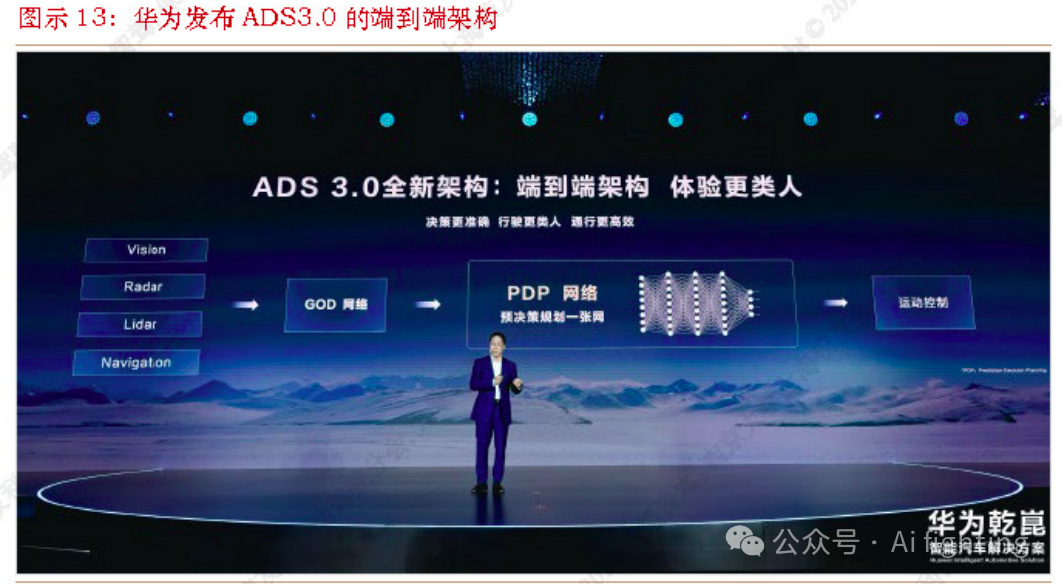
2024年5月20日,小鹏汽车举办AIDay发布会,董事长、CEO何小鹏宣布端到端大模型上车。小鹏的端到端大模型有三个组成部分:神经网络XNet+控大模型XPlanner+大语言模型XBrain。小鹏汽车在发布会上表示,端到端大模型上车后,18个月内小鹏智能驾驶能力将提高30倍,每2天内部将做次智驾模型的送代。2024年4月24日,华为智能汽车解决方案发布会上,华为发布了以智能驾驶为核心的全新智能
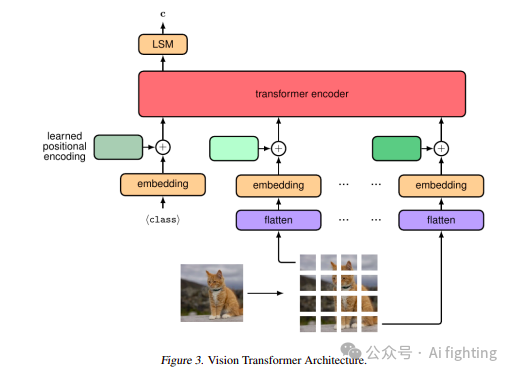
Transform架构是一项突破性创新,通过利用注意力机制进行序列处理,标志着从传统循环层的转变。它由两个主要部分组成:编码器和解码器。编码器通过多头注意力和前馈网络处理输入嵌入,两者都通过层规范化和残差连接得到增强。解码器结构与编码器相似,也聚焦于编码器输出,生成最终的输出序列。位置编码在此架构中至关重要,因为它们使模型能够识别序列顺序,这一关键特性是Transform本身无法辨别词序的。此功能
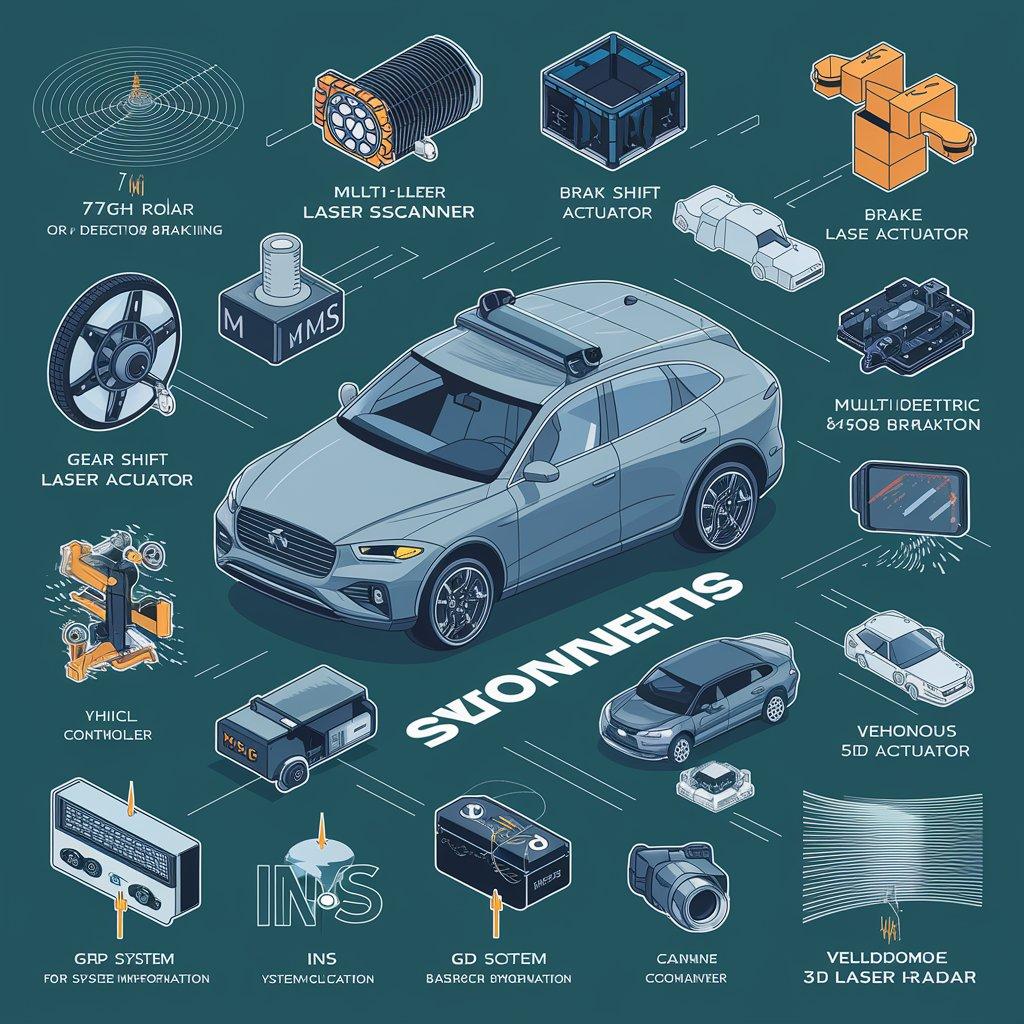
自动驾驶技术是一项复杂的系统工程,涵盖了众多技术领域。本文将从硬件和软件两个方面,详细介绍自动驾驶汽车涉及的关键技术,希望能为您提供有益的参考。自动驾驶技术的现状是正在快速发展中,而未来展望显示了一个更加智能、安全和高效的交通系统的可能性。随着技术的不断进步和相关问题的解决,自动驾驶车辆有望在未来几十年内成为我们日常生活的一部分。关注我的公众号auto_driver_ai(Ai fighting)
在机器学习和深度学习领域,迁移学习是一种强大的技术,它允许我们将在大型数据集上训练好的模型应用于新的任务或数据集。在本文中,我们将探讨如何使用PyTorch框架和迁移学习技术来实现自行车的分类识别。通过使用PyTorch进行迁移学习,我们可以有效地利用预训练的CNN模型来实现单车的分类识别。这种方法不仅可以加速训练过程,还可以提高模型的准确率和泛化能力。希望本文能帮助你理解和应用迁移学习在单车分类
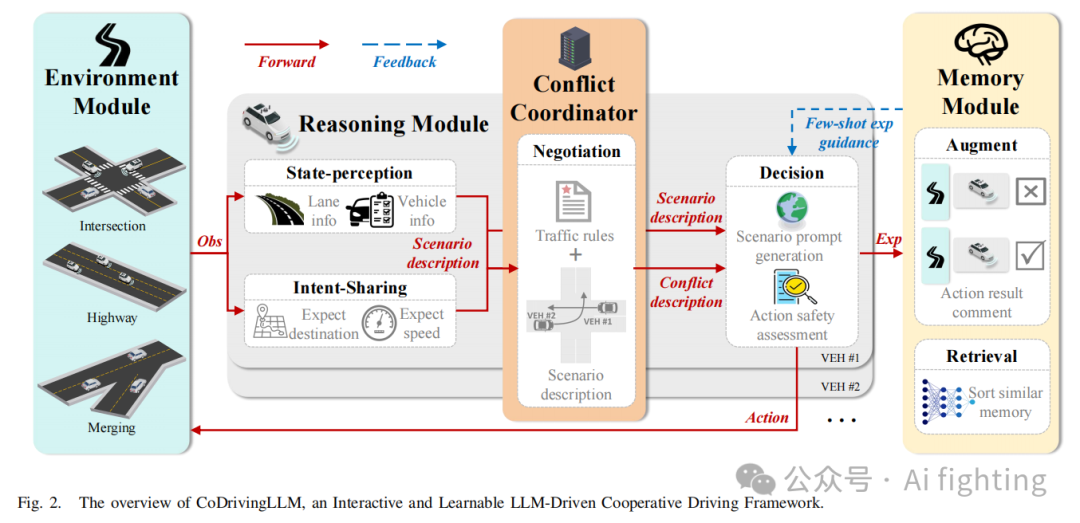
目前,全球范围内已开始对联网自动驾驶汽车(CAVs)进行道路测试,但它们在复杂场景中的安全性和效率表现仍不令人满意。合作驾驶利用CAVs的连接能力,通过协同作用超越个体表现,使其成为在复杂场景中提高CAV性能的有前途方法。然而,缺乏交互和持续学习能力限制了当前的合作驾驶仅能应用于单一场景和特定的合作驾驶自动化(CDA)。为了解决这些挑战,本文提出了一种交互式和可学习的基于大型语言模型(LLM)的合
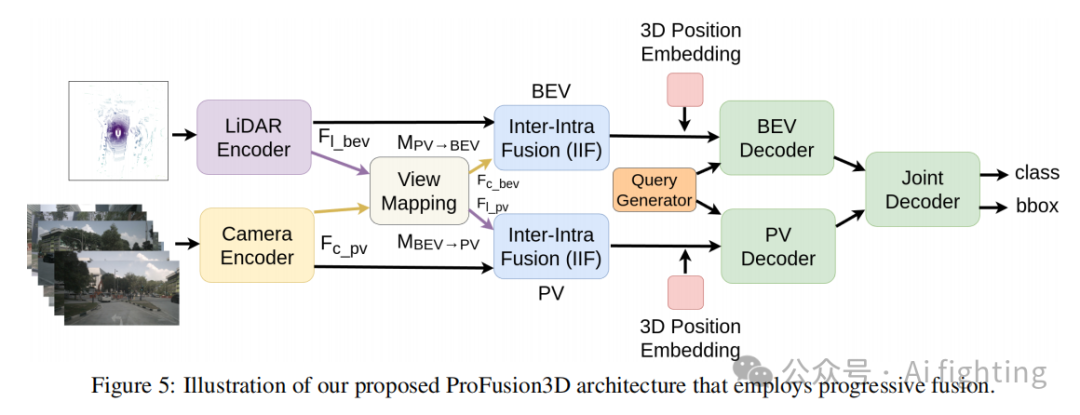
多传感器融合在自动驾驶中的3D目标检测中至关重要,摄像头和激光雷达是最常用的传感器。然而,现有方法通常通过将两种模态的特征投影到鸟瞰视角(BEV)或透视视角(PV)来进行单视角的传感器融合,从而牺牲了高度或几何比例等互补信息。为了解决这个问题,我们提出了ProFusion3D,一种渐进融合框架,它在中间特征和目标查询级别中同时结合了BEV和PV中的特征。我们的架构通过分层融合局部和全局特征,提高了
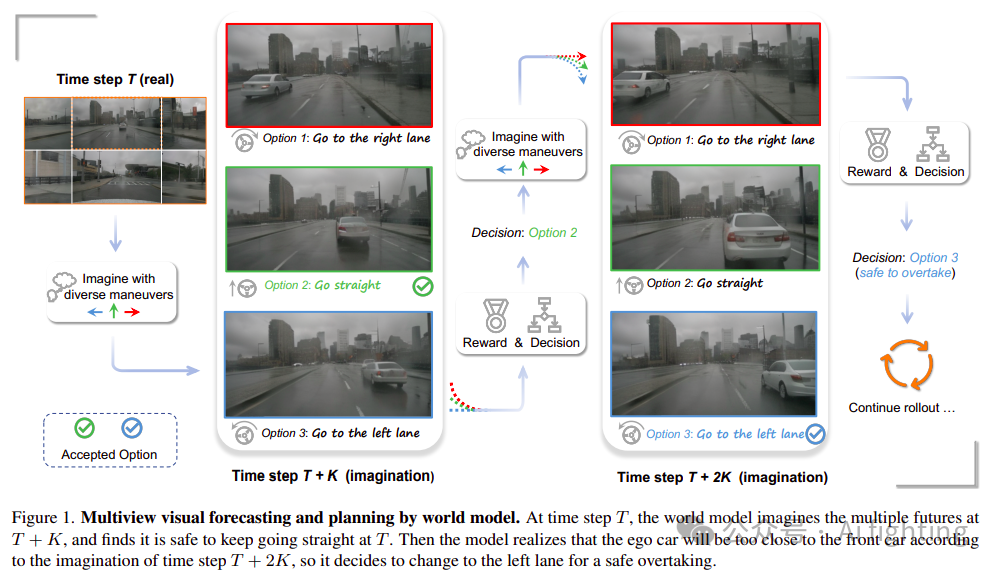
在自动驾驶中,提前预测未来事件和评估可预见的风险使得自动驾驶车辆能够更好地规划其行动,从而提高道路上的安全性和效率。为此,我们提出了Drive-WM,这是第一个兼容现有端到端规划模型的驾驶世界模型。通过视图分解实现的时空联合建模,我们的模型可以在驾驶场景中生成高保真度的多视图视频。基于其强大的生成能力,我们首次展示了将世界模型应用于安全驾驶规划的潜力。特别是,我们的Drive-WM能够基于不同的驾