- @qq_39523365


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
知识蒸馏概述知识蒸馏(Knowledge Distilling)是模型压缩的一种方法,是指利用已经训练的一个较复杂的Teacher模型,指导一个较轻量的Student模型训练,从而在减小模型大小和计算资源的同时,尽量保持原Teacher模型的准确率的方法。即用一个复杂网络(teacher network)学到的东西去辅助训练一个简单网络(student network)。背景引用知乎相关问题的回答
适用场景: AMP最适用于现代NVIDIA GPU(Volta架构及以后,如V100, T4, A100, H100等),因为这些GPU配备了Tensor Cores。对性能的影响: 对于绝大多数基于Transformer和卷积的现代模型,AMP对最终的模型精度影响极小,可以认为是“性能无损”的。它带来的训练加速和显存节省是巨大的工程收益,可以显著加快研究和迭代速度。代码实现: 必须同时使用aut
备注:docker中的/workspace目录映射到了域控设备上的/home/leador/autoware_deploy/autoware_project_humble目录。7、在docker环境下的命令行中执行source /workspace/install/setup.bash后再执行后续测试命令。3、将新增ros包通过filezilla拷贝到域控的/home/leador/目录下的自定义
1.前言本文要解析的模型叫做PointPillars,是2019年出自工业界的一篇Paper。该模型最主要的特点是检测速度和精度的平衡。该模型的平均检测速度达到了62Hz,最快速度达到了105Hz,确实遥遥领先了其他的模型。这里我们引入CIA-SSD模型中的精度-速度图,具体对比如下所示可以看出,截止CIA-SSD论文发表前,PointPillars的检测速度都是遥遥领先的,而且精度也不低。现有的
解决办法1,先确定是否更换了下载源(比如:apt-get源、pip源、conda源等)2,以conda举例:pytorch官网查看pytorch安装命令conda install pytorch torchvision torchaudio cpuonly -c pytorch最后的-c代表的是channels 从pytorch官网下载,导致速度慢 所以我们要从国内镜像源中寻找我们需要的pytor
1.本机和docker容器共享文件夹1、在本机中某个文件下建立一个文件夹mkdir -p /Users/aaa/aaa/dockder_sharing2、利用docker run 创建一个带有共享文件夹的容器docker run -it -v /Users/aaa/aaa/dockder_sharing:/home/docker_sharing--name development ca2056b7
1.本机和docker容器共享文件夹1、在本机中某个文件下建立一个文件夹mkdir -p /Users/aaa/aaa/dockder_sharing2、利用docker run 创建一个带有共享文件夹的容器docker run -it -v /Users/aaa/aaa/dockder_sharing:/home/docker_sharing--name development ca2056b7
torchrun 是 PyTorch 官方推荐的分布式训练启动器,它的作用是:启动多进程分布式训练(支持多 GPU,多节点)自动设置每个进程的环境变量协调节点之间建立通信。
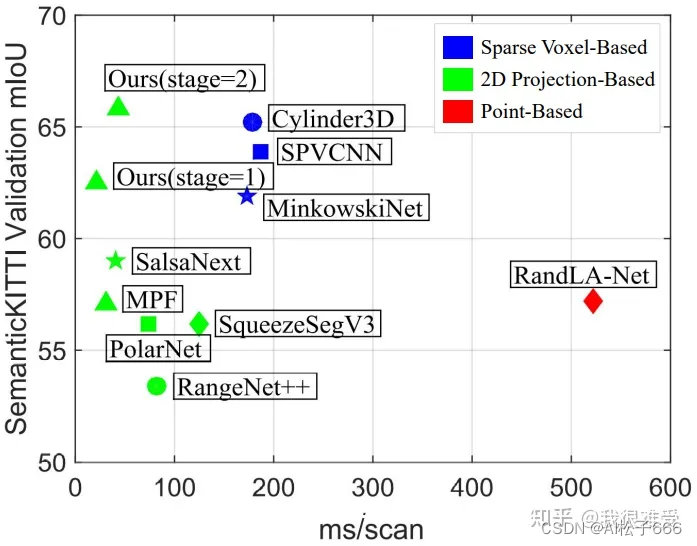
我们提出了一种多视图融合的方法,同时融合3D点云特征,BEV视图特征,RV视图特征的方法,来加速点云分割模型,同时降低了由2D投影带来的信息损失,达到了很好的精度-速度均衡。同时我们的方法做到了fully end-to-end,不需要任何后处理。我们的方法可以方便地部署在TensorRT上,来更快地部署在车载平台。目前我们的方法在Orin平台上可以做到13 ms。这是我们系列文章的第一篇,后续还有
github工程代码:https://github.com/edwardzhou130/PolarSeg。