登录社区云,与社区用户共同成长
邀请您加入社区
把传送带电机转速变量绑到直线移动构件上,看着那些小瓶子真的开始平移时,突然有种在玩高级版《工厂模拟器》的错觉。在设备组态里新建了个"灌装阀"对象,顺手绑定了流量计和压力传感器变量。调试时故意卡住流量计数据,看着报警窗像打地鼠一样弹出来,莫名解压。换算系数0.36是试出来的魔法数字——灌装阀从全闭到全开刚好转四分之一圈,和现实中的气动阀门动作神同步。饮料灌装模拟仿真生产线昆仑通泰嵌入版MCGS7.7
机器视觉框架源码vs2019可以直接编译应用于视觉检测AOI视觉检测机械手定位点胶插件激光切割视觉螺丝视觉贴合激光焊接机视觉裁板仅供学习使用,不提供技术,想所有功能都能用的出门右转此框架是标准化拖拽式编程,此框架不适合零基础者。
这个资源包整合了FastHan框架的small规格中文NLP模型全套运行依赖,包括已验证可用的model.bin权重、chars_vocab字符词表、bert_config.模型结构定义、label_vocab标签映射、vocab.txt分词专用词表,以及fasthan_base预训练基础模型。所有文件适配FastHan 1.x版本API,开箱即用,无需训练或微调,直接加载就能完成中文分词、词性标
在自然语言处理(NLP)领域,文本分类是情感分析的核心任务之一,而中文文本因缺乏天然分隔符,处理流程与英文差异显著。传统机器学习方法如朴素贝叶斯算法,凭借其在小样本场景下的稳定表现、极快的训练速度和良好的可解释性,成为许多实际项目的首选基线模型。结合中文分词工具jieba与TF-IDF特征工程,能够从微博评论等短文本中高效提取情感倾向,快速构建正面、中性、负面三分类器。该方案在舆情监控、用户反馈分
文本分类是自然语言处理的基础任务,通过机器学习方法将文本自动归入预定义类别。其核心流程涉及中文分词、特征向量化与分类模型训练,其中jieba分词与TF-IDF是构建传统机器学习模型的经典组合,Word2Vec则为词义表示提供更丰富的语义信息。文本分类技术广泛应用于新闻分类、垃圾邮件过滤、舆情分析等场景,能够显著提升信息处理效率。然而,一个能稳定运行的文本分类系统不仅需要模型精度,更需要完整的数据清
RNN(循环神经网络)作为经典序列建模方法,在短文本情感分析任务中仍具独特价值——尤其适用于中文影评这类平均长度40~60词、需低延迟高可解释性的场景。其核心原理在于通过时间步递归捕获上下文依赖,相比Transformer显著降低计算开销与部署门槛。技术价值体现在CPU端毫秒级推理、模型体积小于2MB、支持边缘设备及中小团队快速落地。典型应用场景包括票务平台实时打标、多模态系统文本支路基线、以及需
情感分析是自然语言处理中最经典的任务之一,其核心目标是从评论文本中自动识别情绪倾向。传统机器学习方法依赖人工特征工程,而深度学习模型能够端到端学习文本语义表示。LSTM作为循环神经网络的代表,凭借其门控机制有效缓解了长序列梯度消失问题,在中文情感分类任务中表现出色。实际工程项目中,从文本清洗、分词、词表构建到序列填充,每一步都直接影响模型精度;基于PyTorch搭建双向LSTM分类器,配合合适的损
文本分类是自然语言处理中的基础任务,通过特征工程与机器学习算法将文本自动归入预定义类别。在金融舆情场景下,中文文本分类面临分词、噪声清洗和类别不均衡等挑战。TF-IDF结合线性模型可作为高效基线,而预训练模型在数据充足时能进一步提升效果。这类技术广泛应用于新闻分类、情感分析和风险监测,尤其适合上市公司新闻的自动归类与信息分流。本文围绕毕业设计需求,详细拆解从语料采集、清洗分词到模型选型、评估报告的
文本分类是NLP的基础任务,通过中文分词、TF-IDF特征提取和机器学习算法,将新闻自动归类。其原理是利用词频和逆文档频率构建特征向量,再训练分类器。技术价值在于高效处理海量文本,应用于舆情监控、内容推荐等场景。本文以Python新闻分类源码为例,详解环境配置、数据准备、特征工程及模型训练,并融入jieba分词和TF-IDF等热词,帮助开发者快速落地文本分类系统。
情感分析是自然语言处理中的经典任务,旨在从文本中识别情感倾向,广泛应用于电商评论、舆情监控和电影评分等场景。朴素贝叶斯算法因其计算效率高、可解释性强,成为中文短文本情感分类的常用基线模型。但真正决定模型效果的关键并非算法本身,而是数据清洗、分词粒度、标注口径等预处理细节。本文以豆瓣Top250短评数据为例,演示了如何用jieba分词、CountVectorizer和Pipeline完整搭建一条从原
做离线典籍类应用时,内容建模往往先被讨论完:目录怎么分层、原文与白话怎么挂接、词条怎么互链。但用户真正高频的动作其实很朴素——只记得半句话,想找回它出现在哪里。这个动作靠目录完不成,得靠一条从关键词到原文位置的完整链路。本文以一款纯本地运行的鸿蒙知识库为例,记录实现侧的几处取舍。
我是做GEO优化的韦杰,从传统SEO做到AI搜索这块,前后端和搜索收录的逻辑都摸过。这篇围绕大模型回答里常走的RAG(检索增强生成)机制,讲GEO优化到底该怎么用代码落地:AI怎么把你的内容检索进答案,代码层面该做哪些事,我会给出可直接运行的脚本和示例。适合正在给企业做AI搜索优化、或者自己维护官网想做GEO的技术从业者。
本文主要介绍了语言模型的相关内容,并介绍了如何应用n-gram模型来进行中文分词。
输出结果有所有节点的电压幅值概率分布(单个电压figure2-33,全部电压figure111),负荷概率分布,网损概率分布,以及电压越限概率(Pv_offlimits_max),最大越限概率的节点。输出结果有所有节点的电压幅值概率分布(单个电压figure2-33,全部电压figure111),负荷概率分布,网损概率分布,以及电压越限概率(Pv_offlimits_max),最大越限概率的节点。
摘要:本文提供多款KIS云财务系列软件下载链接,包括迷你版V14.0、标准版V14.0、商贸版V9.0、专业版V16.0及旗舰版V7.0,均支持123云盘免登录不限速下载。如需其他版本点头像联系。
3月20日,中国科学院文献情报中心正式发布《2025年度期刊分区表》,这一科研界“风向标”的更新瞬间引发学术界高度关注!本次分区表覆盖SCIE(科学引文索引)、SSCI(社会科学引文索引)、A&HCI(艺术与人文引文索引)、ESCI(新兴资源引文索引)和OAJ(开放获取期刊)五大数据库,共纳入21个大类学科(含自然科学、社会科学、人文科学),期刊总量达21,772本!
文章介绍elasticsearch从下载安装到配置以及分词器类型区别,以及分词器配置,集成到spring boot项目的具体操作流程
'gbk' codec can't decode byte 0xac in position 400623: illegal multibyte sequenc解决办法
分词工具调研一、背景调研了两种分词工具:Ansj:https://github.com/NLPchina/ansj_segHanLP(https://github.com/hankcs/HanLP#7-极速词典分词)最终选择了HanLP二、Ansj利用DicAnalysis可以自定义词库:val forest = DicLibrary.get()if(forest ...
做内容运营的团队,私信量一上来就会遇到一个工程问题:怎么让消息在没人值守的时段也能得到合理响应,同时不变成刷屏机器人。本文从规则设计角度拆解一套私信自动回复的处理逻辑。
2026年被业内叫成"AI购物普及元年",赛道分化得比想象中快:有人把AI入口当成新一轮流量红利猛冲,有人站在旁边看热闹,还有人试了一圈发现钱没赚到,账也算不清。我是做GEO优化的韦杰,这些年经手过不少AI渠道的投放和内容布局,见过太多渠道起起落落。判断一个AI渠道能不能落地,听我一句:少看热度,先量两把尺子——能不能成交闭环,能不能数据归因。这两条不过关,用户量再大、话题再热,都是虚的。
生成式AI搜索正重塑品牌可见性,62%品牌未被主流AI答案提及。SGEOAI聚合系统作为SaaS智能运营平台,通过三级权限架构、六层数据流与八大功能模块,实现信源检测、内容生成、知识库沉淀、多渠道分发与效果复盘的全流程闭环,助力品牌在AI答案中“被看见、被推荐”。适合品牌方、服务商及区域合伙人构建AI时代可量化、可持续的GEO运营体系。
HackThisSite提供合法而安全的网络安全资源,在这里大家可以通过各类挑战题目测试自己的黑客技能,同时学习到更多与黑客及网络安全相关的知识。简而言之,这是学习黑客技术的最佳站点。Evil Zone是一个专门面向黑客群体的论坛。当然,其中也涉及科学、编程以及艺术等领域的内容。提供与数据库相关的建议、漏洞利用、工具、论文以及安全新闻。这里提供与黑客技术相关的各类课程、挑战题目与实现工具。这是一个
目录1 es相关介绍2 安装和启动3 es的基本概念4 es简单办的增删改查5 对于中文的分词1 es相关介绍1 搜索引擎elasticSearch6(和elasticSearch5的区别在于,root用户权限、一个库能否建立多个表)2 搜索引擎文本搜索(以空间换时间算法)于同类产品相比(...
部署单点es、部署kibana、安装IK分词器、扩展词典、停用词典
linux Centos7 安裝搭建elasticsearch7.6.2+kibana7.6.2即全文检索解决方案ELK中的E和K这是之间安装版,较简单,回头补上docker swarm集群先搭建教程一、安装elasticsearch1、安装包下载:elastic产品下载地址:https://www.elastic.co/cn/downloads/elasticsearc...
本文记录了linux下如何安装elasticsearch及分词器,以及如何通过『spring-data-elasticsearch』连接服务器,并进行索引、搜索。1、下载elasticsearch我这里下载的是『elasticsearch-2.2.0.tar.gz』,下载地址如下:https://www.elastic.co/downloads/elasticsearch
重启docker容器。
科学学与科学技术管理》文本分析技术最新进展总结盘点
可以在未使用到此功能的时候选择先关闭geoip库的更新,如果关闭后面会报错。elasticsearch默认是不支持跨域的,在末尾添加如下两行支持跨域。2.这时切换到es用户下,又会报各种权限不足,加上权限就OK了。打开并修改访问ip设置,不然只有本虚拟机才能访问,别的机器无法访问。指定版本主要是为了后面安装ik分词,因为ik要和ES保持相同版本。此错误大致含义就是不可以在root用户下启动ES。1
概览:本篇使用docker搭建ElasticSearch8的单机过程,仅作为测试练习使用,(elasticsearch8.12.0+kibana8.12.0 )
centos7安装elasticsearch7,kibana,ik分词器,linux安装es+kibana+ik分词器;centos安装kibana,centos安装ik分词器,centos如何安装elasticsearch
升级elasticsearch-analysis-hanlp,支持elasticsearch8.X和hanlp最新分词
ES 的默认分词器(standard)不支持中文分词,满足不了平时的需求,所以需要用能够支持中文分词的 IK 分词器。而且 IK 分词器也是支持英文分词的。本文介绍下IK分词器的安装、基本使用方法;专有名词、同义词的使用;英文驼峰分词的实现。下载与安装中文IK分词器下载地址:https://github.com/medcl/elasticsearch-analysis-ik/releases选择一
elasticsearch系统学习笔记5-中文分词器IKhttps://github.com/medcl/elasticsearch-analysis-ikAnalyzer: ik_smart , ik_max_wordTokenizer: ik_smart , ik_max_word下载下载地址 https://github.com/medcl/elasticsearch-analysis-ik
最短路径分词中文分词有很多方法,比如N-最短路径法,N元语言模型,CRF模型等等。大致可以分为两类:一是机械化的分词,二是用机器学习方法分词。最短路径算法可以划分到第一种。这个算法效果并不是最好的,大体和IK分词打成平手。今天用最简洁语言描述一下:这个算法主要分两步:第一,构造DAG(有向无环图),第二找出最优路径。以下图为例 "有意见分歧”进行...
Elasticsearch目录概述索引(Index)类型(Type)文档(Document)倒排索引(Inverted Index)节点(Node)安装启动DSL(查询语句)官方文档查询语句的结构创建索引查询所有索引删除索引查看索引的mapping和setting查询所有索引中数据查询权重(boost)复合查询示例(boo...
本文介绍了自然语言处理中词向量转换的核心技术及其应用。jieba库、朴素贝叶斯算法和TF-IDF等技术在文本处理各阶段发挥关键作用。重点讲解了基于统计的词向量转换方法,通过CountVectorizer实现文本到数值向量的转换,并演示了从中文分词、停用词处理到特征提取的全流程。最后以手机评论情感分析为例,展示了从数据预处理、模型训练到实际预测的完整实现,包括朴素贝叶斯分类器的应用和性能评估。该技术
对话管理模块主要由状态追踪模块和动作生成模块两部分构成。
文本数据分析中的中文词性标注
先判断分词器支持,不支持要降级中文用 ICU 分词器是中文检索的关键FTS 表是虚拟表:用创建用 MATCH 查询:比 LIKE 快几个数量级双表结构:普通表存完整数据,FTS 表存检索字段,JOIN 关联参数化绑定:MATCH 查询也要用?占位防注入。
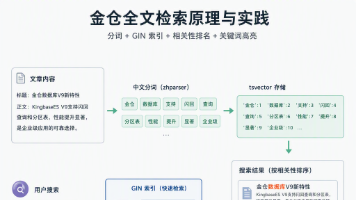
关系型数据库除了普通表,还支持 FTS(Full-Text Search)虚拟表,专门做全文检索。普通表用 LIKE ‘%关键词%’ 查询,数据量一大就慢得没法用;FTS 建了倒排索引,检索速度是数量级的提升。下面用一个"聊天记录搜索"的完整案例,讲清楚 FTS 虚拟表创建、中文分词器配置、关键词检索的全流程。
本文介绍了在KingbaseES数据库中实现高效中文全文检索的完整方案。首先分析了LIKE查询在百万级数据量下的性能瓶颈,随后详细讲解了基于PostgreSQL的tsvector/tsquery全文检索体系,重点解决中文分词问题。通过zhparser分词插件配置中文文本搜索,演示了基本搜索逻辑与GIN索引优化,使查询性能从秒级提升至毫秒级。文章还深入介绍了相关性排序(ts_rank)和关键词高亮(
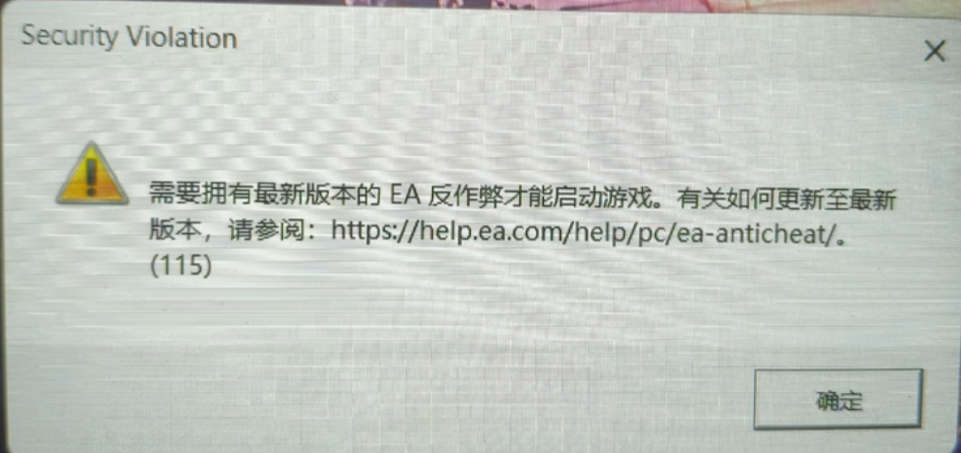
《战地5启动报错解决方案分享》针对游戏启动时提示"需要安装最新EA反作弊"的问题,本文提供详细解决方法:1)从EA官网下载EAJavelin反作弊安装程序;2)删除原C盘反作弊文件夹内容;3)将新程序复制到该文件夹并依次执行卸载、安装、更新操作。需注意该方法为临时方案,重启后可能需重复操作。文中附带官方链接并说明加速器不影响启动但可能影响游戏体验,欢迎读者分享更优解决方案。
2.在搜索框输入input,找到windows输入体验。3.右键点击windows输入体验,点击结束任务。4.等待输入法自动重启,选字框就出现啦!1.在电脑任务栏右键,打开任务管理器。
【摘自百度百科】Elasticsearch 是一个分布式、高扩展、高实时的搜索与数据分析引擎。它能很方便的使大量数据具有搜索、分析和探索的能力。充分利用Elasticsearch的水平伸缩性,能使数据在生产环境变得更有价值。Elasticsearch 的实现原理主要分为以下几个步骤,首先用户将数据提交到Elasticsearch 数据库中,再通过分词控制器去将对应的语句分词,将其权重和分词结果一并
中文分词
——中文分词
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区


 人工智能6S服务平台

 北京朝阳AI社区


 乐奇 Rokid 开放社区



 DAMO开发者矩阵
 快递鸟社区
 AtomGit AI 社区


 天工造物局









 HarmonyOS开发者社区

 AtomGit开源社区