登录社区云,与社区用户共同成长
邀请您加入社区
摘要 Selenium和BeautifulSoup是Python中两大重要的Web抓取工具,分别擅长处理动态网页和解析静态HTML。结合使用二者可以显著提升数据采集效率:Selenium模拟浏览器行为获取动态内容,BeautifulSoup解析提取结构化数据。本文介绍了安装配置方法、基本使用流程(Selenium加载页面+BeautifulSoup解析)、实用技巧(模拟交互、等待加载、滚动页面、处
它可以自动帮你识别当前运行环境下系统信息以及对应浏览器信息,并自动下载对应的webdriver,再也不用担心webdriver版本问题!!!
以document.body.scrollHeight为参数来判断是否翻到了底面(因为在没翻到底面时,该参数会不断变化)。每执行一次翻页操作就会提取一次文本,用一个集合来筛出重复性的,最终写入txt文档。思路就是:执行javascript代码实现向下翻的操作以克服动态加载的页面,
用selenium模拟搜索爬取酷狗试听歌曲及歌词
用playwright结合多线程爬取头条图片
该短视频智能推荐的开发和设计根据用户的实际情况出发,对系统的需求进行了详细的分析,然后进行系统的整体设计,最后通过测试使得系统设计的更加完整,可以实现系统中所有的功能,在开始编写论文之前亲自到图书馆借阅 Dango框架书籍,MYSQL数据库书籍等编程书籍,然后针对开发的短视频智能推荐,去网上查找了很多别人做好的系统,参照他们的设计结果,来对自己的系统进行更加详细的系统的设计,将系统中所有的功能结果
Beautiful Soup提供⼀些简单的、python式的函数⽤来处理导航、搜索、修改分析树等功能。它是⼀个⼯具箱,通过解析⽂档为⽤户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出⼀个完整的应⽤程序。Beautiful Soup⾃动将输⼊⽂档转换为Unicode编码,输出⽂档转换为utf-8编码。你不需要考虑编码⽅式,除⾮⽂档没有指定⼀个编码⽅式,这时,Beautiful Soup就
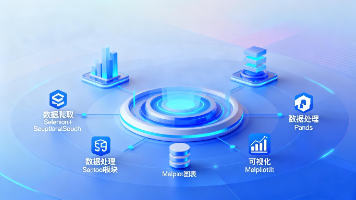
本文介绍了一个电商商品数据分析工具的开发实践,可自动从TaoBao、JingDong、PinDuoDuo三个平台爬取商品价格和销量数据。项目采用Selenium+BeautifulSoup处理动态页面爬取,Pandas进行数据处理,Matplotlib生成可视化图表,MySQL实现数据存储。核心功能包括多平台数据爬取、价格销量对比分析、数据持久化存储等。
习惯上来说HyperSnap是一个老牌优秀的屏幕截图工具,最新界面,不仅能抓取标准桌面软件,还能够抓取 DirectX, 3Dfx Glide的 GAME视频或 DVD 屏幕图,能以 20 多种图形格式(包括:BMP, GIF,JPEG, TIFF, 个人电脑X等)保存并阅读图形,能够用快捷键或自动定时器从屏幕上抓图,它的功能还包括:在所抓取的图片中显示鼠标轨迹,收集工具,编辑图形(加特效,调颜色
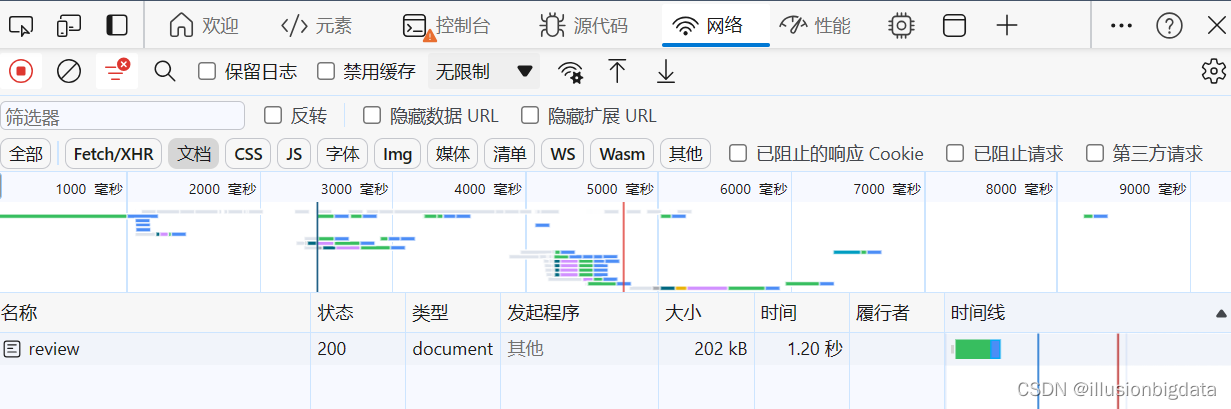
环境搭建其实就三步:装库、学看F12、写第一行爬虫代码。本篇带你安装requests/bs4/lxml等核心库,手把手教你用浏览器F12分析网络请求和页面结构——这是爬虫最重要的技能,没有之一。然后写出第一个爬虫:抓取公开页面标题和正文。最后搞懂GET和POST的区别,知道什么时候该用哪个。
本文整理了13个Web抓取和浏览器自动化开源工具,涵盖通用爬虫框架、AI驱动爬虫、社交媒体采集、安全扫描等方向。重点介绍了Crawlee(Node.js生产级爬虫框架)、ScrapeGraphAI(LLM驱动的智能爬虫)和MediaCrawler(多平台社媒采集工具)等项目,通过表格对比各工具的技术路线和适用场景,为不同需求的网页数据采集任务提供技术选型参考。
古诗文是中华传统文化的瑰宝,为了方便随时品读、复习背诵,本文使用 Python + requests + BeautifulS4 实现一个简单爬虫,批量爬取古诗文网《唐诗三百首》,按体裁分类保存为 TXT 文件,包含古诗原文 + 译文,实现真正离线阅读。⚠️重要声明本文仅用于编程技术学习与交流,所有爬取内容版权归原网站所有。请勿用于商业用途、批量下载传播或恶意访问服务器,遵守网站 robots 协
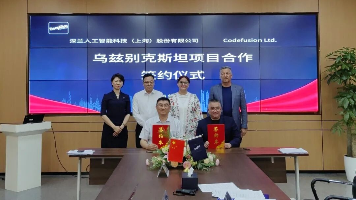
深兰科技与乌兹别克斯坦签署智慧城市合作协议,将参与新塔什干新城四大核心项目建设,包括智慧城市大脑、智慧住宅、国际物流及智能环卫系统,项目总标的达20亿美元。深兰科技作为中方AI技术提供方和总集成商,将部署智能交通、安防体系、全屋智能等解决方案。此次合作标志着深兰科技在中亚市场的拓展进入实质性阶段,未来还将与伊拉克、巴西等国际伙伴深化合作,推动中国AI技术全球化落地。
1、搜索引擎:百度,谷歌,企业内部的知识库,某些项目专项数据爬取,专业的数据爬取2、互联网:公网(不需要授权的情况就可以浏览的内容,搜索引擎的重点),深网(需要授权才能使用的内容),暗网(非正式渠道,无法使用常规手段访问)3、爬取互联网的公开信息,但是正常情况下,也需要遵守一个规则:robots协议。Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功
链家房源列表页与详情页的核心数据(如价格、面积、户型)通过 AJAX 异步加载,静态请求(如 requests.get)只能获取空壳 HTML。Selenium 通过驱动真实浏览器,等待页面完全渲染后获取完整 DOM 结构,再交由 BeautifulSoup 解析提取目标数据,实现动态数据的抓取。:自动化测试工具,可模拟浏览器行为加载动态页面,解决 JavaScript 渲染的数据获取问题,本文使
摘要: 本文对比Python爬虫中常用的BeautifulSoup和XPath两款数据解析工具,从核心特性、学习成本、解析速度等维度分析适用场景。BeautifulSoup语法直观、容错性强,适合新手处理不规范HTML或简单元素提取;XPath解析高效、路径定位精准,适用于复杂结构或大数据量网页。建议新手优先掌握BeautifulSoup建立基础,再逐步学习XPath应对高阶需求,二者实际开发中可
文章摘要: "宝藏代码胶囊"CodeCapsule正式上线!✨专为解决编程难题而生,提供低价定制化代码方案,涵盖毕设/课设/算法优化/项目开发等场景。结合Python爬虫开发实战教程,详解Web爬虫原理与应用(搜索引擎/数据分析等),并展示基于Requests和BeautifulSoup的爬虫实现。附完整环境配置指南,帮助开发者快速搭建爬虫项目,低成本高效解决实际问题。👉访问
XPath和BeautifulSoup是Python爬虫的两大HTML/XML解析工具,各有特点:XPath语法精确(如路径表达式),性能高(基于lxml库),适合复杂结构提取;BeautifulSoup提供Python风格API,容错性强,开发更直观。实际项目中可混合使用,先用BeautifulSoup预处理脏HTML,再转XPath精准提取。性能要求高选XPath+lxml,快速开发选Beau
本文系统讲解Python爬虫开发全流程,从基础语法到项目实战。首先介绍Python环境搭建和基础语法,包括变量、循环、函数等核心概念。其次解析HTTP协议和请求方法,演示如何通过urllib发送请求。重点讲解requests和BeautifulSoup库实现静态网页爬取与数据解析,并展示豆瓣图书TOP250的实战案例。进阶部分涵盖动态网页处理(API接口分析和Selenium模拟浏览器)及反爬策略
BeautifulSoup 是一个用于解析 HTML 和 XML 文档的 Python 库,提供了简单灵活的 API 用于遍历、搜索和修改文档树
基于requests与ThreadPoolExecutor开发了一个论文爬虫系统
本文介绍了Python爬虫的两个核心库Requests和Beautiful Soup的基本用法
爬虫学习案例,获取济南二手房数据保姆级教程!
BeautifulSoup 是一个非常强大的 Python 库,用于解析 HTML 和 XML 文档。它可以帮助你轻松地从网页中提取数据。下面将详细介绍如何安装和使用 BeautifulSoup。如果你在 PyCharm 中工作,可以通过 PyCharm 的包管理器来安装这些库。如果还有其他问题或需要进一步的帮助,请告诉我。,它是 Python 自带的解析器。首先,确保你的环境中已经安装了 Pyt
BeautifulSoup 是一个用于从网页中提取数据的 Python 库,特别适用于解析 HTML 和 XML 文件。
一文带你从爬虫小白到大师!
使用BeautifSoup库实现爬虫提示:以下是本篇文章正文内容,下面案例可供参考综上所述,BeautifulSoup是一个功能强大且易于使用的Python库,它能够帮助开发者轻松地从复杂的HTML和XML文档中提取所需的数据并进行相应的修改。
从入门到精通python网络爬虫技术:涵盖解析HTML和DOM结构,包括使用Python的requests库发送GET和POST请求,设置Headers和管理Session,通过BeautifulSoup解析HTML提取数据。对于动态内容,Selenium或Playwright等工具模拟浏览器执行JavaScript和处理AJAX请求。Scrapy框架管理爬取流程,支持登录和Token验证,并通过
爬虫,全称是网络爬虫(Web Crawler),也称为网络蜘蛛,是一种自动化程序,用于抓取网页上的信息。这些信息可以包括网页的内容、结构或其他相关资源。爬虫通过模拟用户访问网站的行为,自动化地从互联网上抓取数据,并在后续阶段对这些数据进行存储和处理。爬虫广泛应用于搜索引擎索引、数据分析、电子商务价格监控、社交媒体数据采集等领域,是大数据和人工智能应用的重要组成部分。
输入示例:8.28 复制打开抖音,看看【𝘽𝙖𝙜𝙖酱的呦西的作品】鸣潮 | 【年度混剪】系列~ 耗时45时 仅此3分…https://v.douyin.com/iUhQHRNR/ 08/11 trR:/ E@u.Fh。注:不需要图形界面的可以只运行主功能函数,需要图形界面则两部分放于同一路径下,且需放上00.otf (字体文件)、background.png(界面背景图片)。(直接放入分享文
然后,使用可视化工具(如Matplotlib、Seaborn、Plotly等)对数据进行图表展示,展示书籍评分分布、评论情感分析、热门书籍趋势、用户偏好等内容,以便用户进行直观的决策支持。包括抓取豆瓣书籍页面中的书籍信息、评论数据、评分等,确保抓取过程高效、稳定,能够处理各种网页结构的变化,并对抓取的数据进行清洗和存储。通过这些研究内容的实施和目标的达成,可以开发出一个高效、稳定、功能全面的基于P
本项目通过爬虫获取历史天气数据,利用数据分析工具进行清洗和合并,为重庆气候趋势分析提供了可靠的数据支持。通过优化爬虫策略和代码结构,提高了爬取效率和稳定性。
在 Python 中,是一个常用的 HTML 和 XML 解析库。它允许我们轻松地定位和提取网页中的特定元素。通常我们会使用 CSS 选择器来查找元素,然而,XPath 也是一种非常强大的工具。虽然本身不支持 XPath,但我们可以借助lxml库来同时使用 XPath 和 CSS 选择器定位元素。本文将详细介绍如何在中使用 XPath 和 CSS 选择器定位 HTML 元素,并提供示例代码以帮助新
price = s.find_all('span',{'class':'content__list--item-price'})#价格。content = s.find_all('p',{'class':'content__list--item--des'})#地址。print('==========','当前是第{}页'.format(i))包括租房标题、标题链接,价格和地址。refere参数:
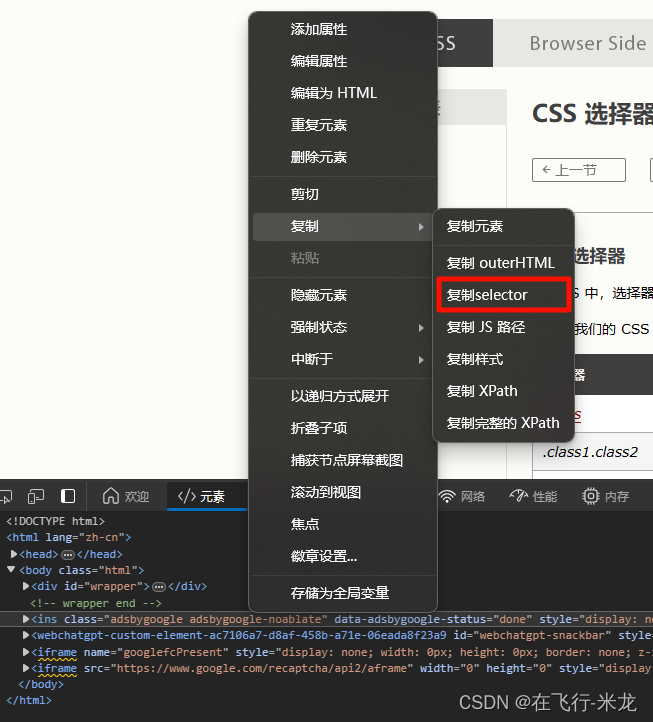
在很多的计算机编程语言中,如果不加空格不会输出内容,但是在bs4中,不会报错,能正常显示内容。所有这里div>ul>li,加不加空格都可以,但如果是在其他编程语言中使用子代选择器,需要加空格。可以通过.(点)代表class,.(点)后面跟上class的属性值xx,这样就可以查找到class属性为xx的所有a标签了,这种操作称为类选择器。可以通过#代表id,#后面跟上id的属性值xx,这样就可以查找
词云,即:对网络文本中出现频率较高的“关键词”予以视觉上的突出,形成“关键词云层”或“关键词渲染”,从而过滤掉大量的文本信息,使浏览网页者只要扫过一眼文本就可以领略文本的主旨。本项目用来爬取豆瓣网上最新的电影评论(以最新上映的:异形:夺命舰 Alien: Romulus为例),经过数据清理和词频统计后进行词云展示。
首先介绍BeautifulSoup的对象种类,常用的有标签(bs4.element.Tag)以及文本(bs4.element.NavigableString)等,其中,注解等对象不常用,在此不展开介绍。在标签对象上,可以调用一些查找方法例如find_all等,还有一些属性返回标签的父节点、兄弟节点、直接子节点、所有子节点等。所以如果要爬这样的网站,首先需要把请求伪装成浏览器的样子。具体网站具体分析
前言女朋友看了都能学会的爬虫教学自己断断续续学习练习了两三年python爬虫,从网上看了无数教程,跟大神们学习了各种神奇的操作,现在虽然没成为大神,但是想通过这篇教程来分享自己学习的爬虫实战案例。通过本教程,你将学会如何用Python爬虫从网络上爬取你想要的电影下载资源。本案例以00电影网为例进行爬取,当然你可以修改代码爬取你想要的任何内容。如果你是零基础,请从头阅读,如果你有些基础,可以选择部分
或者,使用BeautifulSoup解析(推荐)4.将获取到的豆瓣评分数据以词云的方式展示。2.使用正则表达式解析。
Python爬虫--scrapy+selenium框架】超详细的Python爬虫scrapy+selenium框架学习笔记(保姆级别的,非常详细)
提取招标标题,时间,公告类型,每一条招标信息的详细页面的url以及省份
最近在写关于评论数据主题建模和情感分析的作业,本来想用八爪鱼直接爬TapTap的评论数据,但是自动识别网页总是定位错误,还是回归BeautifulSoup和Request来进行评论内容的爬取,具体操作步骤如下。
BeautifulSoup的基本使用和使用案例
以百度关键词搜索为例,介绍了selenium和直接requests两种Python爬虫方式
🎈🎈作者主页:🎈🎈🎈🎈✨✨兄弟姐妹们,大家好哇!今天我们来学习python爬虫解析的最后一部分—BeautifulSoup的相关知识。
导入【3】解析器解析器使用方法特点自带html.parserBeautifulSoup(页面源码,‘html.parser’)简单易用:标准库的一部分,无需安装速度适中:性能不是最快的,但对于大所数常见任务足以功能基础:提供了基本的HTML解析功能,对复杂的HTML或错误会吃力第三方lxmlBeautifulSoup(页面源码,‘lxml’)性能优越:所有python HTML/XML解析器中性能
beautifulsoup
——beautifulsoup
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区

 天工造物局





 DAMO开发者矩阵