登录社区云,与社区用户共同成长
邀请您加入社区
谱聚类的本质是一种非线性降维技术。它利用谱分解将数据映射到低维空间,使原始非线性可分的数据在新空间中变得线性可分。
来自IEEE的文章:网络安全网络流量功能的模糊聚类。链接:安全|网络流量功能的模糊聚类IEEE 会议出版物|伊 · X普洛尔目录摘要第一节:introduction第二节:模糊C均值聚类法(FCM)2.1 网络流量数据集2.2 功能子集选择2.3 模糊C均值聚类2.4 使用模糊聚类进行入侵检测第三节:测试和结果总结摘要许多当前的入侵检测系统(IDS)无法识别未知或者变异的攻击模式,或无法在移动网络
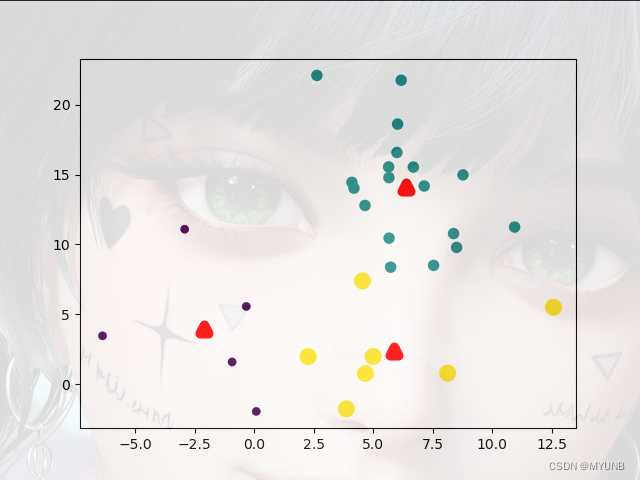
ClusterGAN前提知识AbstractMethod采样反向传播线性生成聚类损失函数experimentsConclusion前提知识Abstract简单来说,本论文研究基于GAN的无监督分类问题,GAN的潜变量保留数据信息,但是数据的分布往往是平滑的,比如上图©,这种情况对于无监督分类任务十分不友好,针对上述问题提出了ClusterGAN。贡献如下:利用一个混合的离散和连续潜变量(one-h
deep adversarial subspace clutering前提知识子空间聚类摘要introduction前提知识子空间聚类随着大数据时代的到来,产生了大量不一致数据、混合类型数据和部分值缺失的数据等。典型的聚类算法对这些数据集聚类时遇到难题。例如在高维稀疏数据中,簇类只存在部分属性构成的子空间中,这些数据集从全维空间来讲根本不存在簇类。一般来说,样本之间的差异往往是由若干个关键的特征所
最近在做短视频推荐,和别的部门配合着做,我们部门做用户画像这一部分。回头看看,我们部门以前做的用户画像只能称之为“所谓的用户画像”。如果一个人不懂用户画像还好指挥来指挥去真的让人无言,不知道其他公司的有没有这样的人儿那,哈哈,扯远了,言归正传。这篇文章只是对文献[1]的一个总结与实践,像我这种才学浅显的人只能照猫画虎了。1、标签&标签问题用户可以对物品打标签,这些标签存在:(1)标签冗余
先来看下错误前端错误两层聚类时,外面一层返回的key是乱码,这个乱码并不是编码问题,而是根本没有对第二层的聚类分类。第一层里面的数据全部都是一样的。直接报错,500或者503,类型转换错误或者解析异常。后台错误:[2015-11-30 11:06:56,105][DEBUG][action.search.type] [local] failed to reduce search
在数据分析领域,聚类分析作为一种无监督学习方法,旨在将数据集中具有相似性的样本划分到同一类别中。其中,基于图论的聚类算法凭借其对非参数数据分布的良好适应性,成为处理复杂数据集的重要手段。这种方法通过将数据样本转化为图的节点,利用图的拓扑结构和性质实现聚类,无需预先假设数据的分布形式,具有极强的灵活性。一、图论聚类算法的核心思想图论聚类算法的核心在于构建数据的相似度图,并基于图的连通性或切割准则划分
推荐系统之聚类算法
一、引言:WSN 的 “能量焦虑” 与聚类技术的破局之道1.1 无线传感器网络的应用困境无线传感器网络(WSN)作为物联网的核心感知层,已广泛应用于环境监测、农业物联网、工业监控等场景 —— 小到农田土壤湿度采集,大到森林火灾预警,都依赖海量传感器节点的协同工作。但这些节点通常采用电池供电,部署后难以更换或充电,能量耗尽即意味着网络失效,成为制约 WSN 规模化应用的核心瓶颈。1.2 聚类:WSN
本文采用Billingsmoore提供的文本聚类示例数据集,该数据集包含925个英语句子,每个句子都标注了相应的主题类别。登录后复制1.2.3.4.5.6.7.登录后复制1.该数据集呈现良好的平衡性分布,几乎所有类别都包含约90个句子样本。虽然还存在其他聚类算法如BIRCH、Affinity Propagation等,但这些算法在数据集规模、嵌入向量维度和计算成本方面存在显著局限性,因此实用价值有
这篇文章将介绍一种基于动态规划和K聚类的彩色图像的压缩算法~
1.背景介绍聚类算法是一种无监督学习方法,主要用于对数据进行分类和分析。在现实生活中,聚类算法应用非常广泛,例如推荐系统、用户行为分析、图像处理等领域。本文将从聚类算法的实际应用角度进行探讨,主要包括以下几个方面:1.背景介绍2.核心概念与联系3.核心算法原理和具体操作步骤以及数学模型公式详细讲解4.具体代码实例和详细解释说明5.未来发展趋势与挑战6.附录常见问题与解答1.背...
1.背景介绍随着数据量的不断增加,数据挖掘和机器学习技术变得越来越重要。支持向量机(Support Vector Machines,SVM)和聚类算法(Clustering Algorithms)是两种常用的数据挖掘和机器学习方法。支持向量机是一种超参数学习算法,它通过在高维空间中寻找最优分类超平面来解决分类和回归问题。聚类算法则是一种无监督学习算法,它通过寻找数据集中的簇来解决数据分类和聚类..
论文地址代码地址本文提出了一种基于图神经网络的重叠社区检测模型。Neural Overlapping Community Detection(NOCD) model.可以看做BigCLAM的升级版。核心思想:将GNN的强大能力与伯努利-泊松概率(Bernoulli–Poisson)模型结合起来。Bernoulli–Poisson modelBernoulli-Poisson (BP)模型是一种考虑
LDAclass pyspark.ml.clustering.LDA(featuresCol=‘features’, maxIter=20, seed=None, checkpointInterval=10, k=10, optimizer=‘online’, learningOffset=1024.0, learningDecay=0.51, subsamplingRate=0.05, opti
社会网络分析——三、图算法中间被很多人转了,我是从机器之心公众号(almosthuman2014)看到的,最初来源应该是 Maël Fabien 大佬的博客,致谢https://github.com/maelfabien/Machine_Learning_Tutorials目录:第一部分:图介绍图是什么?如何存储图?图的类型和性质Python 示例第二部分:图算法Pathfinding(寻路)Co
Movielens数据集+Canopy聚类+Kmeans聚类+协同过滤推荐+测评指标MAE实现一、实现原理和步骤1、使用movielens数据集(943个用户,1682部电影,80000条评分数据);2、输入用户id(1-943);3、创建用户-电影评分矩阵;4、canopy聚类算法根据用户评分对用户聚类;5、将canopy聚类结果作为kmeans聚类初始点,进行kmeans聚类;6、根据聚类结果
paper:paper补充材料:supp一篇cvpr深度聚类文章简介浅层模型难以捕捉非线性特征,并且应用到大数据及上有困难。深度学习方法则容易产生过拟合。本文提出方法ClusterGAN,解决问题。利用GAN解决聚类问题,同时对self-paced进行改进成balanced self-paced方法。模型分为三个部分,一个生成器G,一个判别器D和一个聚类器C。聚类器负责对xxx提取特征并...
本篇文章只讲可用的hadoop实现算法的源码,可直接拷贝用于工程中!/*** 质点特征模型,可根据自己的业务需求进行修改** @author jianting.zhao*/public class ParticleModel {//特征xpublic double x;//特征ypublic double y;public
本文深入剖析了一个基于 Faiss + MongoDB + Tornado 构建的百万级人脸特征向量检索系统,涵盖特征归一化、余弦相似度近似计算、分段分数映射、HNSW 分片索引、索引持久化与增量恢复、Canopy 在线聚类归档等核心技术细节。同时从 Faiss 单机内存库的局限性出发,对比了 Milvus、Pinecone、Weaviate、Qdrant 等现代向量数据库,给出了生产环境下的选型
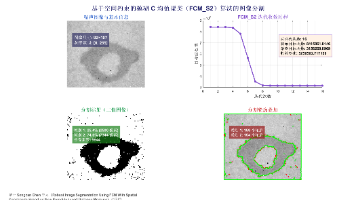
2004-基于空间约束的模糊 C 均值聚类(FCM_S2)算法的图像分割
基于改进K-means聚类与残差网络的白细胞检测与分类算法,运用了深度学习技术中的YOLO目标检测算法结合注意力机制(CBAM)和残差网络(ResNet)解决了白细胞检测定位不准确和分类识别精度低的问题,实现了从外周血图片中自动检测、分割和识别五类白细胞的功能。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心
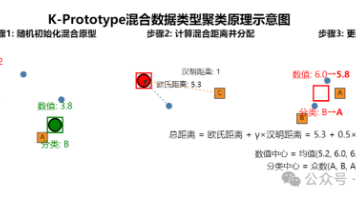
你是否还在为混合数据的聚类问题头疼?一边是数值型数据(如年龄、收入),一边是分类型数据(如职业、学历),用K-Means聚类分类型数据总出错,用K-Mode聚类数值型数据又不准?别愁!今天要给大家介绍的k-prototype聚类模型,就是解决混合数据聚“类的“一把好手”,既能处理数值型数据,又能搞定分类型数据,让聚类不再受数据类型的限制!
假设你是一家电子商务公司的数据分析师,公司希望根据客户的购买行为数据进行客户细分,以便制定更有针对性的营销策略。你需要使用K-means聚类算法对客户进行分组,并使用轮廓系数确定最佳K值。
智能优化算法
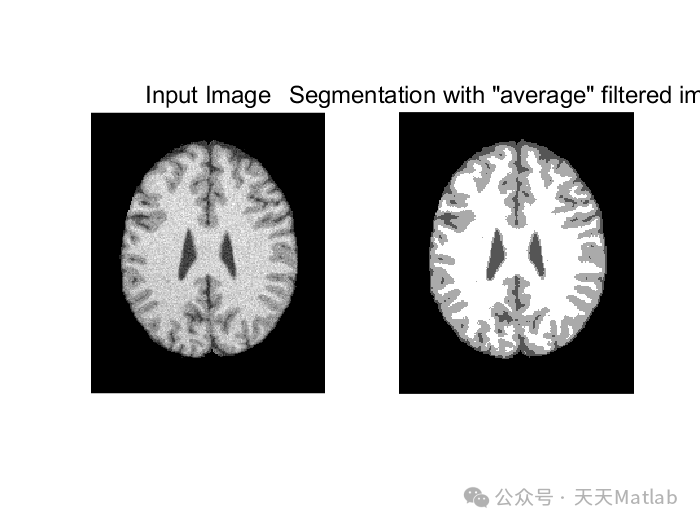
本论文针对磁共振图像(MRI)脑组织分割中存在的噪声干扰、灰度不均匀等问题,提出基于自适应正则化核函数模糊 C 均值聚类(ARKFCM)的分割方法。通过引入自适应正则化核函数对传统模糊 C 均值聚类(FCM)算法进行改进,有效增强算法对图像噪声和灰度不均匀性的鲁棒性,实现对脑组织的精准分割。详细阐述 ARKFCM 算法原理、模型构建及参数优化过程,并利用临床 MRI 数据进行实验。
以下是基于 MATLAB 的 K-means 聚类算法实现图像分割的完整代码。K-means 是一种常用的无监督学习算法,用于将图像像素分组到不同的聚类中,从而实现图像分割。通过上述方法,您可以快速实现基于 K-means 聚类算法的图像分割,并结合 GUI 界面实现良好的用户体验!k-means聚类算法的图像分割-matlab实现。
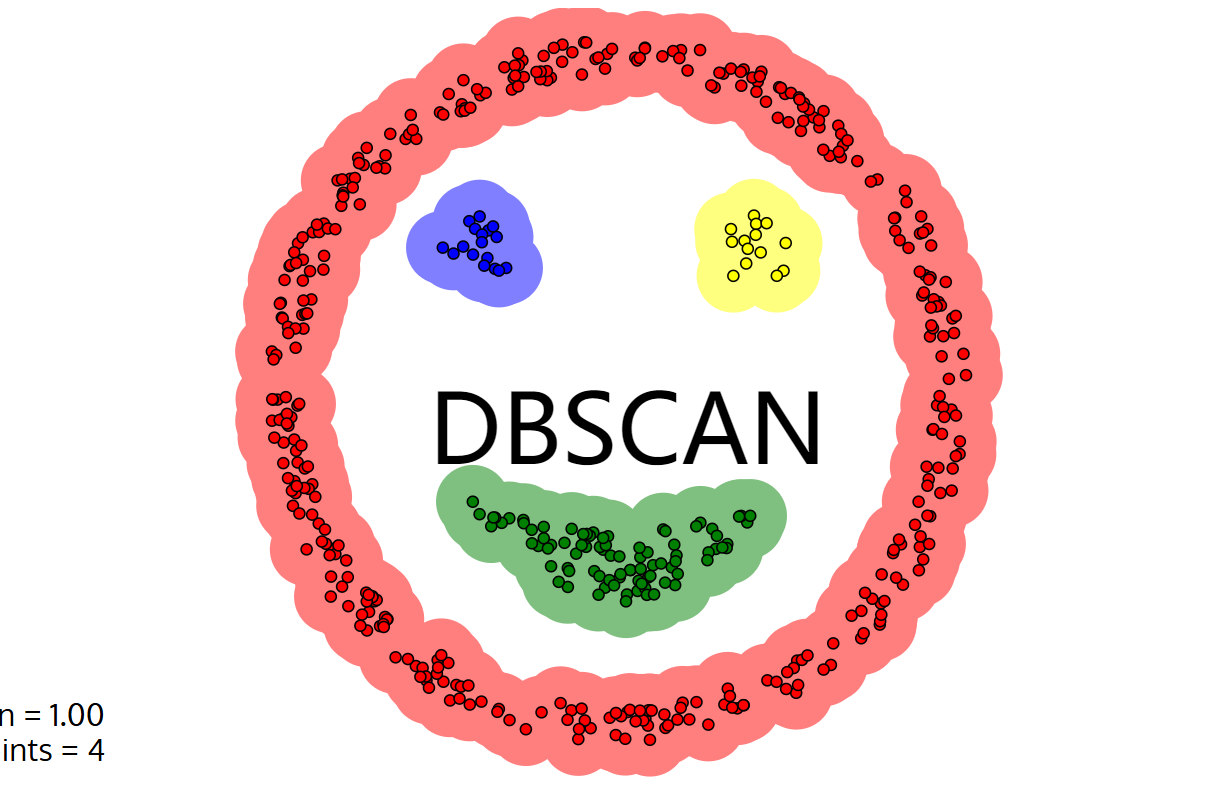
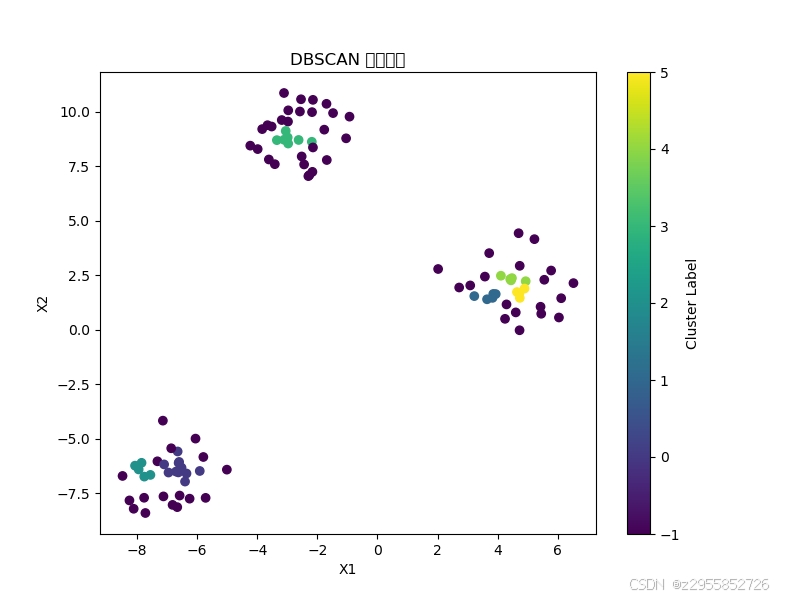
DBSCAN(Density-Based Spatial Clustering of Applications with Noise)是基于密度的带噪声的空间聚类应用算法,它是将簇定义为密度相连的点的最大集合,能够把具有足够高密度的区域 划分为簇,并在噪声的空间数据集中发现任意形状的聚类。epsDBSCAN算法参数,即我们的ϵϵ-邻域的距离阈值,和样本距离超过ϵϵ的样本点不在ϵϵ-邻域内。默认值是
1 什么是DBSCAN?DBSCAN(Density-Based Spatial Clustering of Applications with Noise)是一种基于密度的聚类算法。与 K-Means 不同,DBSCAN 不要求用户预先指定聚类的数量,它通过密度来定义聚类的边界。具体来说,DBSCAN 尝试找到密度较高的区域,并将这些区域归为同一类,密度较低的区域则被标记为噪声。DBSCAN 的
摘要: 磁共振成像(MRI)技术在脑组织疾病诊断中发挥着至关重要的作用,而准确地分割脑组织是后续诊断和治疗的关键步骤。本文提出了一种基于自适应正则化核函数模糊C均值聚类(ARKFCM)算法的脑组织分割方法。该方法利用自适应正则化核函数有效地解决了传统模糊C均值聚类(FCM)算法在处理高维数据和噪声数据时易出现局部最优解以及分割精度不高的问题。通过在核函数中引入自适应正则化项,ARKFCM算法能够更
ARIMA的主要目标是通过建模时间序列的趋势、周期性和随机波动来进行预测,尤其适合处理非平稳的时间序列数据。SARIMA在ARIMA模型的基础上,增加了季节性自回归、季节性差分和季节性滑动平均成分,用来处理数据中的周期性波动。在处理时间序列数据时,传统的统计方法如ARIMA和SARIMA虽然有效,但它们对数据的线性假设限制了它们在更复杂的非线性数据中的表现。长短期记忆网络(LSTM)是一种特殊的递
机器学习是人工智能的一个分支,它使计算机能够在不进行显式编程的情况下从数据中学习。简而言之,机器学习的目标是从数据中自动改进算法的行为。定义模型f(x)): 选择一个能够描述输入与输出之间关系的函数形式。定义损失函数): 设定一个度量标准来评估模型预测的准确性。优化参数: 使用优化算法调整模型参数,使得损失函数最小化。验证和测试: 在未见过的数据上验证模型性能,确保其具有良好的泛化能力。机器学习算
【代码】MATLAB数学建模——谱聚类。
水波优化算法(Water Wave Optimization, WWO)是一种新兴的群智能优化算法,灵感来自水波在自然环境中的传播和衰减现象。该算法模拟了水波在水面上传播和碰撞的行为,通过这些行为来寻找问题的最优解。WWO算法由三种主要的操作组成:波浪传播、波浪碰撞和波浪衰减。
Scikit-Learn工具包提供了多种聚类算法,涵盖了不同的聚类方法和应用场景。
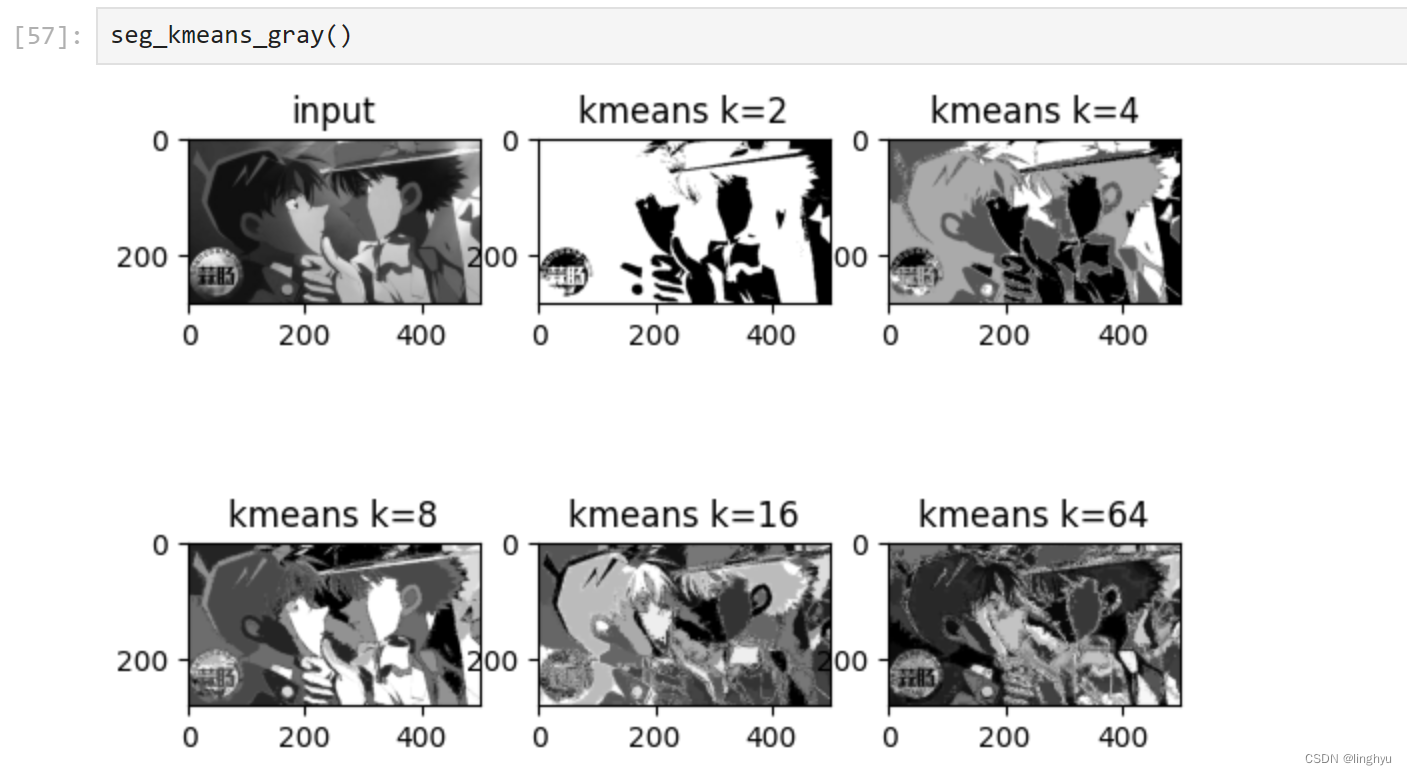
通过对 K-means 聚类分割算法的设计与调用,了解了这些算法的工作原理和应用细节。也应用到图像数据上,进行了面向图像的像素聚类分割。在算法调用中,可以通过多组测试不同参数,如迭代次数、随机采样次数、聚类中心的变化阈值,来寻找对于当前图像类型分割效果最优的参数区间。该算法对于光照变化、噪声敏感,可能需要进行预处理,如直方图均衡化、高斯滤波等。K值(聚类数量)的选择对于结果影响很大,需要根据实际情
1.背景介绍聚类分析是一种常见的数据挖掘技术,它主要用于将数据集划分为多个组,使得同组内的数据点相似性较高,而同组间的数据点相似性较低。在生物信息学领域,聚类分析被广泛应用于分析生物数据,如基因表达谱数据、蛋白质序列数据等,以揭示生物数据中的隐藏结构和特征。聚类分析在生物信息学中的应用主要有以下几个方面:基因表达谱分析:通过分析基因表达谱数据,可以发现不同生物进程或疾病状态下的基因表...
我们将产品的销售量按照不同的地区进行分类,然后比较不同地区的销售频数分布情况,以了解不同地区之间的销售差异。这就是一个简单的频数差异性分析案例,通过比较不同地区的销售频数分布情况,我们可以揭示出不同地区之间的销售差异,为制定营销策略、资源分配等决策提供参考依据。总的来说,频数差异性分析是一种有效的统计方法,适用于比较分类数据在不同组别之间的分布情况,能够帮助我们了解数据的分布特点和差异性。首先,我
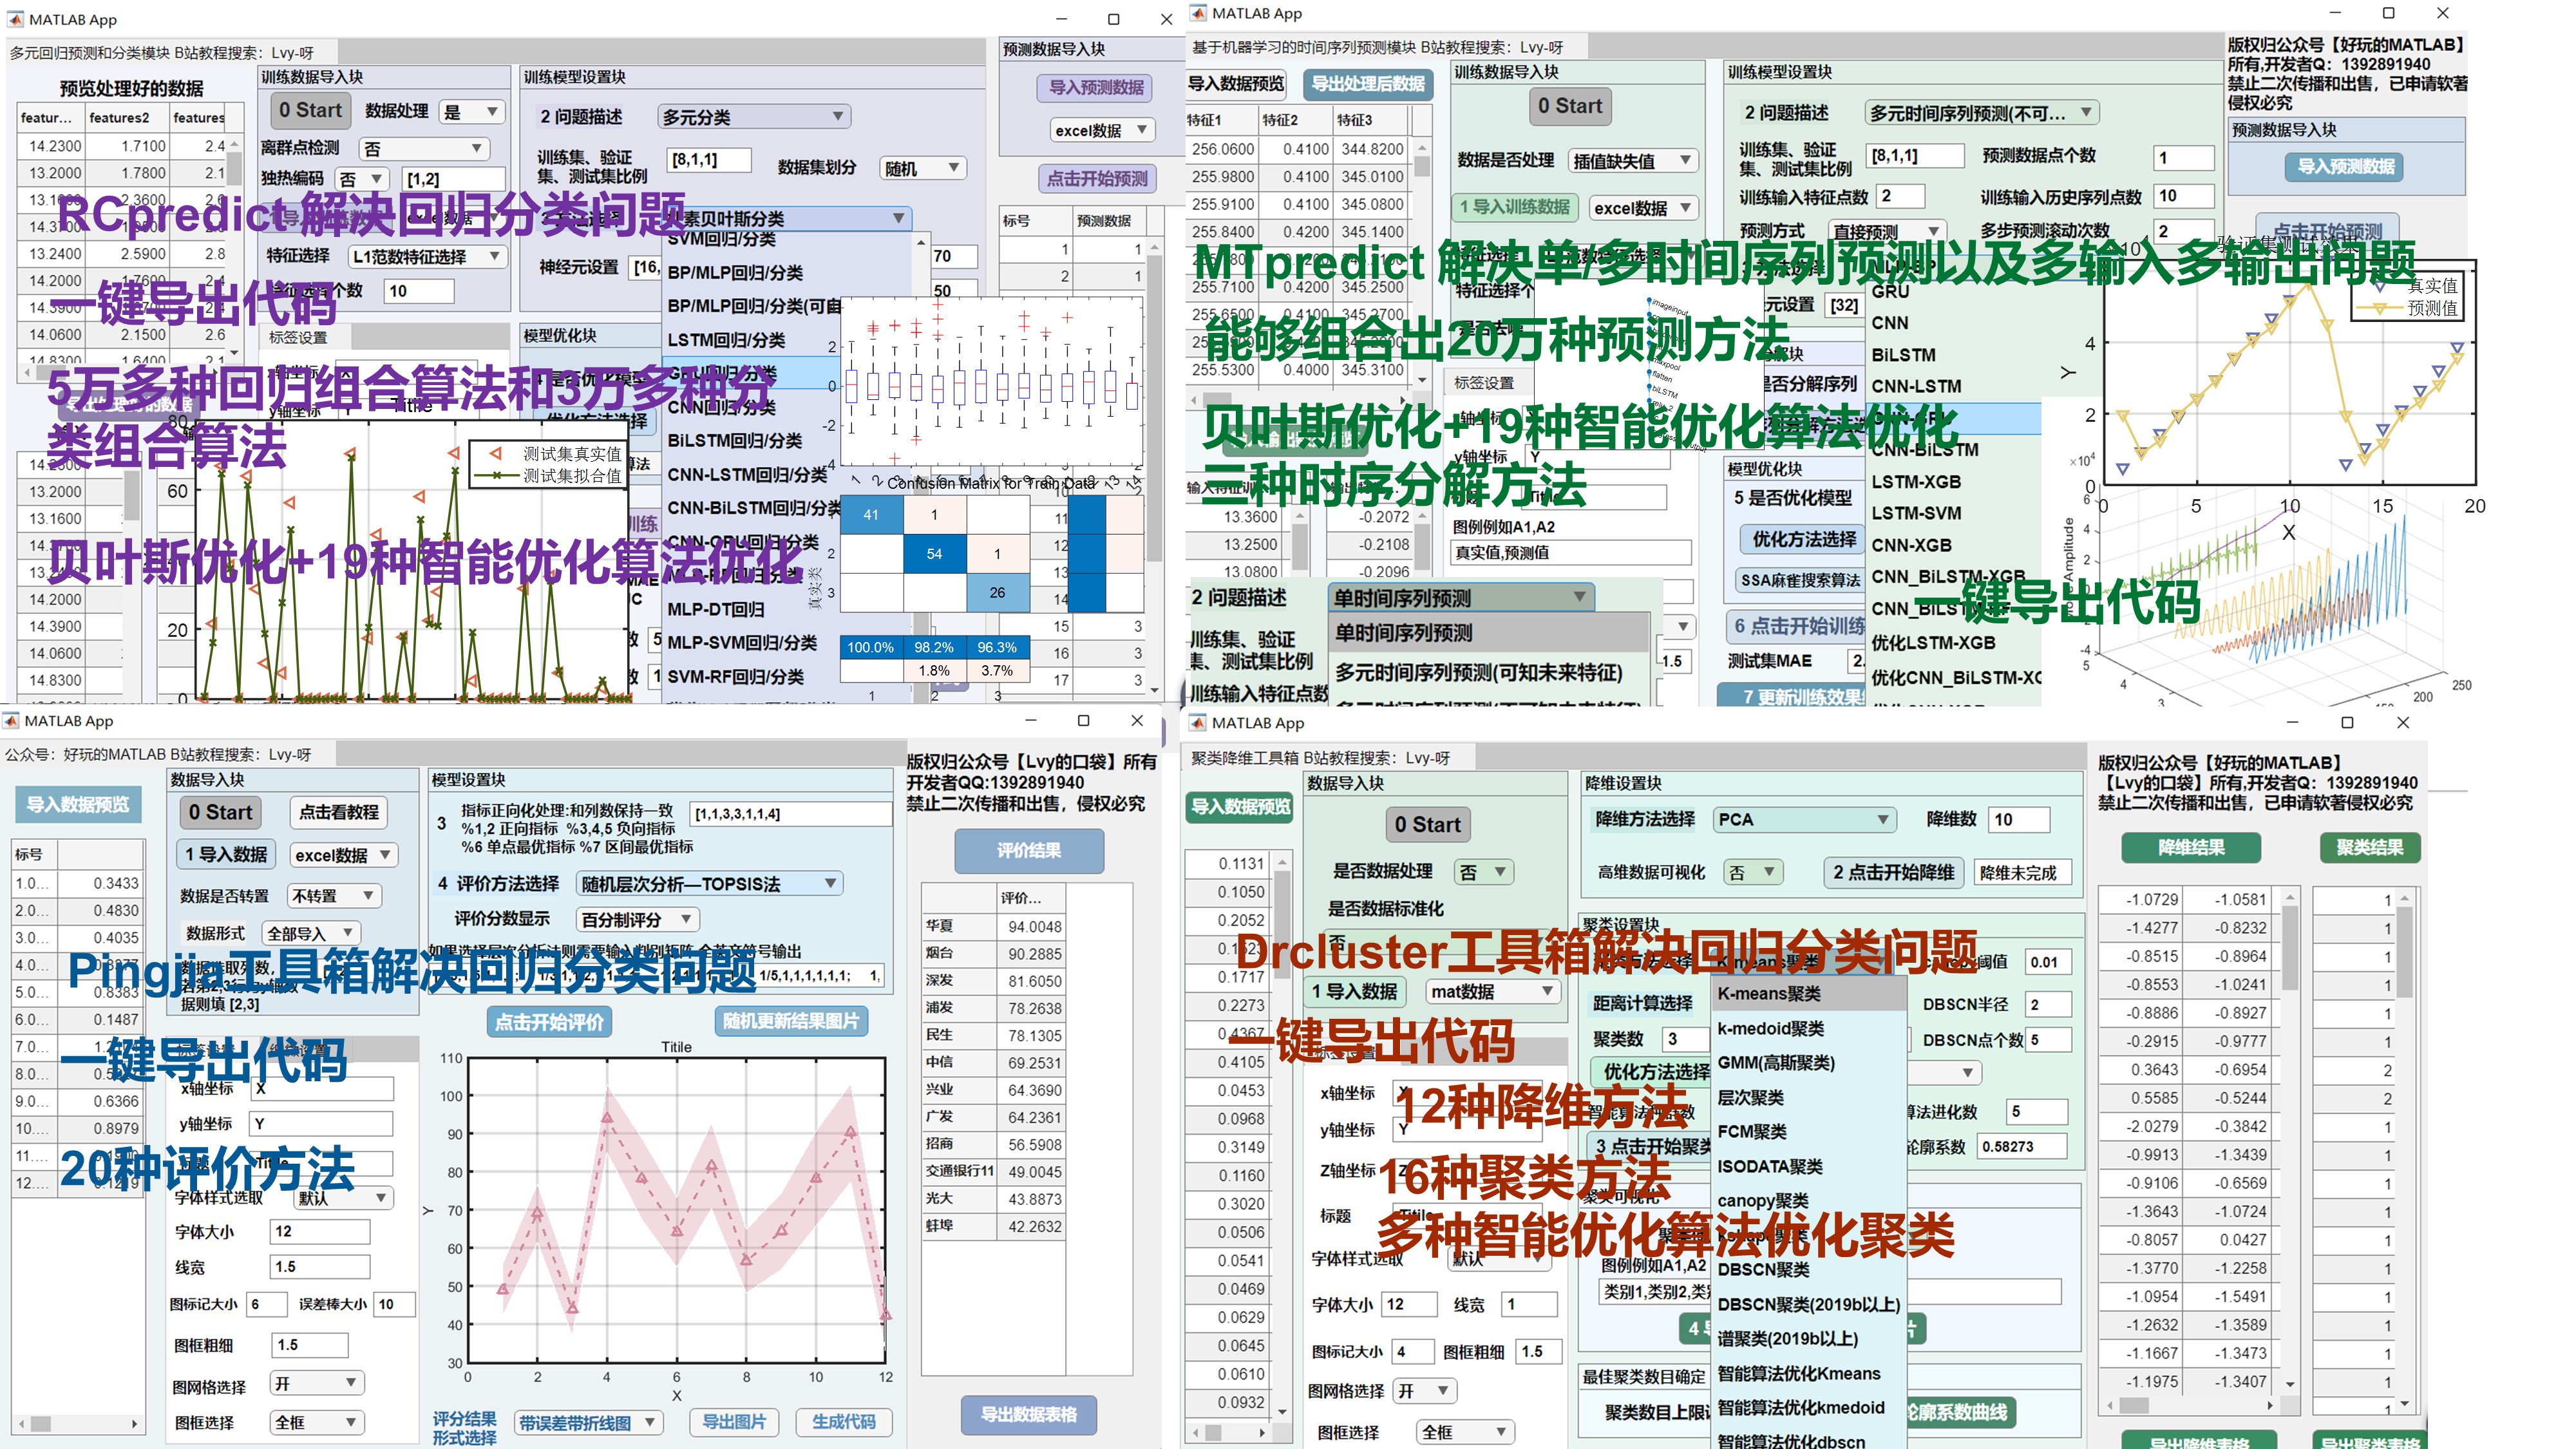
前言前言写作业、打比赛、写论文,不会写代码怎么办?来看看神器系列的工具箱,只需要几键就可以,且,后期可以修改代码,进一步修改和改进。神器系列自面世一年来不断改进,也已经有几千个用户了,根据用户的需求,现在回归分类工具箱RCpredict工具箱和时序工具箱MTpredict工具箱已经升级到V4版本,降维聚类工具箱DrCluster和评价工具箱pingjia已经更新到V3版本了,多种预测组合算法能够解
核心点:在半径Eps内含有超过MinPts数目的点边界点:在半径Eps内点的数量小于MinPts,但是落在核心点的邻域内噪音点:既不是核心点也不是边界点的点(离群点)
经过本章的学习,加深了对k-均值的了解,一个典型的聚类算法,主思想是将样本数据划分为K个簇,使得每个样本点都属于离其最近的簇中心,也就是质点,K-均值算法的优点包括简单、易于实现和计算效率高。然而,该算法的结果受到初始簇中心的选择和数据分布的影响,可能会陷入局部最优解。因此,在使用K-均值算法时,通常需要进行多次运行并选择最优的结果。
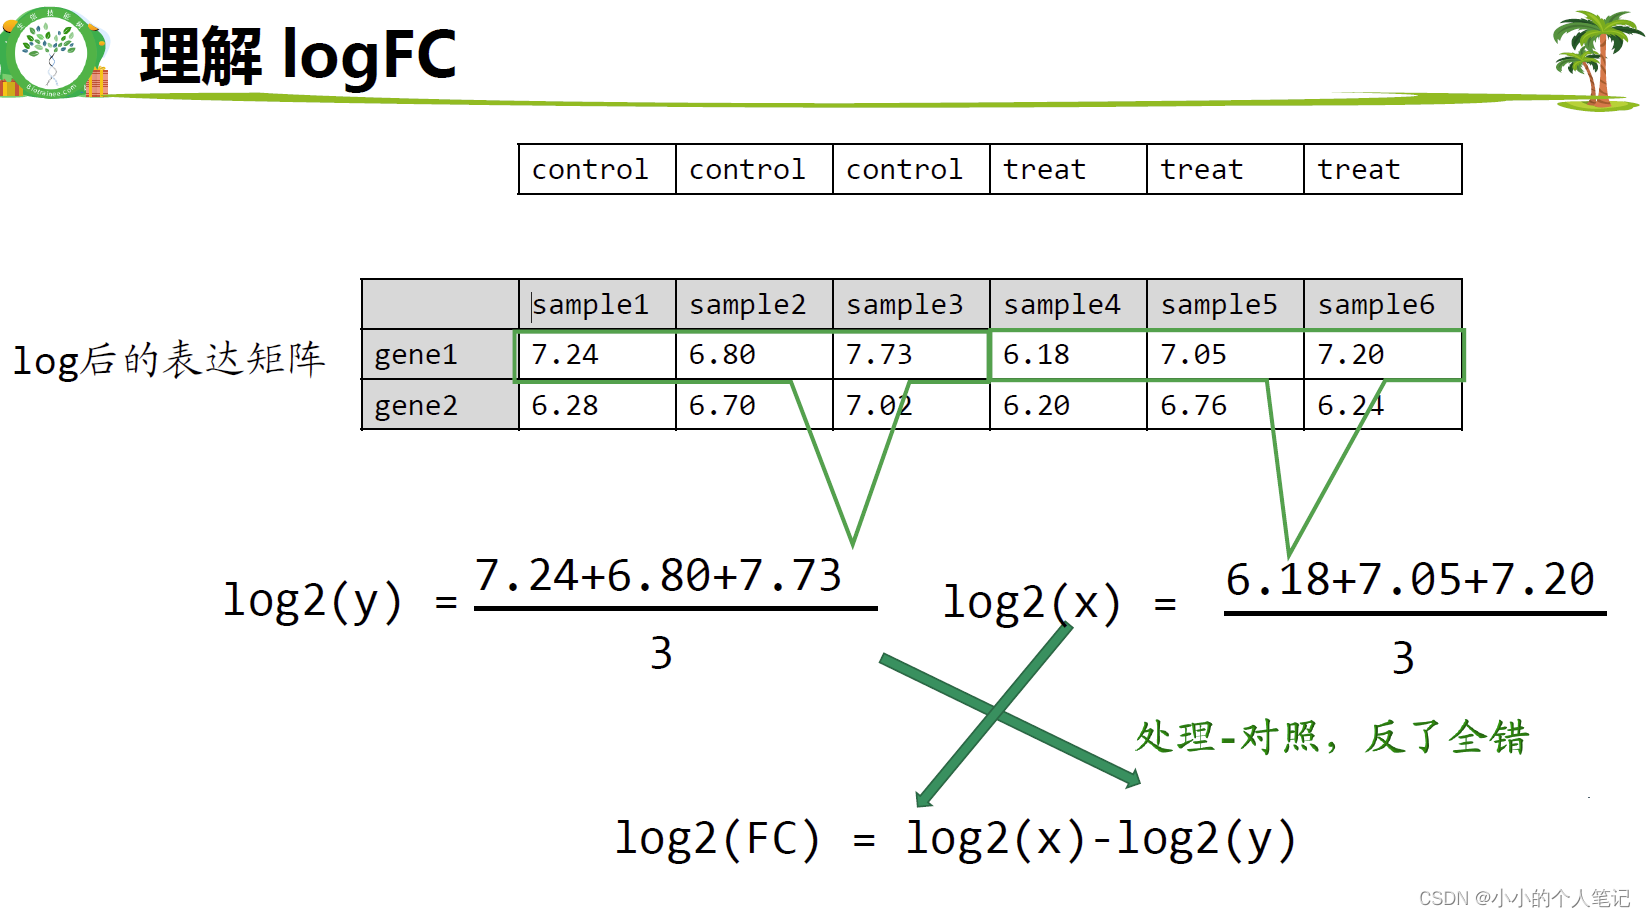
输入数据输入数据是**数值型矩阵/数据框**颜色的变化表示数值的大小实验目的:实验目的:通过基因表达量数据的差异分析和富集分析来解释生物学现象组别设计流程:不同处理 – 差异基因 – 找功能、找关联、找机制、同一通路有多个基因表达变化 – 解释差异,缩小基因范围流程:基因表达芯片的原理探针的表达量代表基因的表达量分析思路。
机器学习
聚类,就是将样本划分为由类似的对象组成的多个类的过程。聚类后,我们可以更加准确的在每个类中单独使用统计模型进行估计、分析或预测;也可以探究不同类之间的相关性和主要差异。聚类和分类的区别:分类是已知类别的,聚类未知。
DBSCAN聚类算法(商场数据分析)
K-means、K-means++、系统聚类、基于密度的聚类DBSCAN算法
kmeans学习笔记
聚类算法
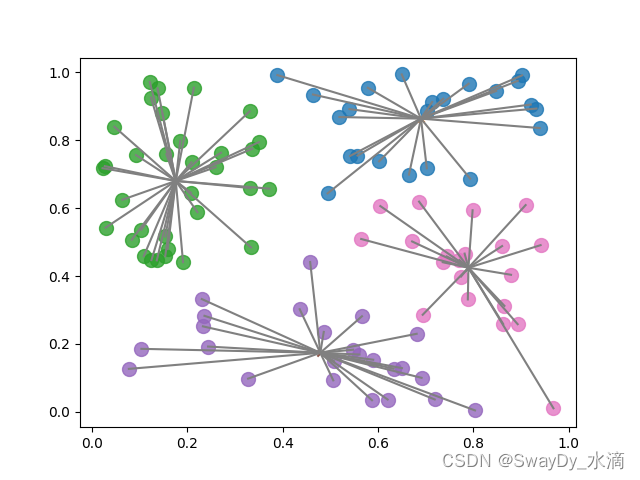
K-means是机器学习中常见的一种非监督学习分类算法,主要是对一个不带标签的数据集进行相似性分析,进而将其分成若干类。
聚类
——聚类
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区


 天工造物局




 DAMO开发者矩阵