登录社区云,与社区用户共同成长
邀请您加入社区
"机器人碰撞不是'报警多就完了',是'坐标落在哪片空间',"我接话,"像给车间地面画格子,看哪格被踩出坑。一句话总结:我们需要一个"机器人碰撞报警日志→月度聚合+坐标网格分区+卡方/泊松检验+sklearn区域风险分类+networkx相邻传导"程序,实现从"看报警总数"到"看空间红区+月度趋势"的闭环。"我就想干一件事,"大伟说,"把一年报警日志灌进去,按月统计碰撞次数,把每条碰撞的世界坐标映射
"用 pandas 做窗口特征,sklearn RF 多分类+概率校准,scipy 做曲线拟合 p 值,matplotlib 出 6 图,networkx 画链路,存 results/,"我开工程,"数据自包含,合成六关节 2 周 10 秒级数据,4 类过热故障,下载就能跑。拆开看,轴承没坏、油脂也没干,就是'莫名其妙热'。"我就想干一件事,"老周说,"把过去两个月六关节温度数据灌进去,模型不光说
"比如起弧阶段电流偏低+工件间隙偏大+层间温度偏低,这三个凑一起就容易未熔合,"我接话,"用 pandas 做波形分段特征提取(起弧段/稳态段/收弧段),scipy 做电流波形的统计特征(均值/方差/峭度/下降斜率)+ 短时能量 + 过零率,scikit-learn 训练随机森林分类器预判缺陷,matplotlib 画电流波形叠加缺陷标记+特征分布+ROC曲线+混淆矩阵+特征重要性+决策边界,ne
"最坑的是供应商,"小吴补充,"他们每批都出检验报告,写着'符合 ±0.05mm 公差',但你仔细看,外径在上限 +0.04,内径在下限 -0.04,高度又在上限 +0.03——三个维度叠加起来,机器人端的综合定位误差远超 0.05mm。来料由外协供应商提供,尺寸存在批次波动。"用 pandas 读来料+误差数据,scipy 做回归+相关性,matplotlib 出 6 图+报告,存 result
"我就想干一件事,"小郑说,"给我一套工装定位偏差值,模型直接算出'在这个偏差下,机器人抓取误差大概率落在哪个区间',我提前知道要不要换工装或者加视觉引导。"posture_rx": "姿态放大", "posture_ry": "姿态放大", "posture_rz": "姿态放大","tcp_dx": "TCP偏移", "tcp_dy": "TCP偏移", "tcp_dz": "TCP偏移","
"比如 J4 在臂展 1.2m、负载 12kg 时,模型给风险分 0.82,提前 1.5s 标黄,实际 0.8s 后扭矩到 88%,"我接话,"还能画出六轴风险热力图,看哪个轴是瓶颈,用 networkx 把'轴-工况-风险'连成关系网,接上位机做预警。ax.scatter(t[ov], risk_score[ov], marker="x", c="black", s=30, label="实际过
"用 pandas 按 segment_id 分组算折线距离,numpy 向量化算欧氏距离和加减速补偿,matplotlib 画段距离条形图+耗时饼图+轨迹散点,scipy 做距离分布检验,scikit-learn 聚类轨迹段画像,networkx 建段-点关系网,"我开工程,"数据自包含,合成一批离线编程点位数据,下载就能跑。"完整版用 OOP 封好,"我说,"一个类管点位加载,一个类算段距离,
"用 pandas 按设备+状态分组做时间差聚合,numpy 算占比,matplotlib 画堆叠条形图+甘特时间线,scipy 做状态时长分布检验,scikit-learn 聚类设备状态画像,networkx 建设备-状态转移关系网,"我开工程,"数据自包含,合成一批 FMS 状态日志,下载就能跑。"这条线,两台加工中心加一台机器人,跑了一周,"生产主管老周指着 MES 屏幕上的设备状态条,"M
"用 pandas 读两份标定数据,numpy 算欧氏距离误差向量,scipy 做配对 t 检验验证改善显著性,matplotlib 画误差对比散点+改善幅度柱状图+方向分解图,scikit-learn 聚类找改善不明显的异常点位,networkx 建'点位-方向-改善幅度'关系网,"我开工程,"数据自包含,合成 20 个点位的标定前后坐标,下载就能跑。"不是标定没用,"小赵说,"是没法证明。"a
"对,"小赵眼睛亮了,"我需要:对每种工件重量,测 10 次抓取力,画散点图,拟合一条'重量→抓取力'的回归线,标出安全边界(比如抓取力必须 ≥ 工件重量 × 2 的安全系数)。lambda x: 1 if str(x).lower() in ("1", "true", "yes", "是", "y", "slip", "failed")"grip_force_n": ["抓取力", "force
每日统计 = 快递站长的日报表:今天总共派了 480 单,成功 465 单,失败 15 单,失败率 3.1%——其中 9 单是"收件人不在"(吸盘问题),4 单是"地址不对"(定位偏移),2 单是"电话不通"(视觉超时)。一张表、一张图,早上看一眼就知道昨晚的抓取情况。reason_col: ["失败原因", "fail_reason", "reason", "error_code"],workp
"这只是核心逻辑,"我说,"完整版会用 OOP 封装:一个类管设备节点定义,一个类管路径边定义,一个类管拓扑构建,一个类管路径分析(最短路径、连通性、瓶颈识别),一个类管可视化。"nx.shortest_path(G, source="仓库", target="检测台", weight="distance")" 一行代码算出最短路径。需要一个"车间拓扑图构建与路径分析程序",用。machines
"我们车间有句行话:'全网拓扑是给网管看的,产线拓扑是给工程师用的。核心矛盾:"网络管理需要清晰的单产线拓扑以实施隔离和排障"与"全车间拓扑数据混杂,缺乏按产线属性提取子图的能力"之间的冲突。ax.set_title(f"{target_line} 网络拓扑({G.number_of_nodes()} 节点, {G.number_of_edges()} 条边)",。"小陈指着图的一角,"这条线有1
本文复盘了Pandas DataFrame布尔判断异常的排查过程:表面异常源于Backtrader分析器,实则因pywebview中直接对DataFrame进行if mt5_result:判断引发。正确做法应使用df.empty或not df.empty判断。同时发现回测数据排序方向错误(ascending=False实为降序),以及双EMA策略仅判断当前值而非交叉信号,导致无交易生成。建议使用C
如果你用过 Excel,DataFrame 就是编程版的 Excel 表格fill:#333;important;important;fill:none;color:#333;color:#333;important;fill:none;fill:#333;height:1em;Excel 表格行 Row第1行, 第2行...列 Column姓名, 年龄, 城市...单元格 Cell具体数据Dat
pandas_ta技术分析库采用量化开发导向的功能分类体系,主要按指标类别(15个模块如Overlaps、Momentum等)、调用粒度(单指标/批量/策略)和数据依赖(收盘价/OHLC/成交量)三个维度组织指标。与传统交易逻辑分类不同,其Overlaps类别基于可视化位置而非功能特性,例如EMA与BOLL同属该组。该设计强调API调用效率和量化实践需求,建议用户通过ta.Category或df.
本文对比了Python中openpyxl和pandas处理Excel多工作表的核心差异。openpyxl擅长精细操作,支持单元格样式、公式等底层控制,适合格式定制;pandas则专注于高效数据处理,支持批量读写和分析多表数据。通过代码示例展示了两种工具在读取、写入和修改工作表时的不同实现方式。建议根据需求选择:纯数据处理用pandas,格式调整用openpyxl,复杂场景可混合使用。openpyx
本文介绍了使用Python的pandas和openpyxl库根据Excel单元格背景色提取并分类数据的方法。文章首先展示了原始文件和按背景色分类后的效果图,然后提供了完整的实现代码。代码实现了列名与数字转换功能,并分别通过openpyxl和xlwings两种方式获取单元格背景色。主要功能包括:检测单元格填充颜色、处理主题色和索引色、使用Excel COM作为后备方案获取最终显示颜色,最终将相同背景
本文深入解析了使用Pyinstaller打包pandas应用时,因C扩展模块缺失导致的`ImportError: No module named 'pandas._libs.tslibs.base'`错误。文章剖析了Pyinstaller默认依赖分析机制遗漏二进制文件的原因,并提供了两种实测有效的解决方案:手动复制缺失文件与修改spec文件完整打包,帮助开发者彻底解决此经典打包难题。
正则表达式就是一连串的超级通配符,用来快速“搜查,替换,拆解,验证”文本。
近期需要大量处理数据,pandas比excel效率高太多,记录一下pandas的常用高阶用法。
pandas的数据转换函数map、apply
看起来您可能正在“头歌”平台上进行Pandas基本操作的作业。- **为上述DataFrame添加一列“DoubleAge”,其值为年龄列的两倍**。- **创建一个包含学生姓名、年龄、成绩的DataFrame**。- **从给定路径读取一个CSV文件,并展示前5行数据**。- **检查数据集中是否有缺失值,并用0填充缺失值**。- **按照部门分组,并计算每个部门的平均年龄**。- **显示Da
【代码】pandas检测缺失值、处理缺失值。
pandas是基于Numpy的一种工具,该工具是为解决数据分析任务而创建的。Pandas 纳入了大量库和一些标准的数据模型,提供了高效地操作大型数据集所需的工具。pandas提供了大量能使我们快速便捷地处理数据的函数和方法。你很快就会发现,它是使python成为强大而高效的数据分析环境的重要因素之一。
hello呀!各位铁子们大家好呀,我是一个在软件测试行业摸爬滚打十几年的老江湖了,今天呢来和大家聊一聊用Python的pandas读取excel文件中的数据。
【代码】pandas的常用方法。
打开jupyter notebook,新建Python3,编写代码import pandas as pd。重新打开运行:错误消失。
【Python】pandas:索引(Index)【属性,修改索引(set_names,set_axis,rename,rename_axis,add_prefix, add_suffix,reindex,reindex_like,align,set_index,reset_index),普通列与索引列互转,索引排序】, 多索引(MultiIndex)【属性,修改索引,通过索引获取数据,索引排序】
原因: 读取多个数据文件 input_data 后,用append() 方法合并数据集,没用单独管索引。现象:打印数据会发现 df 数据集的索引 存在多个 0,1,2,3(每个数据文件都有单独索引)解决:df=input_data.append(df,ignore_index=True)
pandas是一个强大的Python数据分析库,它提供了多种读取文件的方法,支持多种文件格式。以下是pandas中常见的一些文件读取方法及其详细说明、常用参数、代码示例和数据示例。
pandas的tz_localize与pytz.timezone().localize用来设置时区,会更改timestamp。pandas的tz_convert与datetime.astimezone()用来更改时区,更改时区不会改变timestamp。pandas的to_datetime生成时间,默认对应到UTC时区,而由datetime.strptime生成的时间,默认对应到当地时间。
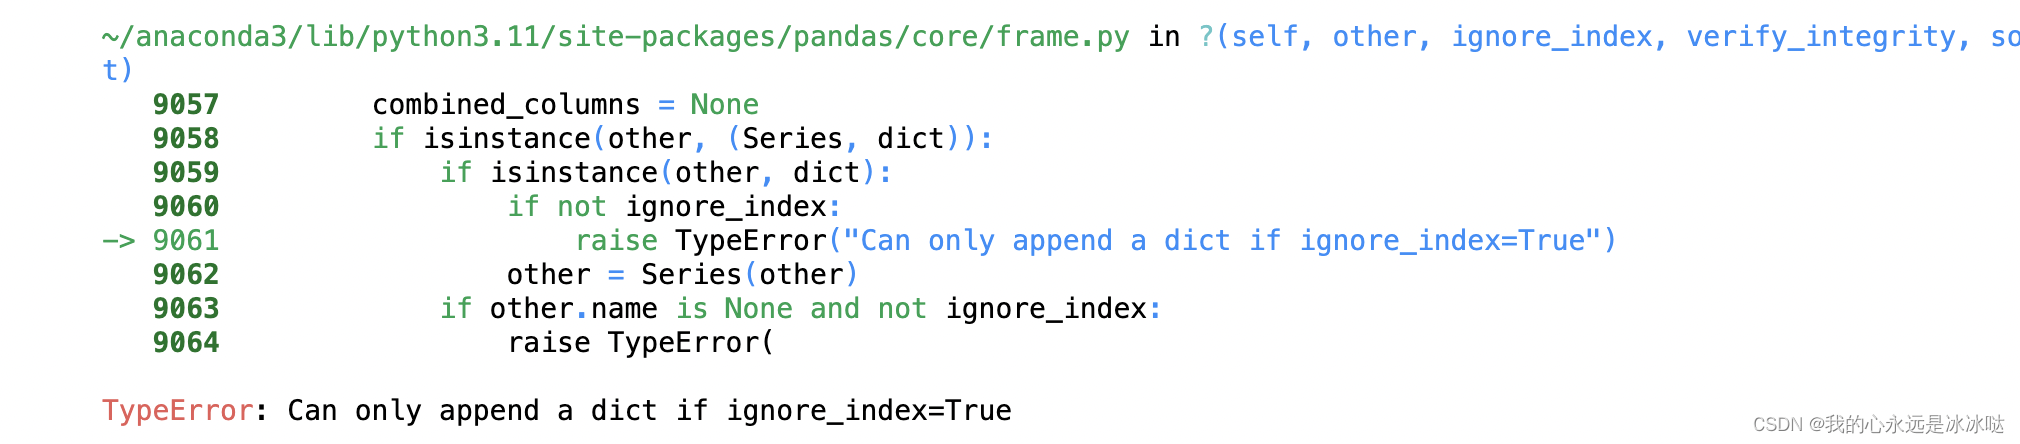
可以看到这个pandas的添加行的方式和list也是一样,都是使用append函数,但是有一个问题,就是这个append是要返回值的, 这个倒是和list不同,还有一个区别是就是这个ignore_index的参数,必须得有,否则会报错。
数据排序与排名
装了python3.6版本,pandas.read_csv() 报错 OSError: Initializing from file failed
可以尝试改一下代码文件的名字 我原先名字就是csv.py 改了就好了。如果升级pandas包 和 代码 都检查没问题。还有文件目录也没问题。很可能是由于循环导入。
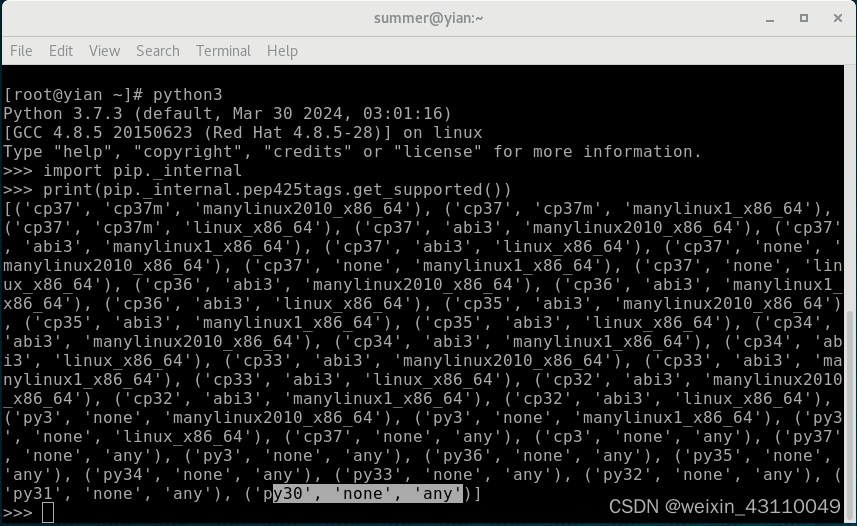
2、下载上面支持的安装包(cp37 -> 支持python3.7;4、执行命令python3,确认库安装成功。执行命令python3。
随着人工智能的不断发展,数据分析这门技术也越来越重要,很多人都开启了学习数据分析,本文就介绍了pandas学习的基础内容。本章简单介绍了pandas数据排列,包括Series升序降序排列,和DataFrame单列多列排序。
describe()函数是pandas中的一个统计方法,用于生成数据集的基本描述性统计信息,包括均值、标准差、最小值、最大值、25%、50% 和 75% 等。默认情况下,它只会统计数值型数据的统计信息,对于非数值型数据会输出计数、唯一值数、出现频率最高的值和频率等。describe() 函数是 pandas 中一个十分实用的工具,用于快速获取数据集的描述性统计信息。本文详细介绍了该函数的各种参数及
这个错误通常是由于读取的 CSV 文件采用了不同的编码方式,而 pandas 默认使用 UTF-8 编码进行解码。当文件中包含无法在 UTF-8 编码中表示的字符时,就会报出。:如果上述方法都无法解决问题,你可以尝试使用错误处理模式来处理无法解码的字符。常用的错误处理模式有。参数来指定编码方式。例如,如果文件采用 GBK 编码,可以尝试使用。:如果你不确定文件的实际编码方式,可以尝试其他常用编码方
方法用于遍历DataFrame的每一行。在循环中,我们可以通过指定列名来访问当前行的值,例如。库,可以使用多种方式读取Excel数据。参数用于指定要读取的列范围。方法用于遍历DataFrame的每一列。在循环中,我们可以通过。替换为你的工作表名称,以及对应的列名和处理逻辑。替换为你实际的Excel文件路径,替换为你实际的Excel文件路径。替换为你实际的Excel文件路径,表示从A列到C列的范围。
从第19行开始读取,分别取表格中的第4列,第2列,第5列,第6列作为结果的第1列,第2列,第3列,第4列。
默认为False。如果为True,则修改原始DataFrame,而不是返回一个新的DataFrame。:用于指定新的索引列的名称。如果提供了多个级别的新名称,可以传递一个元组,每个级别对应一个名称。如果为True,则删除索引列,而不是将其作为数据列添加到DataFrame中。:要重置的层级(可以是索引的名称、索引的位置或索引的列表)。默认情况下,将重置所有层级的索引。默认drop=False,将N
直接在Cmd中的C:\Users\HP>路径下输入pip install pandas,下载失败。
默认情况下,将数字列转换为数字类型,并且前导零会丢失。为了避免这种情况,我们可以将这些列转换为字符串。解析器会抛出异常,最好的方式是指定一个解析器列表。默认情况下将使行标签加粗,但你可以关闭它。文件的内容,并将其作为字符串传递给。当只提供了一个解析器时,如果解析失败,中的元素用于形成列索引,如果。字符串、文件或URL,并将。的输出(会损失浮点数的精度)请注意,这些类附加到现有的。因此,要获得没有转
有一套字符串处理方法,可以方便地对数组的每个元素进行操作,最重要的是,这些方法会自动忽略缺失值。只要两个对象中存在缺失值,对应的结果中也是缺失值,除非指定了。符号直接按位置进行索引,如果索引超过字符串的长度,结果将是。:正则表达式中的任何捕获组名称都将用作列名,否则将使用捕获组号。例如,我们删除列名的前后空格,并将其改为小写字母,同时用。参数也可以是二维的,但是得保证其行数必须与调用的对象一致。可
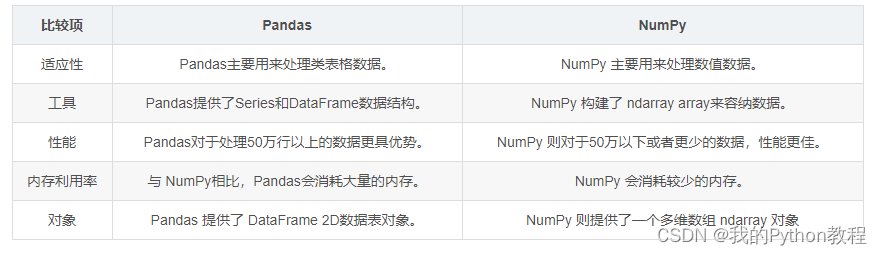
Pandas 和 NumPy 被认为是科学计算与机器学习中必不可少的库,因为它们具有直观的语法和高性能的矩阵计算能力。要将Pandas DataFrame转换为ndarray数组,您可以使用.values属性。这将返回一个numpy数组,其元素与DataFrame中的行和列相对应。----------★★历史博文集合★★----------
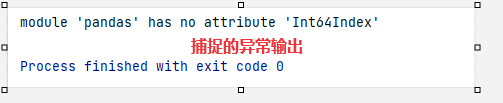
【代码】modulepandashas no attributeInt64Index。
pandas
——pandas
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 鲲鹏昇腾开发者社区

 乐奇 Rokid 开放社区