


- @qq_41566819


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
KNN(K-Nearest Neighbor, K 近邻)算法是最简单的分类算法之一,它也是最常用的分类算法之一。
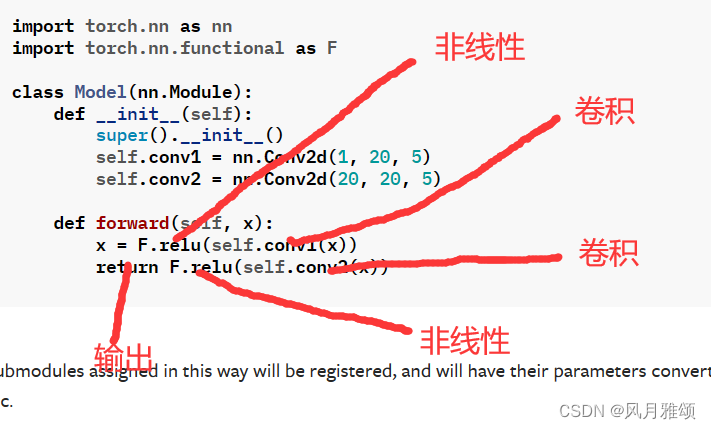
构造一个5*5的数据集,卷积核为3*3,卷积过程为,卷积核从图像的左侧开始,相对应的数据相乘在相加,最后输出。完成一次卷积后,若stride=1向右侧移动一个像素,继续卷积运算。当第一行完成后,向下移动一个像素,同时移动到图像最左侧,继续进行卷积运算。若padding=1,则在原始数据边缘增加一圈默认为0的像素,再进行卷积运算。想要运行该程序,需要添加pytorch。断点运行,以及一步运行。
线性回归最小二乘法的两种求解方法(即优化方法)分别是正规方程和梯度下降。
cv2.imshow()函数在显示图像时,指定的窗口如果不存在,则会按默认设置创建一个窗口,窗口大小由图像大小决定,且不能更改。

损失函数(loss function)又称为误差函数(error function),是衡量模型好坏的标准,用于估量模型的预测值与真实值的不一致程度,是一个非负实值函数。损失函数的一般表示为L(y,f(x)),用以衡量真实值y与预测值f(x)不一致的程度,一般越小越好。
朴素贝叶斯算法或朴素贝叶斯分类器(Naive Bayes Classifier,NBC)发源于古典数学理论,是基于贝叶斯理论与特征条件独立假设的分类方法,通过单独考量每一特征被分类的条件概率作出分类预测。
数据具有多种数据类型,除了数字化的信号数据(声音、图像等),还有大量符号化的文本。但是,机器学习模型无法处理符号化的文本,只能接收数值型和布尔型数据,需要对数据进行特征提取。特征提取又称特征抽取,是将任意数据(如字典、文本或图像)转换为机器学习的特征向量。
缺失值通常是指记录的缺失和记录中某个字段信息的缺失,一般以空白、NaN或其他占位符编码,采用删除法和数据填充进行处理。
特征选择皮尔森系数以及嵌入法。
特征选择,又称变量选择、属性选择或变量子集选择,是选择相关特征子集用于模型构造的过程。简要地说,通过检测相关特征。摒弃冗余特征,获得特征子集,从而以最小的性能损失更好地描述问题。