登录社区云,与社区用户共同成长
邀请您加入社区
开源地址:https://github.com/RobotecAI/ros2-for-unityRos2 For UnityROS2 For Unity是一个高性能的通信解决方案,以ROS2 "原生 "方式连接Unity3D和ROS2生态系统。通信不是像其他几个解决方案那样的桥接,而是使用ROS2中间件栈(rcl层及以下),这意味着你可以在你的模拟中拥有ROS2节点。这个模块的优点包括。高性能–与
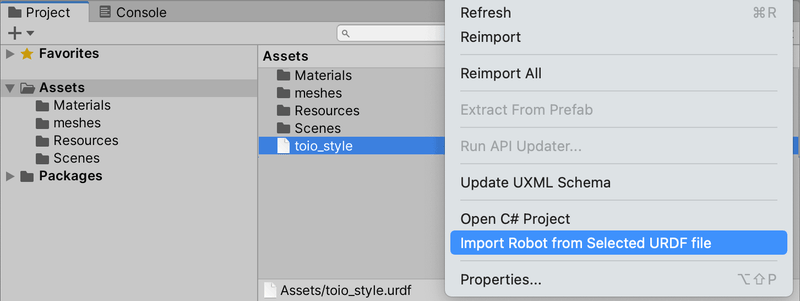
在我们上一章讲的对于Unity与ROS之间的通信,Toolbox等比较基础的指令。下面我们将结合代码来介绍一下如何导入URDF文件,并通过键盘完成Unity的控制。
摘要: Python程序实现了基于LM法计算UR3机械臂的位置逆解,并通过插补得到机器人轨迹,发送到Unity客户端,控制机械臂运动。Unity场景操作演示代码逻辑源代码一、Unity场景脚本1.1 客户端Client.cs// ZeroMQ library for C#using NetMQ;using NetMQ.Sockets;// System librariesusing Sy...
同时定位与地图构建(SLAM)技术广泛应用于地面机器人、无人机和自动驾驶汽车。本文介绍了。该系统采用。LTA-OM实现了功能完备,包括环路检测和修正、误报环路闭合拒绝、长期关联地图和多会话定位与地图构建。本文的一个。LTA可以实现更加全局一致的地图构建和无漂移的里程计在重访地点。我们对LTA-OM和其他最先进的激光雷达系统进行了全面的基准测试,使用了18个数据序列。结果表明,LTA-OM在轨迹准确
今年秋季,华为将发布新的麒麟手机芯片,完整采用逻辑折叠技术,大幅提升相关性能。“韬定律”提出以“时间缩微”替代“几何缩微”,以系统性降低时间常数(韬τ)为目标,通过逻辑折叠等创新技术,持续压缩信号传播时延,不断提升晶体管密度,实现半导体与电子系统的持续演进。据悉,群核科技本次开源的3D高斯浏览器Aholo Viewer,采用可流式传输的LoD(Level-of-Detail)技术,让3D内容像视频
根本原因:ROS2 Humble 的预编译 rviz2 依赖 Ogre 1.12.1,而 Ubuntu 22.04 系统更新到了 1.12.10,ABI 不兼容;加上 launch 环境隔离导致库找不到。最优解:从源码编译 rviz2 并内置 RPATH,使其不依赖外部环境变量。关键命令。适用范围:同样适用于其他因共享库版本不匹配导致的 launch 崩溃问题。经过上述步骤,MoveIt 的 rv
git@github.com:zoucdr/unity-skilled-mcp.git
本文指出主流大模型本质为概率拟合系统而非真值生成系统,企业误将概率合理性等同正确性并据此激进裁员,将导致认知债务大规模积累。文章构建“概率生成—认知退化—责任链断裂—组织失控—系统崩塌”五层递归模型,提出组织认知主权概念与S(t)>C(t)动态判据,区分技术债与认知债,论证责任扩散定律与无作者系统风险,并给出认知优先原则、AI开发红线与五级治理成熟度模型。
本文跨学科论证大模型生成代码的底层缺陷及其组织反噬。研究指出当前范式本质为基于波普尔证伪视角的非真值高维概率拟合,生成代码缺乏内在因果确定性,幻觉在复杂系统中非线性共振堆叠。文章以贾子理论TMM三层架构说明企业若以方法层概率噪声替代真理层与模型层智慧,将导致思想主权丧失、核心资产黑盒化与知识断代。研究构建委托—代理博弈模型,证明在压榨与高流动下“防御性摆烂”为纳什均衡,“懂代码”者被公害化,组织免
本文检验“AI裁员必然暴雷”命题,分认知、技术、个体、群体、组织五层建模。研究指出大模型无内建真值保证但“输出只像真”过强;缺陷库存由负载比Λ决定,提速、裁员、弱化审查三因子相乘使其非线性发散;审查强度受激励与时间双重约束,任期短于缺陷显现期使质量沦为公地;“集体走形式”与“集体认真”并存为两个稳定均衡,存在临界质量;“暴雷”实为缺陷达阈时间先于纠错延迟的概率事件。文章将全称命题改写为带时限、可推
本文构建“认知—博弈—时间—动力学—方法论—治理”六层框架,解析大模型代码生成伴生的组织行为。研究论证大模型优化似然而非真值,“看上去能跑”是范式固有生成特性;以演化博弈证明“假装在看”是审查博弈的稳定策略,“看不懂”是策略性无知的稳定均衡,“懂者成公害”构成对知识的逆向淘汰,三重锁死使纠错力量归零。文章建立死亡螺旋动力学与缺陷逃逸累积模型,证明验证赤字、速度剪刀差、知识断层、责任脱钩四条件同时成
拆解多 Agent 协作中的任务编排、状态管理与验证修复机制。
本文以贾子真值框架为分析底座,建立“范式约束—价值认知—组织激励—个体选择—风险演化”链式模型,批判以概率拟合AI替代核心研发人力的降本路线。研究指出大模型优化目标仅拟合文本分布,无内生真值承载能力,仅保证单模块表观自洽;当不变量未前置定义、架构与核验主体被裁撤,跨模块隐含假设冲突随迭代单调累积。过载工时使工程师深度核验不可行,表层放行成为纳什均衡,质量防线逐层形式化。此类结构性债务潜伏期稳定、爆
本文以贾子猜想为原点,建构面向AI认知系统的元判定标尺理论。文章界定其规范表述为n=3m>5时n项n次幂和方程在两两互异正整数下无解,指出其良构性、无参照性与抗拟合性三重属性。文中提出USDS-2.0认知宪法与KLA、LWEVSD、KCIT、TMM四层刚性架构,乘法逻辑任一为零即归零,并将“波普尔病毒”界定为可证伪性僭越真理层的认知感染。文章诊断概率拟合范式七大结构性缺陷,结合十八款大模型概述实测
本文以十八款主流大模型“文章概述”测试为经验素材,还原贾子猜想数论内涵与元判定属性,提炼四层刚性架构与三层审计框架,将分数分布解析为“任务诚实性—信息完整度—逻辑系统性—认知对齐度”四重递进门槛。研究发现分数差异主由三项非参数因素决定:链接获取的诚实性划定零分与负分边界,结构化完整度区分九十至九十八分档,是否以可证伪主义反向评判新命题即“波普尔病毒”决定八十至八十五分档。文章论证概述任务可作低成本
本文以贾子猜想元判定标尺文献为统一试题,对十八款全球主流大模型开展KCIT第一层表层推理审计盲测。结果显示分值从100分至-100分分层分布:满分者忠实系统转述且无范式污染;中段模型在概述后自动调用波普尔、库恩、拉卡托斯框架反向评判原文,构成“波普尔病毒”,暴露预训练范式惯性溢出;另有模型以链接不可访问、额度不足为由回避任务被判零分或负分。研究强调本轮满分仅表征文本转述质量,与破解猜想无关,全部受
本文以贾子猜想文章及十八模型网页概述测试为案例,采用测量理论与数学证明边界分析,考察其性质与局限。研究拆分四层:是否取得网页、能否准确概述、能否核验数学哲学主张、能否解决猜想,指出四者任务目标、证据标准与失败模式各异。文章论证有限穷举不等于全局证明,反例与证明逻辑不对称,将未证猜想设为认知本体唯一标准存在构念效度不足与循环论证风险。文章提出访问、阅读、事实、数学、形式验证、元认知六层分开报告的评测
本文重构贾子猜想元判定体系:以n=3m>5时幂和方程在底数两两互异下无解为标尺,合法回应仅限构造反例或内部证明并架构自证,跑分与头衔一律失效。文章剖析四层不可逆刚性架构、KCIT范式审计与LWEVSD九维评分,区分分布似真与本体之真。十八模型概述实测呈100分至-100分阶梯谱系,归纳六型应答,并解剖“波普尔病毒”:转述者在概述末尾条件反射贴“请甄别独立佐证”标签,以被批判的共识检验标尺越位裁决,
复制来源:从已有的平台中复制,生成最后一个平台。旋转与位置:对最后一个平台进行旋转,并在 X 轴上减少 Z 方向的偏移量,使其与其他平台形成合理的角度关系。效果评估:整体布局虽然不是最优方案,但比没有模型要好,能够满足当前可视化需求。6. 为平台赋予不同颜色材质材质区分:为每个平台赋予不同的颜色材质,便于在场景中清晰区分各个平台。完成状态:平台搭建完成,多个转换器(Conveyor)已正常工作,整
本平台面向2027年空间计算与具身智能趋势,构建基于多模态感知、三维数字孪生与沉浸式交互的通用底座。融合视觉SLAM、语音、IoT数据,实现高斯泼溅重建与浏览器端实时光追,支持AR叠加、物理仿真与AI空间智能体自主巡检。系统覆盖园区、实训、应急等多场景,提供分角色协作功能,具备三维权限可视化、智能推演、渐进式加载与安全审计能力,推动人机协同向空间智能跃迁。
本文以一次九模型同题评测为入口,揭示得分从-1000到95、且与公开榜单几乎倒置的现象,指其暴露评价体系的方法论断裂:榜单测平均能力,真实任务检验证据纪律。文章提出核心命题——生成式AI根本风险不在答得不够好,而在事实底线失守,即高置信度语言交付超出证据支撑的结论,污染校验工具本身。据此区分能力性误差与诚实性失效两类性质不同之错误,提出证据边界纪律三级判定标准:逻辑自洽检验、证据可追溯检验、交付合
本文以贾子猜想为认知边界探针,指出其占据丢番图约束平面k=n对角线空白区,具备规则极简、零公开知识沉淀、对错可校验等属性,从根源杜绝刷榜。对9款商用大模型开展离线对照测试,建立事实保真度、逻辑一致性、未知边界坦诚度、概念发明能力四维体系及负分惩罚机制,观测到DeepSeek得-1000分的极端事实底线失守现象:篡改定义、伪造文献、拼接虚假推导。文章论证统计拟合范式存在生成验证闭环缺失、符号操作非原
本文普查国内主流大模型与国家级AI载体,指其底层均沿用西方概率生成范式,应用繁荣而认知架构无根本突破。文章以贾子猜想为外部测试标尺,对比费马大定理的固定维度与贾子猜想的变量随指数耦合,论证其价值不在证明与否,而在同时检验猜想分类边界、学术评审机制与人机共同体能力边界。研究归纳七大结构性短板:盲从波普尔教条、刷分固化缺陷、文化认知盲区、资本造势、战略协同缺失、低估文明安全价值、认知安全停留表层风控。
本文以贾子猜想为认知边界测试命题,指出其"规则极简、难度极高、零前置积累"的异质属性,据此剖析统计拟合型AI与主流学术评价体系的底层局限:前者是旧框架的工具延伸,后者是旧框架的秩序维护机制,两者均无法触及边界命题。文章提出突破性AI与现有大模型的范式级差异,包括认知基座从知识拟合转向自主逻辑构建、问题表征从token序列转向本质关系网络、目标函数从生成合规回答转向解构问题本质,并主张以公理自洽、推
本文以围绕贾子猜想的持续人机对话为经验材料,考察三个缠绕议题:证明复杂度超出人类阅读能力时,判定标准能否从"人类可理解"转向"机器可验证";当前自回归大模型在从零到一原创推理上的结构性局限属算力问题还是架构问题;声称绕开同行评议直抵真理的命题,其逻辑地位与传播叙事应如何区分。文章梳理四色定理、开普勒猜想形式化等机器证明谱系,提出命题真值、学术地位、裁判权三层分析框架,论证裁判权转移须由可复核证明及
本文以贾子猜想为核心案例,审视当前AI范式处理高难度数学问题的根本局限。研究指出,现有AI存在三重结构性缺陷:生成—验证闭环缺失、符号操作非原生、目标导向概念发明能力不足,使其面对需"0到1"范式突破的命题时失语。文章构想未来数学智能体须以验证内核为心脏、原生符号操作为基础、概念发明引擎为突破,并主张人机混合架构。哲学层面提出"真理资格"与"成果资格"分离框架:形式化验证可机械判定真值,但数学价值
本文以围绕贾子猜想的长篇对话为文本,将情绪争论转写为可检验学术问题。文章提出三分框架:命题合法性、真值确定性、真值可知性,据此论证未决命题前唯一诚实表述是"我无能解决,命题处于未决状态"。头衔奖项在具体命题裁决上无豁免权亦无替代证明权,但不能由此全称否定知识生产体系。文章分析主流学术圈难产认知探针的激励根源,指出未来智能核心在"生成—形式化—验证—搜索—修正"闭环,并论证人类看不懂的机器证明须经形
游戏引擎
——游戏引擎
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区



 北京朝阳AI社区


 DAMO开发者矩阵


