登录社区云,与社区用户共同成长
邀请您加入社区
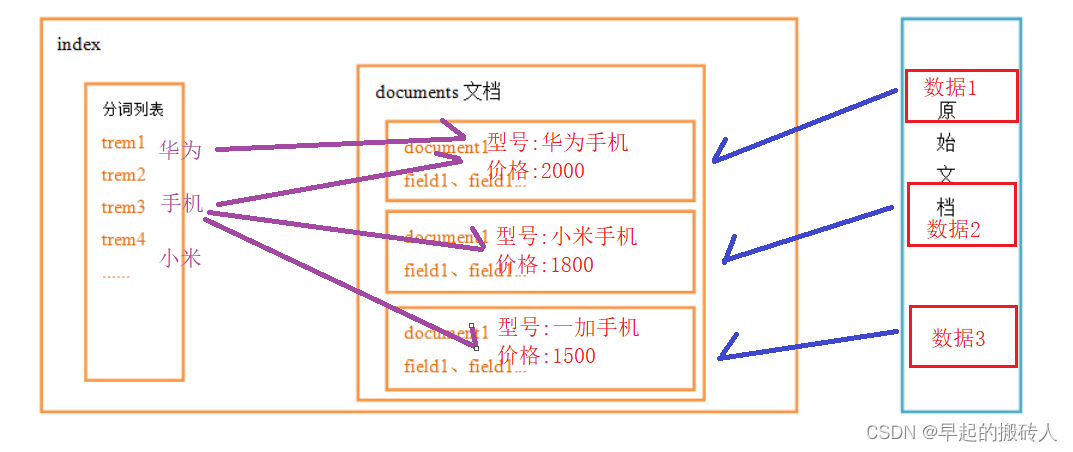
本章将介绍:ElasticSearch的作用,搭建elasticsearch的环境(Windows/Linux),ElasticSearch集群的搭建,可视化客户端插件elasticsearch-head的安装及使用,对IK分词器的安装及使用;本章介绍的ElasticSearch操作基于Restful形式(使用http请求的形式),java代码操作请参考下篇文章目录1.ElasticSearch简
想象这一种情况,如果搜索结果中得分出现相同的情况下:由于搜索会在分片的副本之间均衡的轮询请求,可能会出现请求在不同的副本之间返回的循序不同,从而影响排序结果的稳定性。搜索接口有提供preference参数:curl localhost:9200/_search?preference=xyzabc123。可以使用的参数: _primary,_primary_first,_local,_onl
在 Apache Lucene 中,倒排索引(Inverted Index)是用来高效搜索文档的核心数据结构。然而,不同类型的字段(Fields)可能会使用不同的存储和索引方式,并不全都是倒排索引。在大多数情况下,文本数据(如 Text 和 String 字段)会使用倒排索引,而数值和精确匹配数据(如 Numeric 字段和 Sorted Set 字段)会使用其他高效的数据结构来支持快速查询和排序
漏洞复现过程的记录
Solr是一个独立的企业级搜索应用服务器,它对外提供类似于web-service的API接口,用户可以通过http请求,向搜索引擎服务器提交一定格式的XML文件,生成索引,也可以通过http get操作提出查找请求,并得到XML格式的返回结果。
56rPa6sFRV6_L5HavKCpnw├── 1│├── index││├── _6.dii// Point Values││├── _6.dim// Point Values││├── _6.fdt// Field Data,存储了正排存储数据,写入的原文存储在这││├── _6.fdx// Field Index,
问题:为什么ES 搜索是 近 实时的?为什么文档的 CRUD (创建-读取-更新-删除) 操作是 实时 的?Elasticsearch是怎样保证更新被持久化在断电时也不丢失数据?为什么删除文档不会立刻释放空间?refresh, flush, 和 optimize API都做了什么, 什么情况下应该使用他们?1.使文本可被搜索必须解决的第一个挑战是如何使文本可被搜索。 传统的数据库每个字段存储单个值
Neo4j用的搜索引擎是Lucene属性索引创建索引//对name属性创建索引CREATE INDEX ON :student(name)//对age属性创建唯一索引CREATE CONSTRAINT ON (n:student) ASSERT n.age IS UNIQUE查询索引:schema删除索引DROP INDEX ON :student(name)DROP...
//Macro for creating new objects#if defined(LUCENE_ENABLE_MEMLEAKTRACKING)#define _CLNEW new(__FILE__, __LINE__)#define LUCENE_BASE public CL_NS(debug)::LuceneBase#elif defined(LUCENE_EN...
首先这个所有的依赖包就不需要多讲了,首先下载Quazrt发布包,解压,运行doc文件夹下(E:\Quartz\quartz-2.2.3\docs\dbTables)的tables_mysql_innodb.sql脚本 新建job //MyJob 普通job,这个不需要实现org.quartz.Job Java代码 package job; impor
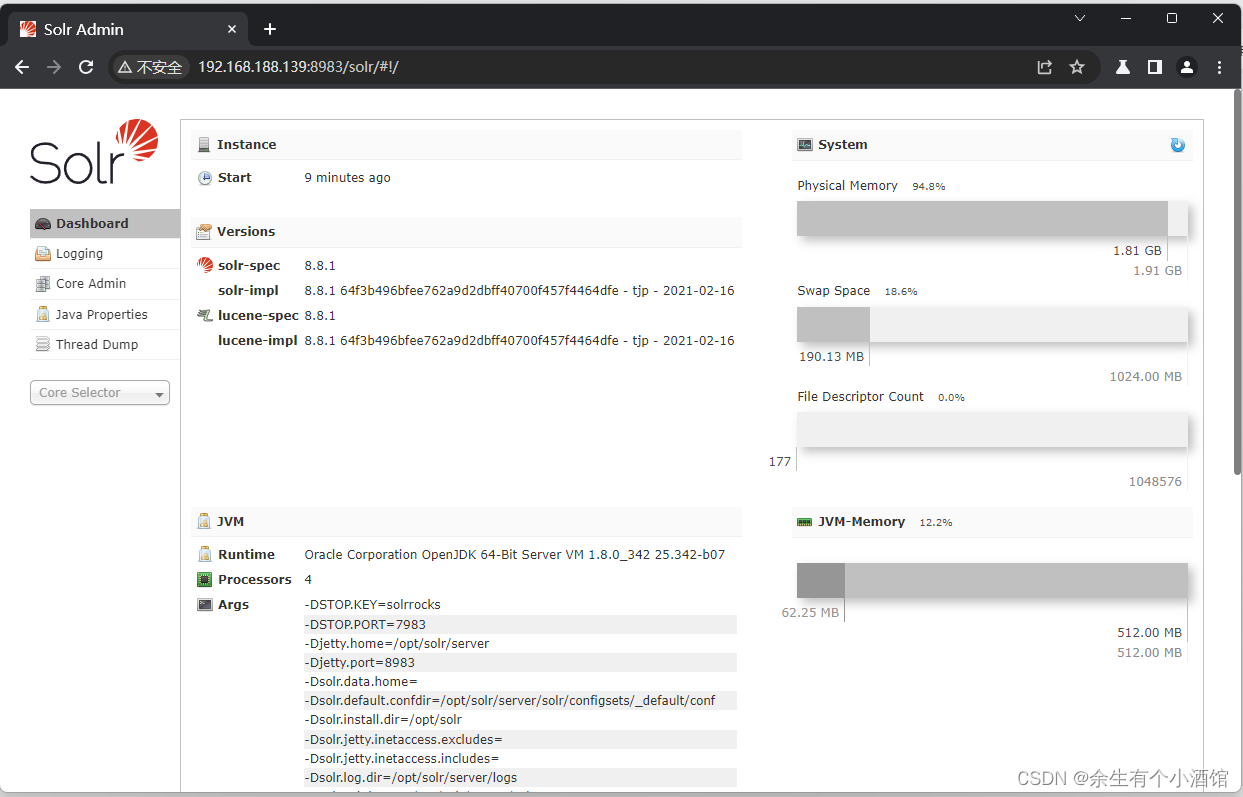
简介Apache Solr是美国阿帕奇(Apache)基金会的一款基于Lucene(一款全文搜索引擎)的搜索服务器,使用Java语言开发,主要基于http和Apache Lucene实现的,该产品支持层面搜索、垂直搜索、高亮显示搜索结果等。漏洞描述Apache Solr 8.8.2之前版本存在安全漏洞,Apache Solr 中的 ReplicationHandler(通常注册在 Solr cor
最近产品提了一个新需求,希望做出像淘宝一样的搜索框(就是那种输入一个字,就有一个下拉框给你推荐以这个字开头的商品名称,然后随着你的输入,变化出不同的提示的那种关联搜索框)。至于效果图的话,嗯,我去扒一张淘宝的图贴上:效果就类似这种,当然要想实现这样的效果,首先你得有个数据库,里边放着这些可以被检索到的名称用来备选。在页面与后端语言进行ajax交互的时候,将符合用户输入格式的数据传输到前台显示,..
MPP前置环境安装依赖环境######################################################################################################
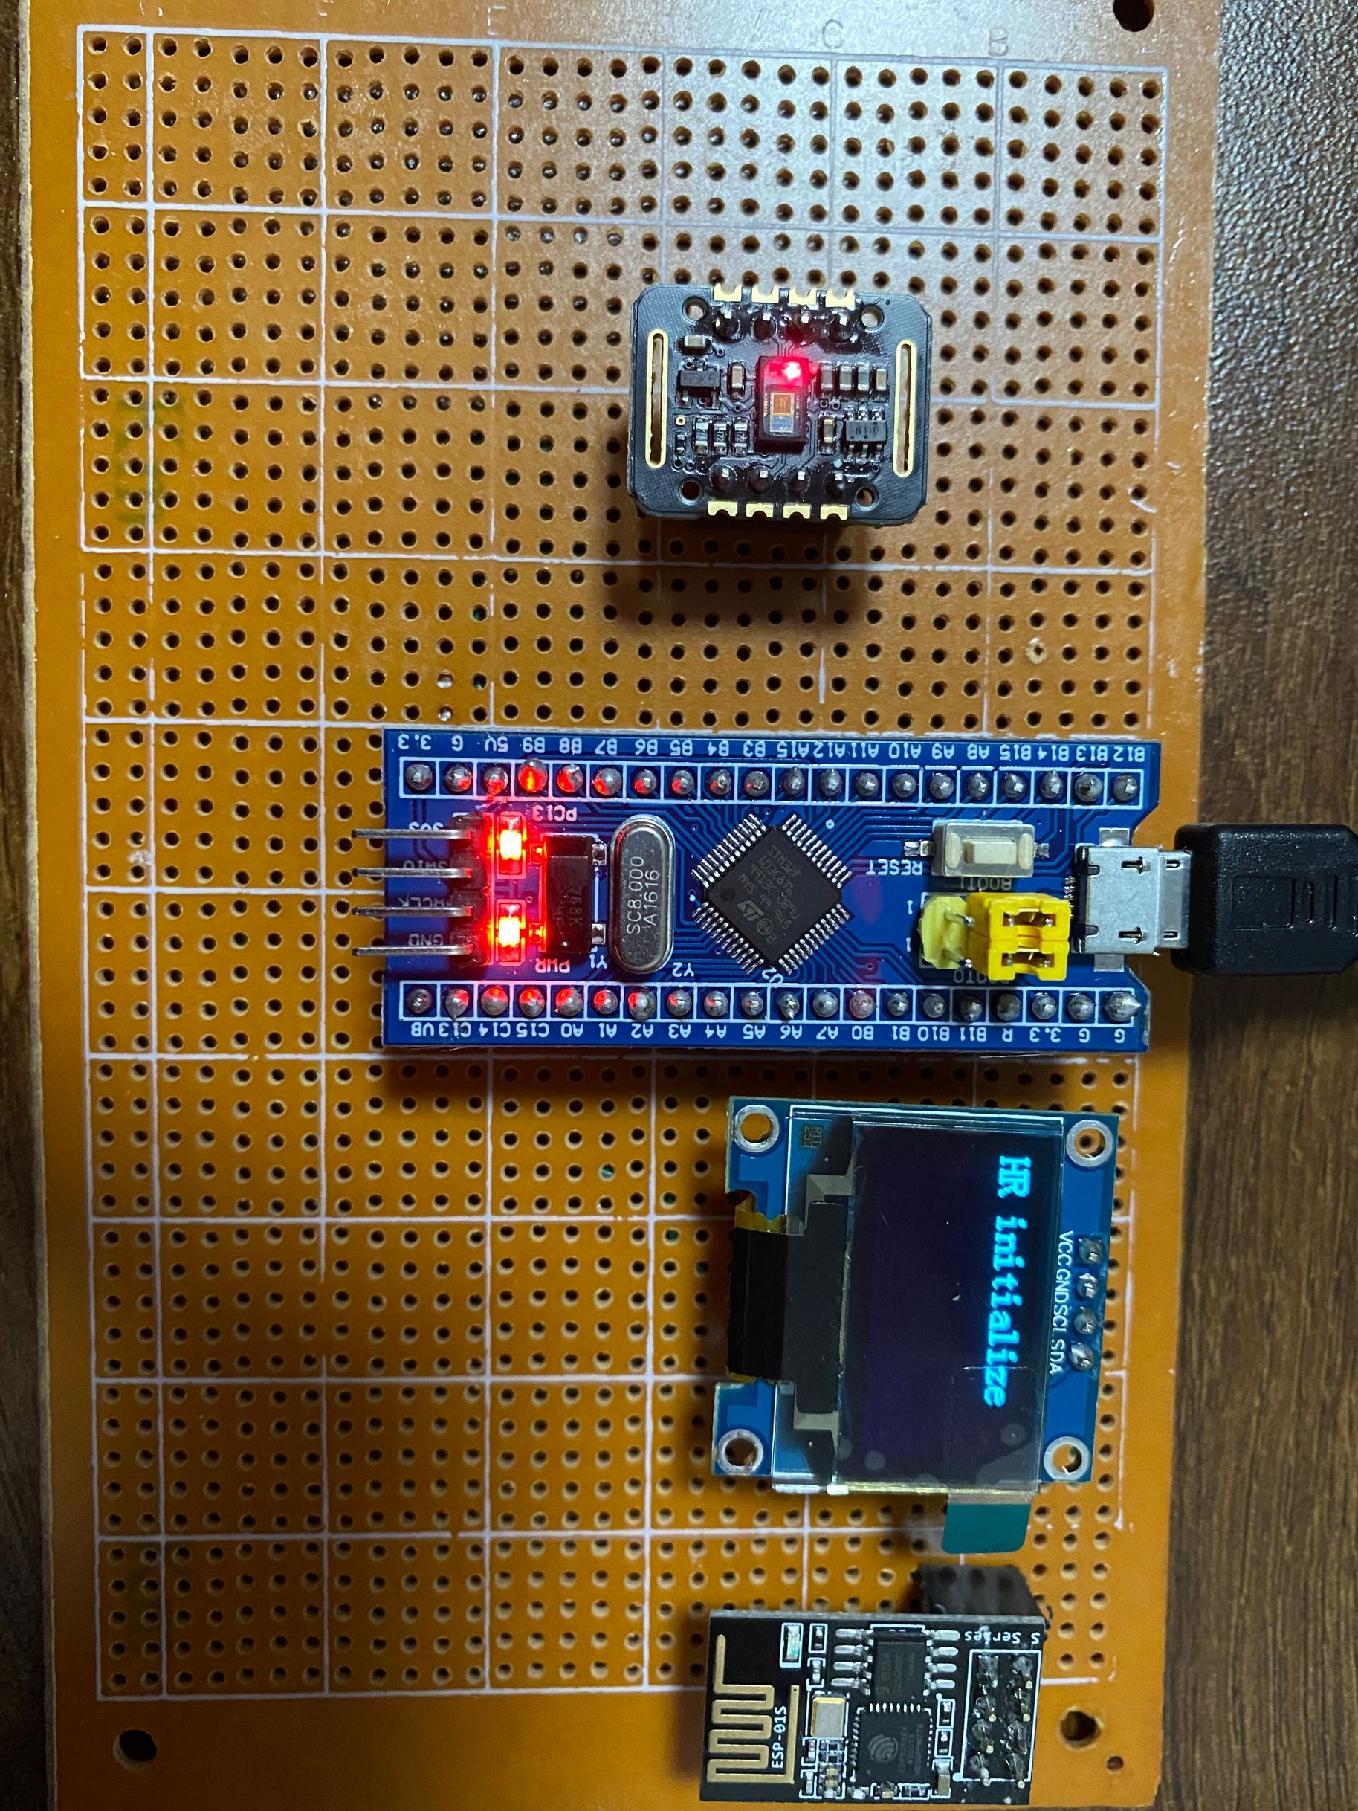
具体是把采样数据存到环形缓冲区,WiFi模块通过中断方式取数据,这样两边互不干扰。心率采集,stm32采集心率,stm32心率采集,OLED实时显示,wifi上传心率,app显示心率,上位机显示心率。心率采集,stm32采集心率,stm32心率采集,OLED实时显示,wifi上传心率,app显示心率,上位机显示心率。5:C#上位机实时显示心率,心率数据存储,历史数据查看。5:C#上位机实时显示心率
伴随游戏行业的兴起,unity引擎的使用越来越普遍,本文章主要记录博主本人入门unity的相关记录大部分依赖siki学院进行整理。在新建完成后会在创建的目录下生成相关工程文件如图所示:Assets: 资源(场景脚本模型)Library: 库(系统)Logs: 日志Packages: 导入的包ProjectSettings: 工程设置Temp: 临时文件(文件过大可以删除部分缓存)UserSetti
在新建完成后会在创建的目录下生成相关工程文件如图所示:Assets: 资源(场景脚本模型)Library: 库(系统)Logs: 日志Packages: 导入的包ProjectSettings: 工程设置Temp: 临时文件(文件过大可以删除部分缓存)UserSettings: 设置未完工暂无题外话初入计算机行业的人或者大学计算机相关专业毕业生,很多因缺少实战经验,就业处处碰壁。下面我们来看两组数
final IK 保姆级教程
Git是一种分布式版本控制系统,被广泛用于软件开发中的代码管理和协作。以下是对Git使用的详细介绍,涵盖基础概念、常用命令、实际应用及高级用法。1. 基础概念版本控制:Git通过快照记录文件在特定时间点的状态,允许用户查看历史、更改版本、并行开发。分布式:每个开发者拥有完整的项目副本(包括历史记录),即使没有网络也能工作。仓库(Repository):存储项目的目录,分为本地仓库和远程仓库。快照与
Velocity模板可以通过configset ’ Velocity / '目录中的Velocity模板或作为参数提供。用户定义的configset可以包含可呈现的、潜在的恶意模板。参数提供的模板在默认情况下是禁用的,但是可以通过设置params.resource.loader来启用。定义响应编写器需要配置API访问。Solr 8.4完全删除了params资源加载器,只有在configset是“可
2.Apache Lucene的总体架构。1.Apache Lucene简介。
elasticsearch 索引详细讲解
Apache Solr 远程命令执行漏洞(CVE-2019-0193)
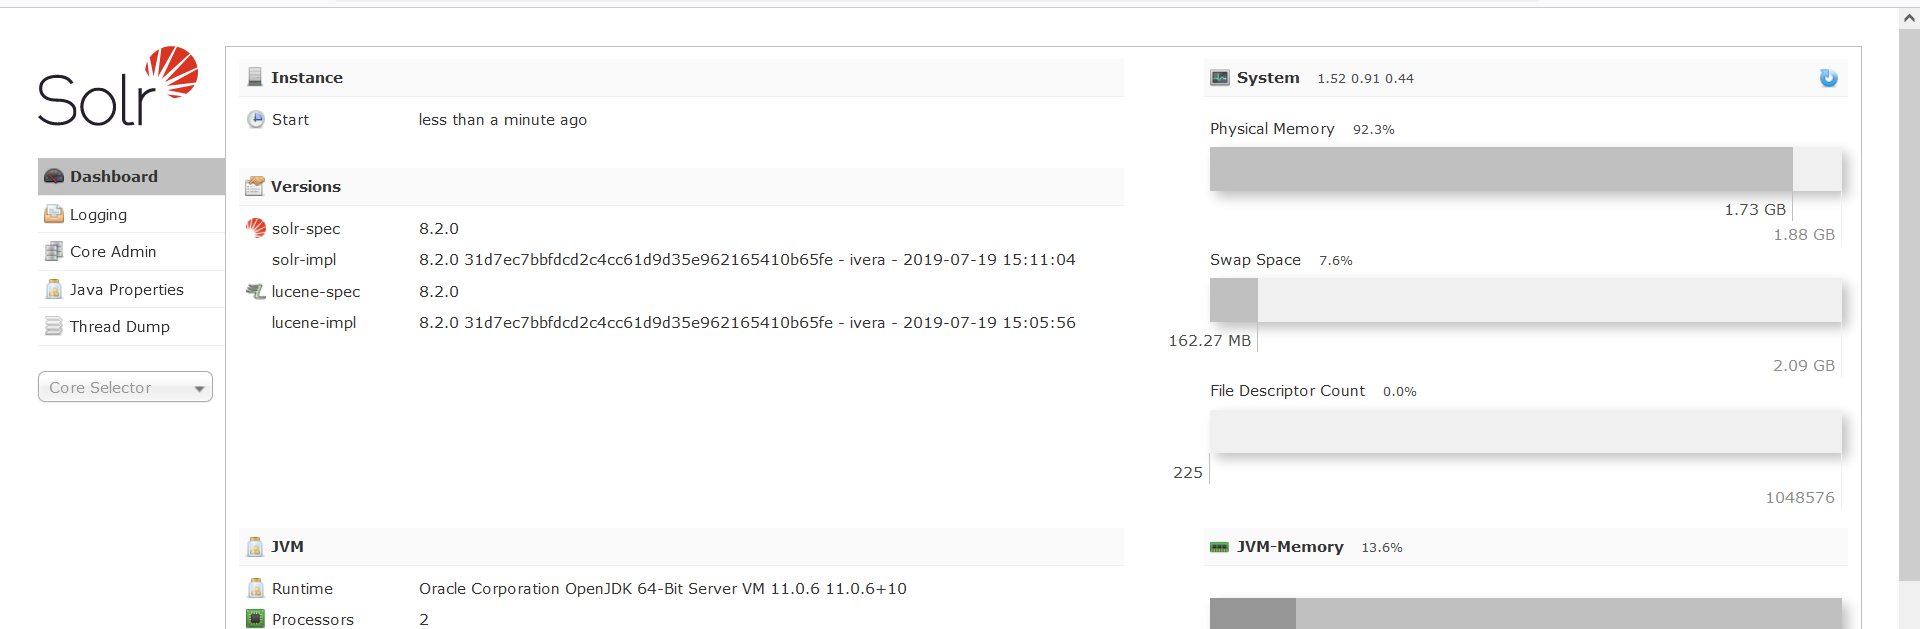
漏洞描述Apache Solr 5.0.0版本至8.3.1版本中存在输入验证错误漏洞。攻击者可借助自定义的Velocity模板功能,利用Velocity-SSTI漏洞在Solr系统上执行任意代码。影响范围Apache Solr 5.0.0 ~8.3.1漏洞利用(1)默认情况下params.resource.loader.enabled配置未打开,无法使用自定义模板。可以先通过如下API获取所有的核
内置hbase和solr启动
昨天研发说在kibana中统计userid字段不出图,后来查到该字段显示冲突了,然后再查看了GET test/_mapping下该索引的mapping,发现userid是long类型的,而userid.keyword是string类型的,出现这种情况的根本原因是日志中这个字段存的是数值类型的值,改成字符串类型即可,由于急着用,我司上线一般是下午6点30上线,所以临时修改了下该字段的类型,步骤如下:
elasticsearch 中term与match区别term是精确查询match是模糊查询term查询term是代表完全匹配,也就是精确查询,搜索前不会再对搜索词进行分词,所以我们的搜索词必须是文档分词集合中的一个。比如说我们要找标题为北京奥运的所有文档$curl -XGET http://localhost:9200/index/doc/_search?pretty -d'{"query":{
在一次es节点挂掉后日志所报错误:[index_20190830][[index_20190830][2]] IndexShardRecoveryException[failed to recovery from gateway]; nested: EngineCreationFailureException[failed to create engine]; nested: EOFExc...
在使用ES的过程中遇到以下问题:[2015-01-06 16:12:34,061][WARN ][indices.cluster] [node_141] [ips][4] failed to start shardorg.elasticsearch.index.gateway.IndexShardGatewayRecoveryException: [ips][4] fai
一、传统搜索引擎排序算法概述1. 1 搜索引擎排序算法概述搜索引擎查询的结果是按照一定的规则排序供用户查看, 这种规则就是搜索引擎排序算法. 目前几种比较通用的搜索引擎排序算法有Direct Hit 排序算法、PageRank、排名竞价服务和词频位置加权排序算法.Direct Hit 排序算法是一种动态排序算法, 搜索引擎返回的排序结果根据用户的点击和网页被浏览的时间进行变化. P
目前neo4j文档只限于官方文档,将neo4j官方主要的文档按点整理了一下,供需要的人参考,内容也会不断更新!
今天给大家介绍一下经典的开源机器学习软件:编程语言:搞实验个人认为当然matlab最灵活了(但是正版很贵),但是更为前途的是python(numpy+scipy+matplotlib)和C/C++,这样组合既可搞研究,也可搞商业开发,易用性不比matlab差,功能组合更为强大,个人认为,当然R和java也不错.1.机器学习开源软件网(收录了各种机器学习的各种编程语言学术与商业的开源
作者: 车东 Email: chedongATbigfoot.com/chedongATchedong.com写于:2003/05 最后更新: 03/16/2005 16:30:45Feed Back >> (Read this before you ask question)版权声明:可以任意转载,转载时请务必以超链接形式标明文章原始出处和作者信息及本声明http://www.chedo
文章目录1、引言2、相关度概率模型3、Okapi BM25 函数3.1 逆文档频率:IDF(qi)IDF(q_i)IDF(qi)3.1.1 函数公式及参数3.1.2 函数曲线3.1.3 总结3.2 词频相关性函数:S(qi,D)S(q_i,D)S(qi,D)3.2.1 函数及参数3.2.2 相关性曲线3.2.3 k1k_1k1值的作用:3.3 文档长度相关性:KKK4、最终函数公式1、引言B
vue.draggable中文文档 - itxst.com
apache 是个伟大的组织。在lucene 检索 如火如荼时, apache不忘继续努力,近期提供了对各种格式文件进行解析的解决方案 -- apache旗下的tika. 虽然还没有1.0版 , 但已经很好用:/*** 解析各种类型文件* @param 文件路径* @return 文件内容字符串*/public static String parse...
分类:lucene 2013-05-03 23:42554人阅读 评论(1)收藏举报Tika是Apache的Lucene项目下面的子项目,在lucene的应用中可以使用tika获取大批量文档中的内容来建立索引,非常方便,也很容易使用~Tika的缺点就是都是依赖外部的jar包,导致jar包的重量太大,lucene的核心包只有1M,tika约20M,tika依
Apache Solr 是一款开源的搜索引擎。在 Apache Solr 受影响版本中,由于 Solr Metrics API 默认输出所有未单独配置保护策略的环境变量。在默认无认证或具有 metrics-read 权限的情况下,攻击者可以通过向 /solr/admin/metrics 端点发送恶意请求,从而获取到运行 Solr 实例的主机上的所有系统环境变量,包括敏感信息的配置、密钥等。
Elaticsearch,简称为es, es是一个开源的高扩展的分布式全文检索引擎,它可以近乎实时的存储、检索数据;本身扩展性很好,可以扩展到上百台服务器,处理PB级别的数据。es也是使用Java开发的, 并使用Lucene作为其核心来实现所有索引和搜索的功能,但是它的目的是通过简单的RESTful API来隐藏Lucene的复杂性,从而让全文搜索变得简单。根据DB-Engines的排名显示,El
翻译:索引文档中包含了一个巨大的字段java.lang.IllegalArgumentException: Document contains at least one immense term in field="responseData" (whose UTF8 encoding is longer than the max length 32766), all of which were s
Directory表示索引文件(Lucene.net用来保存用户扔过来的数据的地方)保存的地方,是抽象类,两个子类FSDirectory(文件中)、RAMDirectory (内存中)。IndexReader对索引进行读取的类,对IndexWriter进行写的类。IndexReader的静态方法bool IndexExists(Directory directory)判断目录directory是否
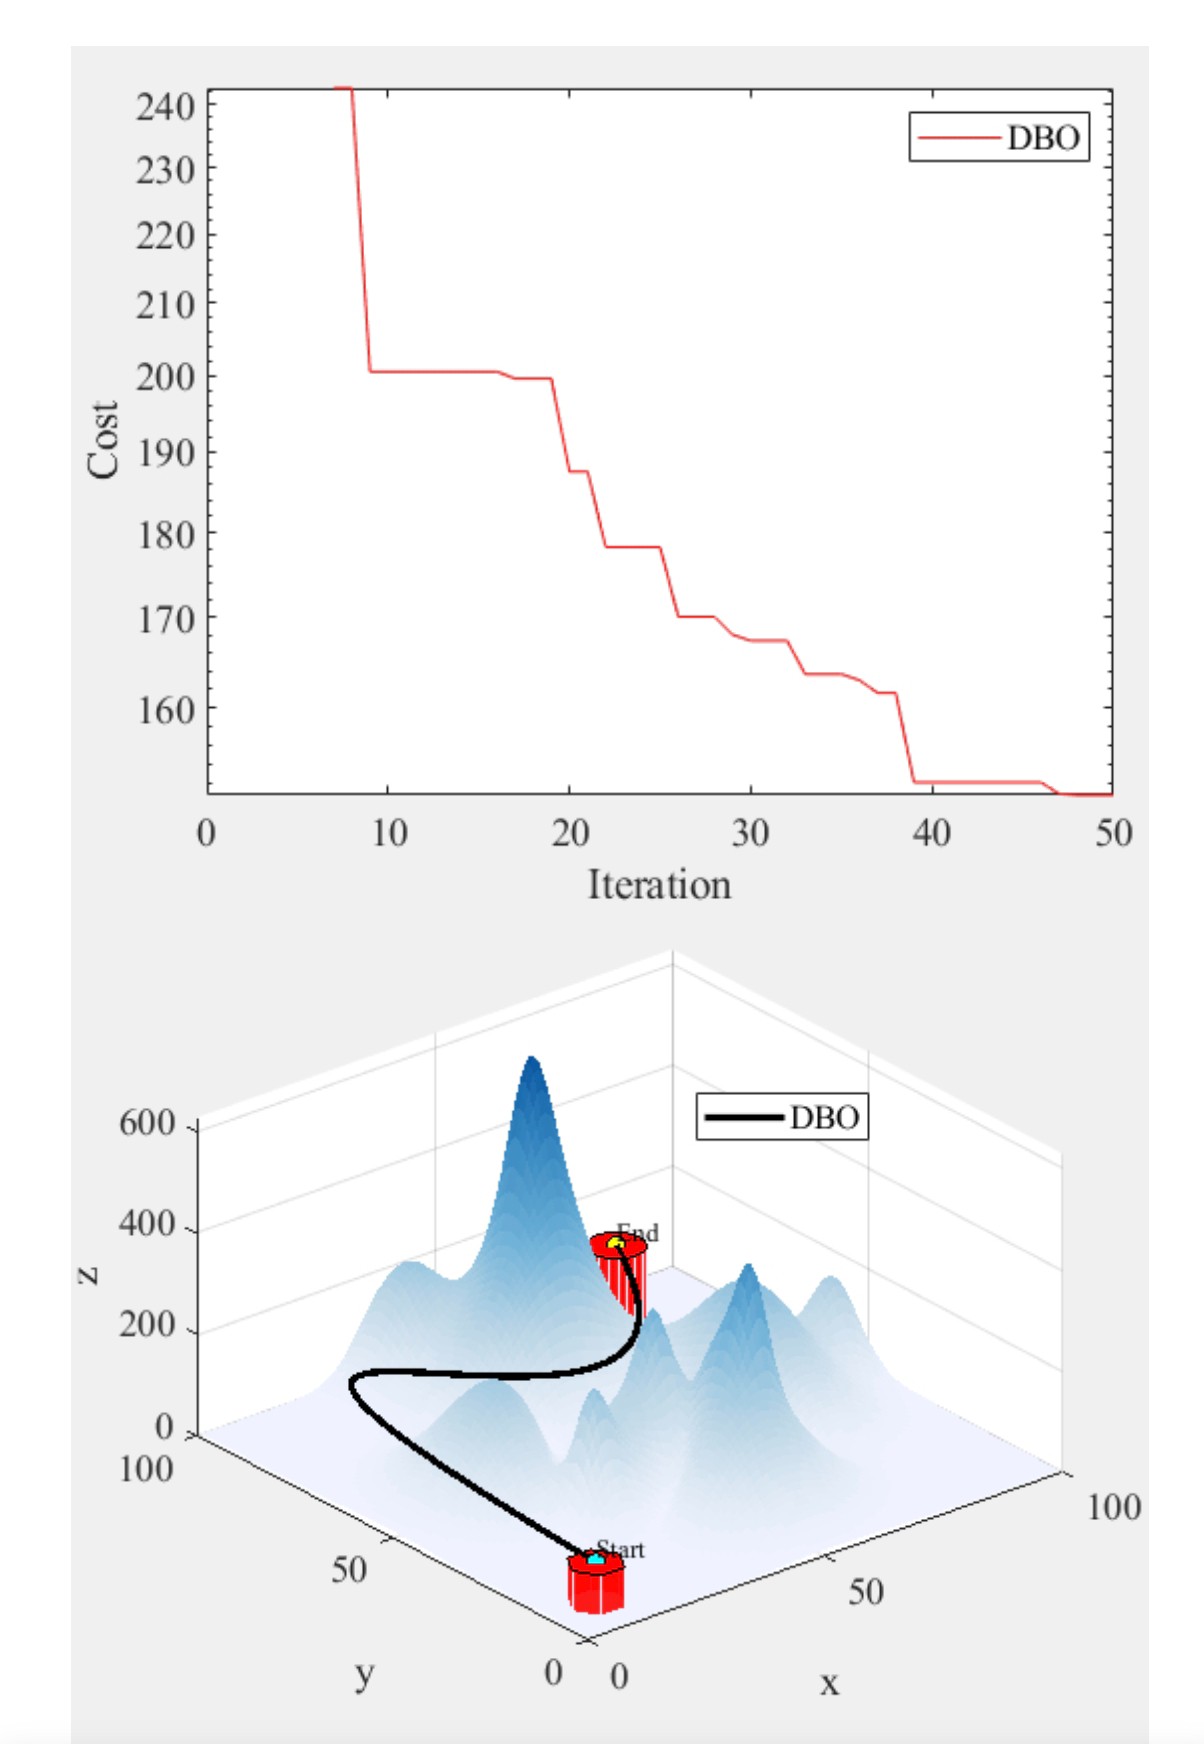
蜣螂的滚球行为用tan函数实现非线性移动,跳舞行为加入了随机扰动——这比单纯用rand函数更符合自然界中的随机性。无人机三维路径规划这活儿,说难不难,说简单也不简单。想象一下让无人机在布满障碍物的城市峡谷里穿梭,还得找条最省电的路线——这时候传统方法可能得跪,不过今天咱们聊的蜣螂优化算法(DBO)倒是有点意思。遇到过最奇葩的bug是忘记转换坐标系,结果无人机全程贴地飞行——合着这蜣螂优化出来的是扫
xwiki 关闭后重启报错
经常有小伙伴需要将互联网上的数据保存的本地,而又不想自己一篇一篇的复制,我们第一个想到的就是爬虫,爬虫可以说是组成了我们精彩的互联网世界。网络搜索引擎和其他一些网站使用网络爬虫或蜘蛛软件来更新他们的网络内容或其他网站的网络内容索引。网络爬虫复制页面以供搜索引擎处理,搜索引擎对下载的页面进行索引,以便用户可以更有效地搜索。这都是爬虫数据采集的功劳。这篇文章我总结了爬虫数据采集的说有流程,从最开始的最
数据在千万级别上进行全文检索有哪些技术?强大的大数据全文索引解决方案-ClouderaSearch
lucene
——lucene
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区






 天工造物局








 DAMO开发者矩阵
 AtomGit开源社区