- @weixin_43807749


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文翻译自langgraph官网:https://langchain-ai.github.io/langgraph/tutorials/workflows/
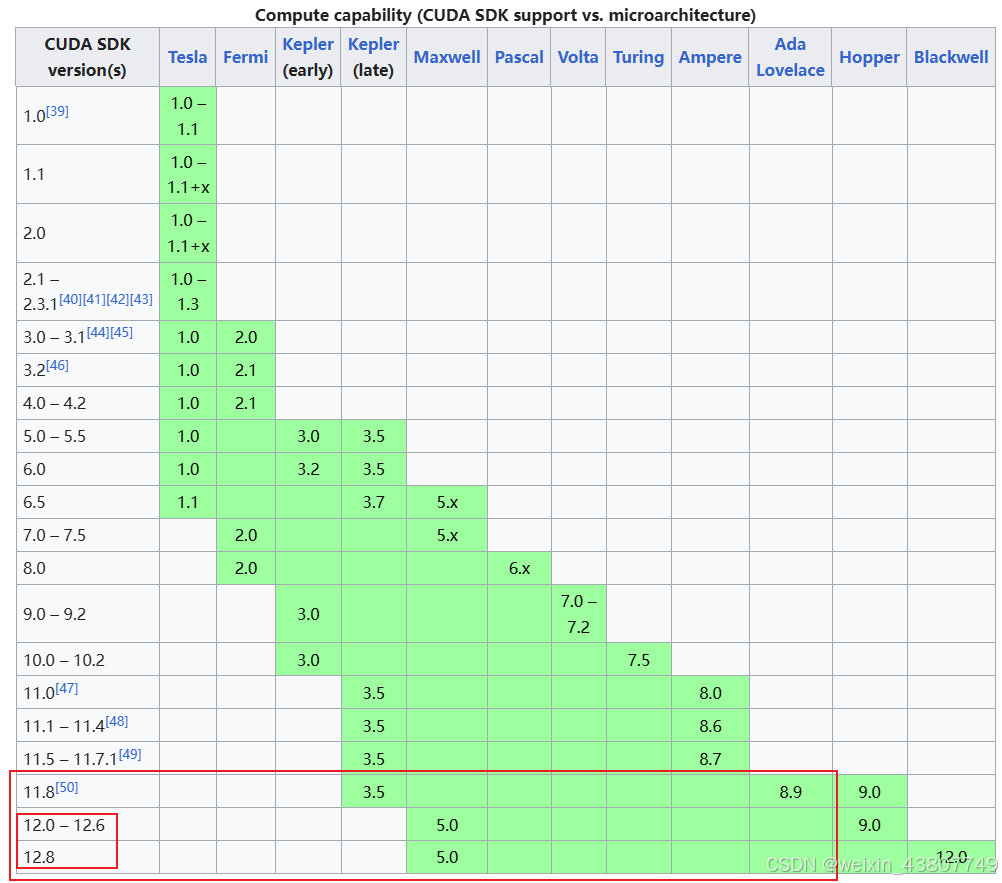
为了有效使用pytorch等深度学习工具,需要使用cuda工具。本文尝试在8张GeForce RTX 4090D的服务器上安装GPU版本的pytorch。在此之前,笔者只安装过单机单卡的cuda和torch,今天尝试安装了单机多卡的cuda和torch。简单记录一下。
本次作业要求学生从零开始构建Transformer语言模型的关键组件,包括:1)基于字节对编码(BPE)的分词器,需实现Unicode编码处理、子词切分和词汇表训练;2)完整的Transformer语言模型架构;3)交叉熵损失函数和AdamW优化器;4)支持模型保存/加载的训练循环。学生将在TinyStories和OpenWebText数据集上分别训练分词器和语言模型,最终提交模型在测试集上的困惑
在本次作业中,我们将通过基准测试和性能分析不同规模的模型,以更好地理解性能变化规律。为了直观感受规模对性能的影响,我们将使用以下模型配置。所有模型的词汇表大小均为 10,000,批量大小(batch size)为 4,仅上下文长度(context length)不同。本次作业(及后续作业)需要呈现大量表格形式的结果,我们强烈建议你通过代码自动生成报告中的表格——因为手动用 LaTeX 或 Mark

本次作业中,你将获得过滤网络爬虫数据以构建语言模型训练数据的实践经验。
代码已上传至github中,欢迎star!版本 1.0.2CS336 课程组2025 年春季在本次作业中,你将获得训练语言模型解决数学问题时进行推理的实践经验。需实现的内容对于感兴趣的同学,我们将额外设置一个可选任务——使语言模型与人类偏好对齐,该任务将于未来几天发布。需运行的内容所有作业代码及本说明文档均已上传至 GitHub,地址如下:github.com/stanford-cs336/ass
本文记录下,如何使用vLLM部署模型。安装教程参考视频教程:https://www.bilibili.com/video/BV1BijSzfEmQ/。由于vLLM只支持Linux操作系统,所以首先安装WSL2。
学习记录claude-cookbooks。今日学习:https://github.com/anthropics/claude-cookbooks/tree/main/patterns/agents。
学习记录claude-cookbooks。今日学习:https://github.com/anthropics/claude-cookbooks/tree/main/patterns/agents。
本文只用于记录,学习如何提交代码到gitee。参考文献:https://www.bilibili.com/video/BV1FE411P7B3/?