- @v_JULY_v


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
World Action Models(WAM,世界动作模型)通过来提升机器人策略学习,将未来场景演化作为对物理约束动作生成的密集监督然而,现有WAM 的一个常见设计是在推理阶段显式生成未来视频,这会带来巨大的计算开销,并阻碍其实时闭环部署具体而言混合式的动作条件世界建模(Action-Conditioned World Modeling,AC-WM)和 WAM 训练策略视觉动态视觉动态建模动作生
本文介绍斯坦福开源人形机器人ToddlerBot,其高保真数字孪生、强化学习兼容性与全栈可控设计,支持零样本仿真到现实迁移。3.4kg、0.56m,30个主动自由度,全3D打印+市售电机,BOM约6000美元,强调可复现性与机器学习适配。具备遥操作、模仿学习与全身控制能力,已实现多团队独立复现,为研究者提供低成本、易部署的类人机器人平台,助力运动与操作技能创新。

教你一步一步用c语言实现sift算法、上作者:July、二零一一年三月十二日出处:http://blog.csdn.net/v_JULY_v参考:Rob Hess维护的sift 库环境:windows xp+vc6.0条件:c语言实现。说明:本BLOG内会陆续一一实现所有经典算法。------------------------引言: 在我写的关于sift算法的前倆篇文章里头,已经对sift
推荐引擎算法学习导论:协同过滤、聚类、分类作者:July出处:结构之法算法之道引言昨日看到几个关键词:语义分析,协同过滤,智能推荐,想着想着便兴奋了。于是昨天下午开始到今天凌晨3点,便研究了一下推荐引擎,做了初步了解。日后,自会慢慢深入仔细研究(日后的工作亦与此相关)。当然,此文也会慢慢补充完善。本文作为对推荐引擎的初步...
本文提出Whole-BodyUMI(WB-UMI),一种无需额外身体追踪、基于末端执行器轨迹的实时全身运动生成框架。通过解耦任务语义学习与全身协同学习,利用重定向动作捕捉数据训练通用全身控制器,实现仅依赖UMI示范即可生成合理全身动作,显著提升人形机器人数据采集的可扩展性与效率,在多项任务中验证了其有效性与实时性。

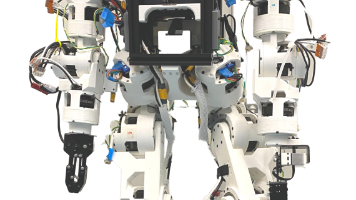
我司将于深圳设立具身机器人团队,依托本地硬件人才与供应链优势,推动低成本、模块化开源人形机器人BerkeleyHumanoidLite的落地应用。该平台采用3D打印摆线齿轮箱,整机成本低于5000美元,支持桌面级打印与广泛采购,实现易获取、可定制、全开源。项目已获江兄、kimi等开发者推荐,欢迎敢想敢干者加入,共同推进具身智能教育与研发。杭州办公室将延后建设。
ENPIRE提出一种面向编码智能体的自主机器人策略自进化框架,通过两个阶段实现真实世界无干预学习:第一阶段基于人类示范自动构建含安全约束、自动验证与复位机制的环境接口(EN);第二阶段由编码智能体驱动,基于真实反馈迭代优化策略与训练算法(PIRE),支持多智能体并行协作与代码自演化。该系统将物理世界学习转化为可扩展的自动化研究闭环,显著降低人工参与,提升资源利用效率,推动灵巧操作技能的自主获取。
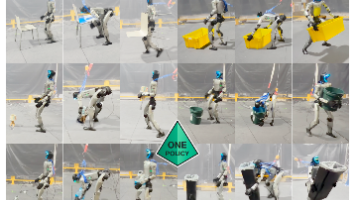
PRISM提出“真实到仿真再到真实”的框架,通过视频到视频生成技术,将少量真实人-物交互视频扩展为256段多样化的反事实视频,涵盖不同物体类别与配置。结合接触锚定的重建与重定向方法,将不完美的单目重建优化为物理合理的人形机器人轨迹,并训练出仅依赖机载深度观测的零样本策略。该策略在真实机器人上成功实现对箱、桶、球等未见物体的抓取、搬运与放置,验证了跨类别泛化能力,突破了高质量示范数据采集的瓶颈。
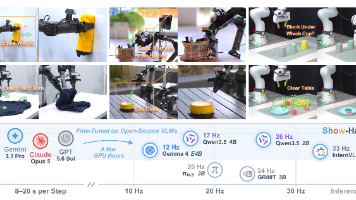
Show-Harness提出一种具身控制接口,使基础视觉-语言模型(VLM)可通过离散语义动作单元直接操控机器人,实现零样本部署与轻量级模型微调下的高效控制。该框架将语义推理与确定性物理执行解耦,支持跨任务、跨具身形态的泛化,并引入GUMI GUI操作界面,实现无需专用硬件的人机协同示范采集,统一了智能体与人类在语义空间中的操控能力。
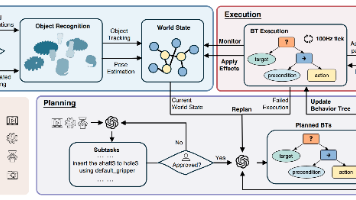
本文提出Video-to-BT框架,融合视觉-语言模型(VLM)与行为树(BT),实现从人类示范视频自动生成可反应、可解释的装配任务规划。该框架将高层认知规划与低层实时控制无缝集成:VLM解析视频并分解为子任务,生成结构化行为树;执行中结合实时感知动态调整,失败时触发VLM驱动的重规划。通过“人类在环”设计,系统兼具灵活性、鲁棒性与易用性,显著提升机器人在动态环境中的泛化能力与自主性。