


- @Richard_Kim


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文资源:链接:https://pan.baidu.com/s/1my30wyqOk_WJD0jjM7u4TQ提取码:xxe0--来自百度网盘超级会员V1的分享中文都讲完了,英文没有什么好说的,相关的理论知识可以看之前的博客中文词向量:word2vec之skip-gram实现(不使用框架实现词向量模型)_Richard_Kim的博客-CSDN博客中文词向量:使用pytorch实现CBOW训练_Ri
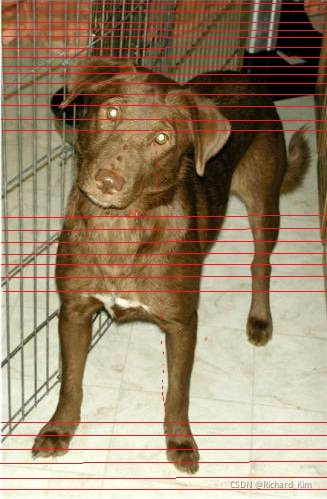
和CNN不同的是,RNN用于前后具有相关联性质的序列的。所以这里我们只能把每幅图像横向剪切,每一行当成一列。如下图所示:每个横向的像素作为序列。然后输入到RNN模型中。由于考虑到数据过大,所以先使用了CNN对其进行处理,CNN层会输出一个16*16*53*53的矩阵。RNN模型的超参数BATCH_SIZE = 32 # 每批处理的数据DEVICE = torch.device('cuda' if
与RNN一样,输入也是三个维度,由于之前RNN先使用了CNN进行过滤,这次LSTM模型不使用CNN过滤,直接把所有向量放入训练。如下图,没有和RNN一样使用三层卷积层。定义超参数BATCH_SIZE = 32 # 每批处理的数据DEVICE = torch.device('cuda' if torch.cuda.is_available() else 'cpu')EPOCHS = 15 # 训练数

前面的自己设计的模型出现了过拟合现象,训练集准确度高达95%,但是测试集准确度惨不忍睹63%左右。使用交叉熵作为loss,模型采用resnet50,使用预训练模型,我在调试的过程中,使用预训练模型可以快速得到收敛好的模型,使用预训练模型将pretrained设置为True即可。更改最后一层的全连接,将类别设置为2,然后将模型放到DEVICE。优化器选用Adam。代码有详细的注释就不说过程了。没有出
整个项目和使用说明地址:链接:https://pan.baidu.com/s/1my30wyqOk_WJD0jjM7u4TQ提取码:xxe0关于词向量的理论基础和基础模型都看我之前的文章。里面带有论文和其他博客链接。可以系统学习关于词向量的知识。之前已经使用numpy手动实现skip-gram,现在使用pytorch框架实现CBOW这是pytorch官网的C...
代码中使用的语料:链接:https://pan.baidu.com/s/1nu_TqPtstB8brL2jJ-WtAg提取码:nwdo之前讲了中文的词向量如何训练,这里说说英文的,英语比中文简单多了,也不会有乱码问题,所以这里直接贴出代码。怎么跑起来可以看之前的文章#!/usr/bin/endimension python# -#-coding:utf-8 -*-# author:by ucas
理论部分有空再写..全部实现实践代码环境: pytorch1.3.1; sklearn;tqdm训练语料:链接:https://pan.baidu.com/s/1Pa42E2q9fZ2zXLJ7vLvx8g提取码:o2rg--来自百度网盘超级会员V1的分享项目结构:#!/...