登录社区云,与社区用户共同成长
邀请您加入社区
大模型检索增强生成(RAG)的技术原理与架构设计一、检索增强生成的基本思想二、RAG 系统的核心架构三、检索质量的关键影响因素四、知识融合与可信生成五、工程落地中的常见挑战#大模型 #RAG #人工智能 #具身智能。
kooPage迁移学习把在大规模数据集(如 ImageNet)上预训练好的模型权重搬过来,只针对目标任务重新训练部分或全部层。它解决的是三个现实问题:目标数据集样本少、从零训练成本高、小数据上从零训练容易过拟合。MindSpore 提供了完整的权重加载与参数冻结接口,配合昇腾 NPU 可以在很短时间内完成一次微调。本文基于图像分类任务,讲解特征提取与微调两种做法的选择依据、预训练权重的正确加载方式
具身智能:让人工智能拥有物理世界感知能力一、具身智能的核心思想与理念起源二、具身智能系统的三大组成环节三、具身智能的典型应用方向四、具身智能发展的主要难点五、具身智能的长期演进趋势#具身智能 #人工智能 #大模型 #世界模型。
如果每个页表项占4字节,单单这一张“一级页表”就需要占用 **4MB** 的物理内存。这个“美丽的谎言”,就是由操作系统的**内存管理单元(MMU)** 配合**页表(Page Table)** 共同编织的。每个进程都活在自己独立的**虚拟地址空间**里,以为自己拥有整个王国。而内核,则是一位冷静的“物业管理员”,通过页表这张地图,将虚拟地址精准地映射到真实的**物理页框(Page Frame)*
Linux 内核移植主要涉及基于 linux 内核基线合入三方芯片补丁后,进行基础的内核编译构建及验证。
迁移学习是机器学习的重要分支,旨在将已学知识应用于新领域,提升模型泛化能力与学习效率。其核心原理在于识别并迁移不同任务间的共享特征与模式。在软件工程领域,这一技术价值巨大,能有效解决代码生成智能体面临的“冷启动”与“领域壁垒”难题。通过构建分层的记忆抽象(如语法模板、设计模式、调试策略),并结合向量检索与知识图谱技术,智能体可将在一个项目(如Java Spring Boot)中习得的架构理解、业务
具身智能环境交互与学习范式原理一、具身智能交互的本质:行动带来环境状态变化 二、强化学习范式:试错学习的底层原理 三、模仿学习范式:从演示行为提取策略原理 四、虚实迁移学习:模拟器预训练到真机微调原理 五、交互学习范式的整体能力局限 #具身智能 #大模型 #世界模型 #人工智能。
最近在调试车间里折腾S7-200PLC控制的苹果分拣机,这玩意儿特别有意思。传送带上的苹果经过光电传感器时,PLC要快速判断大小和颜色,再指挥气缸把不同等级的苹果推到对应筐里。重点设置好PLC通信参数,在设备窗口里选Siemens PPI协议,站地址必须和PLC里设置的保持一致。曾经有次调试死活连不上,最后发现是波特率设成了187.5k而实际PLC是9.6k,这点要特别注意。带解释的梯形图程序,接
摘要:本文详细介绍了基于BERT的中文掩码语言模型(MLM)实现过程。主要包括:1) 使用Hugging Face的BertTokenizer和BertModel加载预训练模型;2) 自定义数据预处理函数collate_fn2,构建包含[MASK]的输入序列和对应标签;3) 设计包含线性输出层的MyModel模型架构;4) 采用AdamW优化器和交叉熵损失进行模型训练;5) 实现模型评估流程。关键
详细介绍什么是Model、Model的基本使用方法,以及一个文本分类的实例。
详细讲解Hugging Face的evaluate库,以及evaluate的使用,并使用evaluate库来优化文本分类实例的代码。
详细解释Hugging Face的trainer库的使用,以及对文本分类的代码实例进行优化。
详细讲解huggingface的Datasets的使用,以及对文本分类代码进行改进。
支持将vmware虚机迁移至kvm平台,支撑国产化替换计划。
由于要写相关的论文,仅仅只能做到训练和识别是远远不够的,必须有相关的训练过程的数据和图片来说明问题,所以我又又又写了篇关于迁移学习的文章,主要是更换了神经网络模型和增加了训练可视化这个模块,将SGD优化器更改成了Adam优化器,且使用ReduceLROnPlateau进行学习率的自适应调整。
1 迁移学习1.0 简介图1.0 迁移学习迁移学习是机器学习研究的课题,在机器学习中集中于依据习得的知识解决不同但相关的问题;即用已知去解决未知(相关);1.2 迁移学习分类(1) 使用模型结构,不利用模型权重,重新训练数据,输出训练模型图1.2 仅利用模型结构重新训练当新的任务与现存的模型任务差距较大时,可借鉴模型结构,重新进行训练,以达到较优的效果,如图1.2中的摩托车和肿瘤...
本文详细介绍了SPyNet预训练模型在光流估计和视频超分辨率任务中的迁移学习技巧。通过解析SPyNet的网络结构、预训练权重加载方法,以及如何将其迁移到视频超分任务中,帮助开发者高效利用SPyNet进行多尺度运动信息处理。文章还提供了分层学习率策略、渐进式解冻等实用技巧,并展示了与EDVR集成的实战案例。
读取图像(假设路径在csv第0列)img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB) # 转为RGBimg = cv2.resize(img, (224, 224)) # 统一尺寸img = img.transpose((2, 0, 1)) # (H,W,C) → (C,H,W),适应PyTorchlabel = (label + 1) / 2 # 假设原始标签为
本文以Kaggle经典竞赛“Dogs vs. Cats”为例,详细介绍了深度学习图像分类的完整实战流程。内容涵盖数据准备、预处理与增强、基于ResNet等预训练模型的迁移学习、训练调参技巧以及集成学习等进阶优化方法,旨在帮助读者系统掌握计算机视觉项目实践,并冲击更高分类准确率。
这是一个。
【深度学习|迁移学习】原型引导领域感知渐进表示学习中的“原型”指的是每个类别在特征空间中的中心点,通常表示为该类别的类别原型(prototype)
在迁移过程中,可能需要根据实际情况调整迁移脚本中的选项。例如,如果需要迁移的数据表中包含存储过程、触发器等,可能需要添加相应的选项来处理这些对象。非必须步骤, 可以直接使用命令。
有一种方法如下图所示,我们有许多无标签的数据,它们经过Feature Extractor和Label Predictor后,不知道属于哪个类别,但希望离边界越远越好,离边界远的意思就是输出的结果非常集中,集中在某一个类别上,离边界近的意思是输出的结果的每一个类别都非常接近,不知道属于哪类。假设我们在训练集上训练黑底白字的手写数字集后(如下图),再把它用在同样是黑底白字的测试集上所得到的效果非常好(
近期,昆山杜克大学在语音旗舰期刊 IEEE/ACM Transactions on Audio, Speech and Language Processing (TASLP)上发表了一篇题为“Leveraging ASR Pretrained Conformers for Speaker Verification Through Transfer Learning and Knowledge Di
知识蒸馏基本知识点
在本文中,我们提出了自我注意生成对抗网络(Self-Attention Generative Adversarial Network, SAGAN),该网络允许对图像生成任务进行注意力驱动的长期依赖建模。在SAGAN中,可以使用所有特征位置的线索来生成细节。此外,该鉴别器还可以检查图像远处部分的高细节特征是否一致。我们将光谱归一化应用于GAN生成器,并发现这改善了训练动力学。提出的SAGAN比之前
最小类混淆,不需要领域对齐,即可实现域适应,即一种方法可以在不做任何修改的情况下处理多种不同的适应场景,因此提出一个通用的损失函数--MCC,另外,还是用MCC作为一种通用的正则化方法,与现有的多种DA方法互为正交和互补,加快了收敛速度。...
场景识别与物体分类不同,它依赖墙面、光照、空间排布等全局语义,而非局部目标。传统手工特征在MIT67等数据集上仅能达55%左右,而深度卷积网络通过层级特征将精度推至80%以上。深度学习的技术价值在于自动提取从边缘到布局的多层特征,并通过迁移学习利用ImageNet预训练权重快速适配新场景。实际工程中,常以ResNet50为主干,在MATLAB和Python双工具链中完成数据准备、模型搭建、训练调参
Sim2Real,即仿真训练完成的强化学习策略,直接部署到真实物理机器人上执行行走动作;
感知层图像编码器,几乎所有视觉机器人标配,不输出动作;操作任务动作生成主干,Diffusion Policy-CNN 核心,适合双臂 / 灵巧手接触操作;不适合人形全身步态;开源首选:LeRobot + Diffusion Policy 1D U-Net;数据集直接导入动捕 BVH 转换的时序数据。
四足、人形:接收根姿态、IMU、关节角度、关节角速度、目标速度指令;在 IsaacLab/IsaacGym 仿真里对质量、惯性、摩擦、关节阻尼做随机,训练 MLP 策略,提升 Sim2Real 迁移,是四足 / 人形标配。MLP 只接收低维向量(本体状态、关节、根姿态、角速度、目标指令),输出机器人 PD 目标位置 / 力矩 / 关节动作;把复杂策略(Transformer/Diffusion)的
LeRobot 是 Hugging Face 为机器人模仿学习设计数据集规范,用于存储机器人遥操作 demo,包含多模态:关节状态、末端位姿、RGB / 深度图、触觉、动作指令、标注文本。可以存放:时序关节、末端位姿、图像路径、奖励、标签、多模态数据打包在一个对象内。遥操作采集常用,可以录制 joint state、图像、tf、力控数据。二进制 GLB / 文本 GLTF,用于仿真场景 + 骨骼动
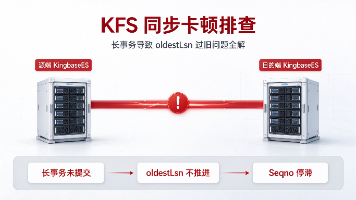
金仓社区精华|DigitalObserver运维笔记:某省级政务平台在鲲鹏920+麒麟V10环境下,因长事务导致KingbaseES的KFS同步卡顿,表现为Seqno与Events停滞。根因分析显示,长事务锁定oldestLsn,阻塞日志解析。解决方案包括:紧急重启、部署心跳表防卡顿、设置15分钟无变化告警,并推动新版本升级及事务管理规范优化。关键经验:保留jstack现场优先,心跳机制低成本有效
迁移学习通过复用预训练模型加速训练并提升性能,尤其在数据稀缺时有效。传统深层网络面临梯度消失/爆炸与退化问题,ResNet通过残差连接实现恒等映射,缓解梯度问题并防止性能下降。结合BatchNormalization稳定输入分布、加速训练并增强泛化。迁移学习步骤包括:选择预训练模型、冻结部分参数、训练新增层、微调特定层,并评估优化效果。
本文基于PyTorch,使用预训练ResNet18模型实现食物分类任务,通过迁移学习技术显著提升小数据集下的分类性能。核心步骤包括:加载ImageNet预训练权重、冻结卷积层参数、替换全连接层为20类输出,并仅训练新层。结合数据增强与学习率调度,实现高效训练。该方法在参数量少、数据有限的情况下仍可获得高准确率,充分体现了迁移学习在图像分类中的优势。
本文介绍了如何在本地环境中部署和使用ollama与vLLM两大开源大模型框架。ollama适合本地开发和小规模部署,提供简单命令管理Llama2等主流模型;vLLM则专注于生产环境的高并发需求,兼容OpenAI API协议。文章详细讲解了两种框架的安装配置方法(curl安装ollama,pip安装vLLM),并提供了Python客户端实现代码示例,包括统一调用封装的设计方案。最后给出了优化建议:o
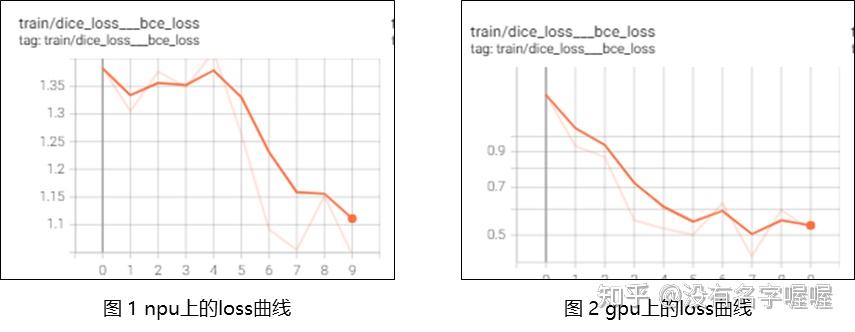
npu在这里丢了image_embedding的梯度,因为该模型用到了Reg_op(RepeatInterleaveGrad)这个算子,接下来分析cann包是否有这个算子 发现是有的 但是通过进入python后调用torch_npu.repeat_interleave_backward_tensor这个函数,发现调用失败。功能说明:停止精度数据采集,在 start 函数之后的任意位置添加,若需要
摘要:未来十年,仿真测试工程师的角色将发生结构性转变,从单纯的功能验证者逐步演变为智能系统的治理者和决策者。第一阶段(2025-2027)聚焦功能测试;第二阶段(2027-2030)转向风险发现与系统分析;第三阶段(2030-2035)工程师将获得对智能系统的否决权,成为责任锚点和"人类良心接口"。这一演进要求工程师兼具技术能力、风险判断和社会伦理意识,最终目标是成为"
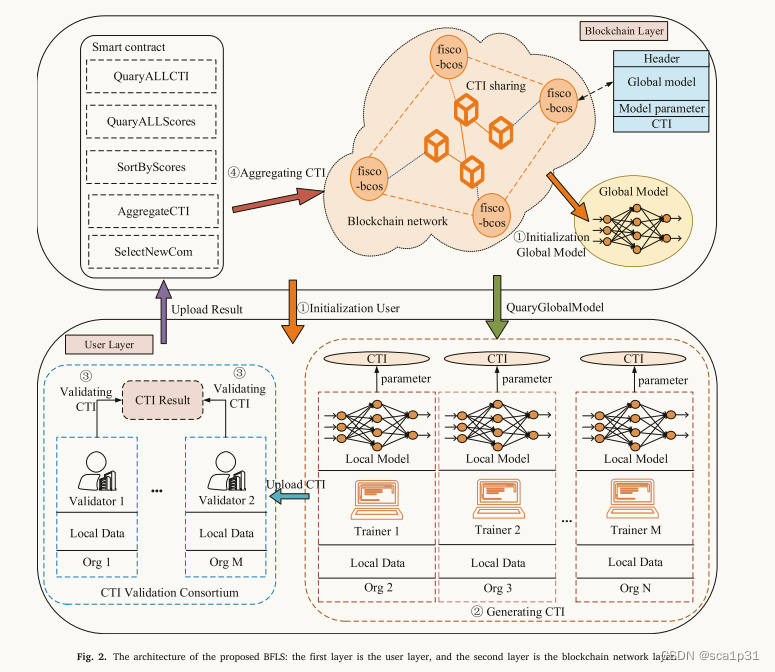
这篇论文核心也是联邦学习与区块链技术的结合,应用场景放在了CTI共享中。文章将深度学习的恶意流量检测模型的参数视为CTI,使用联邦学习进行共享,从情报共享的角度来进行文章的书写。那么在introduction与related work中就可以对CTI领域的研究进行概括总结,介绍自己的工作并进行对比,突出自己工作的创新与优点,并且形成一个表格进行清晰地对比。(从中我们可以学习到,我们如果做类似的工作
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档论文分享(4)---- OPTIMIZATION AS A MODEL FOR FEW-SHOT LEARNING摘要一、问题定义二、Model1. 模型定义2. 模型参数共享和预处理3. 梯度更新简化总结摘要尽管深度学习在数据量充足的领域已经取得了很大的成功,但是它们很难在数据量匮乏的情况下发挥。这是因为现有的优化策略都是基于梯度进
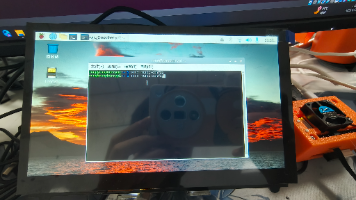
本文详细记录了作者作为新手将树莓派系统移植到嘉立创泰山派开发板的完整过程。文章分为四个部分:首先介绍系统烧录步骤,包括下载镜像、使用瑞芯微工具烧录等;其次说明泰莓派初始化设置,包括WIFI连接和基础配置;然后讲解如何通过SSH和VNC实现远程终端访问;最后介绍远程桌面连接方法。作者在移植过程中遇到诸多困难,通过参考开源文档和CSDN教程最终成功完成移植,并希望通过本文完善移植步骤,帮助其他新手玩家
通过从大型的教师模型向小型的学生模型转移知识来实现模型压缩和优化。
微信小程序主体变更(迁移)法人无法配合扫脸怎么办?
本文基于 PyTorch 完成一个完整的 20 类食物图像分类实战项目,涵盖自定义 CNN 搭建与训练、学习率调度器(ReduceLROnPlateau / StepLR)调优、ResNet18 迁移学习微调、以及最优模型权重加载推理的全流程。从卷积尺寸计算、自定义 Dataset、数据增强与 ImageNet 归一化等核心知识出发,配套完整可运行代码与常见问题排查指南,帮助深度学习初学者快速打通
提出了一种深度生成先验(DGP)方法,能够在保持生成先验的同时很好地重建,当在任务相关的观测空间中重构被破坏的图像时,DGP倾向于恢复缺失的信息,同时保持已有的语义信息不变。
通用句子编码器是google在2018年提出的将句子编码成嵌入向量的模型,这些嵌入向量专门针对将学习转移到其他NLP任务。文章中指出,对于许多NLP任务,可用的训练数据有限。这对数据饥渴的深度学习方法提出了挑战。由于注释有监督的训练数据的成本很高,对于大多数研究或行业NLP任务,通常无法使用非常大的训练集。许多模型通过使用隐式执行有限的迁移学习来解决如word2vec,Glove等,都有不错的效果
本文主要的思路是区别对待域迁移和个体迁移。对于域的迁移使用cycleGAN,对于个体的迁移使用pixel level histogram,最后再使用identity loss来进一步保留个人特征。最大的特色就是引入了cycleGAN和pixel level histogram。整体结构很简单,就是把原始图和参考图一起丢到generator中,让generator对调两个图像之间的妆容。然后再将两张
迁移学习
——迁移学习
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 人工智能6S服务平台

 openEuler 社区


 乐奇 Rokid 开放社区




 火山引擎视频云技术社区




 鲲鹏昇腾开发者社区
 亚马逊云科技技术品牌专区



 天工造物局