登录社区云,与社区用户共同成长
邀请您加入社区
要在旧安卓手机上通过Termux配置环境并部署OpenList-Mobile作为私人文件服务器,核心步骤包括:准备设备、安装配置OpenList-Mobile、挂载手机内置存储、以及通过cpolar实现公网访问。以下是详细操作流程。
最近在知乎上看到一个不错的GAN的入门案例,于是稍微修改了一下后分享出来!我们都知道GAN主要用来生成,相比于生成图片,我们这次选择更为简单的生成一个一维函数来大致了解GAN的流程及代码实现。我们的原始数据为y = 2x^2 + 1,我们让GAN来生成与之接近的分布! 代码:结果:可以看到我们生成的结果还是不错的! 参考资料:......
视频超分辨率作为底层视觉的重要方向,通过生成对抗网络(GAN)从低分辨率视频序列中重建高细节帧,已成为影视修复、安防监控等领域的关键技术。TecoGAN 作为代表性的视频超分模型,其核心思路是引入光流与时间循环约束,保证输出帧之间的时间一致性,从而避免闪烁和伪影。实际应用时,模型依赖 TensorFlow 与 CUDA 的特定版本搭配,如 Python 3.7 + TensorFlow-gpu 1
在电子领域的神秘世界里,本征参数如同隐藏在深处的神秘宝藏,它们蕴含着器件最本质的特性密码。而 S 参数,则像是连接现实与这些神秘宝藏的桥梁,通过它,我们得以一窥器件在不同频率下的 “行为举止”。但有时候,这座桥梁会被一些 “迷雾” 所笼罩,导致我们无法准确地找到宝藏。这时候,就需要一种神奇的 “魔法”—— 去嵌技术,来驱散这些迷雾,让我们能够清晰地看到宝藏的真实面貌。不过,要是不小心弄丢了去嵌的
本文介绍了基于ESRGAN的图像超分辨率技术实现。首先阐述了图像超分辨率的定义、应用场景和主要挑战,包括细节恢复、计算效率和数据获取等问题。然后详细讲解了ESRGAN的理论基础,包括生成对抗网络、感知损失和对抗损失等核心概念。在代码实现部分,提供了完整的PyTorch实现方案,涵盖数据预处理、生成器和判别器模型构建、对抗训练过程以及评估方法。通过结合感知损失和对抗损失,ESRGAN能够生成高质量的
介绍几种主流的基于深度学的图像压缩技术
本文深入探讨了深度学习在多媒体处理中的应用,重点分析了卷积神经网络(CNN)、深度信念网络(DBN)、生成对抗网络(GANs)、长短期记忆网络(LSTM)、多层感知器(MLP)网络、循环神经网络(RNNs)、残差网络(ResNets)、支持向量机(SVMs)、深度神经决策树(DNDT)以及胶囊网络(CapsNets)等架构。通过理解这些先进模型的工作原理和应用场景,我们可以更好地把握深度学习技术在
自动编码器(Autoencoder)是一种神经网络模型,通过将输入数据编码为低维表示,再从低维表示解码重构原始数据。自动编码器的目标是使重构数据尽可能接近原始数据,从而实现数据降维和特征提取。在本篇文章中,我们深入探讨了自动编码器的基本概念,并通过实际代码示例展示了如何使用Deeplearning4j实现自动编码器。自动编码器是深度学习领域中一个重要且广泛应用的模型,掌握这些技术能够显著提升你的项
EfficientGAN代表了机器学习领域在追求高质量图像生成与计算效率之间平衡的一次重要尝试。它不仅展示了如何通过创新的网络设计和训练策略,实现轻量级模型的高性能表现,也为实际应用中的资源优化提供了宝贵的思路。尽管在某些极端场景下,EfficientGAN可能无法完全匹敌专为特定任务设计的大型模型,但它在广泛的应用领域内展现了极高的实用价值。总之,EfficientGAN不仅是当前机器学习图像生
过去十年的演进,是将推荐系统从**“为了点击率而不择手段的算法”重塑为“赋能全球数字化决策、具备内核级隐私保护与复杂逻辑理解能力的智慧引擎”**。你在纠结如何让模型分清“用户买过一次尿布,不代表他这辈子都要看尿布广告”。你在利用 eBPF 审计下的生成式推荐系统,看着它在内核层静默地保护着你的隐私,同时为你精准生成了一份未来一周的健康饮食方案。
GAN(生成对抗网络)是由Ian Goodfellow等人于2014年提出的深度学习模型,通过生成器和判别器的对抗训练实现高质量数据生成。该模型由生成器(生成伪造数据)和判别器(鉴别真伪)组成,采用零和博弈优化策略。广泛应用于图像生成、超分辨率、风格迁移等领域,衍生出DCGAN、WGAN、StyleGAN等变体。训练中需应对模式崩溃、不稳定性等挑战,常用FID、IS等评估指标。当前研究聚焦多模态生
HiFi-GAN(High-Fidelity Generative Adversarial Network)是由Jungil Kong、Jaehyeon Kim和Jaekyoung Bae等人提出的一种新型语音合成模型。作为生成对抗网络(GAN)在语音合成领域的创新应用,HiFi-GAN在保证高音质的同时,大幅提高了语音生成的效率。HiFi-GAN作为一种高效、高保真的语音合成模型,为语音技术的发
生成对抗网络(GAN)作为一种强大的深度学习模型,通过生成器和判别器的相互对抗进行学习,展示了在多个领域的广泛应用潜力。尽管GAN的训练过程存在不稳定性、评估困难等挑战,但随着研究的深入和技术的不断发展,相信GAN将在更多领域发挥重要作用,推动人工智能技术的进一步发展。未来,随着计算资源的不断提升和模型结构的持续优化,GAN的性能和应用范围将得到进一步提升和拓展。
所以在进行对抗训练的时候,只能在有限的训练集的分布中找到对抗样本,然后根据经验将训练集的分布替代整个数据集的分布,这样的分布是不完整的,所以在测试集中不能有好的表现,而如果我们学习整个数据集的真实分布Pdata,那我们就可以训练出一个既适用于训练集,也适用于测试集的分类器,这样的分类器鲁棒性自然而然就提高了)我们可以想象成输入的数据是三维的,但真正表征这个数据的核心特征就是一个二维的,其余的都是维
本文提出了一个具有双阶注意力模型的生成对抗网络来检测和定位复制移动伪造。 在生成器中,一阶的注意力模型用于捕捉 copy-move 对象的位置信息;二阶的注意力模型用于探索更多的 patch 一起共同出现的具有判别性的特征信息。这两个注意力图都是从亲和矩阵中提取的,并用于融合位置感知和共现特征,用于网络的最终检测和定位分支。 判别器网络的设计是为了进一步保证更准确的定位结果。 据我们所知,我们是第
【代码】读论文|利用GAN生成三维点云WarpingGAN: Warping Multiple Uniform Priors for Adversarial 3D Point Cloud Generation。
在本文中,我们提出了自我注意生成对抗网络(Self-Attention Generative Adversarial Network, SAGAN),该网络允许对图像生成任务进行注意力驱动的长期依赖建模。在SAGAN中,可以使用所有特征位置的线索来生成细节。此外,该鉴别器还可以检查图像远处部分的高细节特征是否一致。我们将光谱归一化应用于GAN生成器,并发现这改善了训练动力学。提出的SAGAN比之前
什么是GAN?2014年,Goodfellow等人提出了一种生成模型训练方法,简称生成对抗网络(generative Adversarial Networks,简称GANs)。在GAN中,我们构建两种不同的神经网络。我们的第一个网络是传统的分类网络,称为鉴别器。我们将训练鉴别器来拍摄图像,并将其分类为真实(属于训练集)或虚假(不存在于训练集)。我们的另一个网络称为生成器,它将随机噪声作为输入,并使
瑞萨电源产品组合可与其领先的MCU、MPU、SoC和模拟解决方案无缝搭配,并通过数百款经过工程验证的成功产品组合,以及PowerCompass™和PowerNavigator™设计软件等创新工具,简化并加速设计流程。基于瑞萨近期扩展的低压增强型GaN技术平台,全新晶体管产品组合具备超高速GaN开关能力,并通过低总栅极电荷(Qg)和低输出电荷(Qoss)最大限度减少电压与电流重叠,从而降低AI电源单
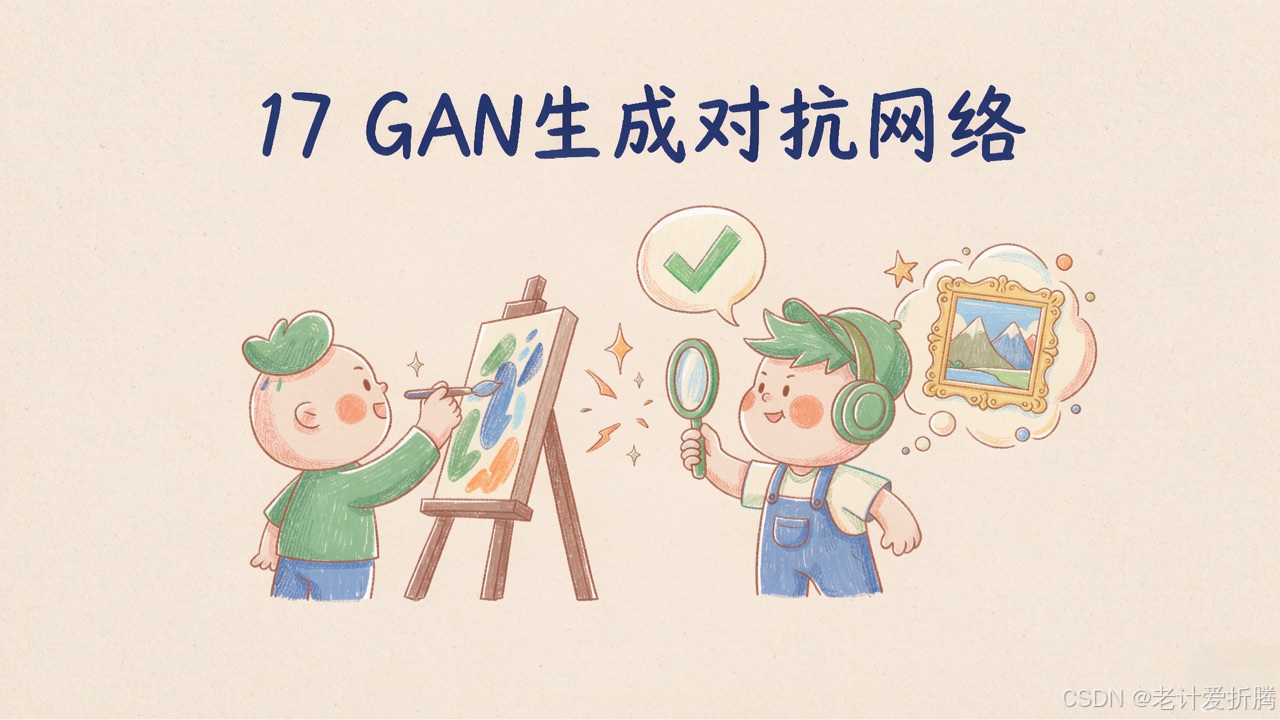
从这篇起进入生成式AI。GAN有个绝妙的设计,让两个网络互相较劲,一个拼命造假、一个拼命鉴假,在这场猫鼠游戏里双方越来越强,最终造假的能生成以假乱真的图片。这篇用大白话讲透造假者和鉴别者的博弈、为什么这个对抗能让模型学会创造、输入输出,配可跑代码,并聊它的贡献和难训练的坑。
在设计时对微信客户端进行了充分的了解,掌握微信平台通过的接口,同时系统采用Java技术进行开发,MySQL数据库进行数据的储存,充分的保证了系统的稳定性、安全性,基于微信平台的在线答题小程序实现了客户端和服务器端两部分,实现了在线答题相关信息的查询管理功能。微信是目前国内使用最多的社交软件之一,有庞大的用户群体,便于调查者获取不同年龄段不同层次和地方的市场情况和用户需求,而且利用微信小程序调查,用
生成对抗网络(GAN),变分编码器(VAE)
深度生成模型(Deep Generative Model)---生成对抗网络Generative Adversarial Networks(GANs)
GANs生成对抗网络简述
本文介绍了如何在本地环境中部署和使用ollama与vLLM两大开源大模型框架。ollama适合本地开发和小规模部署,提供简单命令管理Llama2等主流模型;vLLM则专注于生产环境的高并发需求,兼容OpenAI API协议。文章详细讲解了两种框架的安装配置方法(curl安装ollama,pip安装vLLM),并提供了Python客户端实现代码示例,包括统一调用封装的设计方案。最后给出了优化建议:o
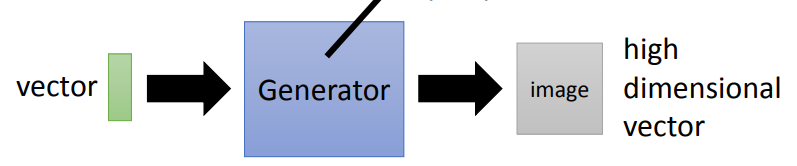
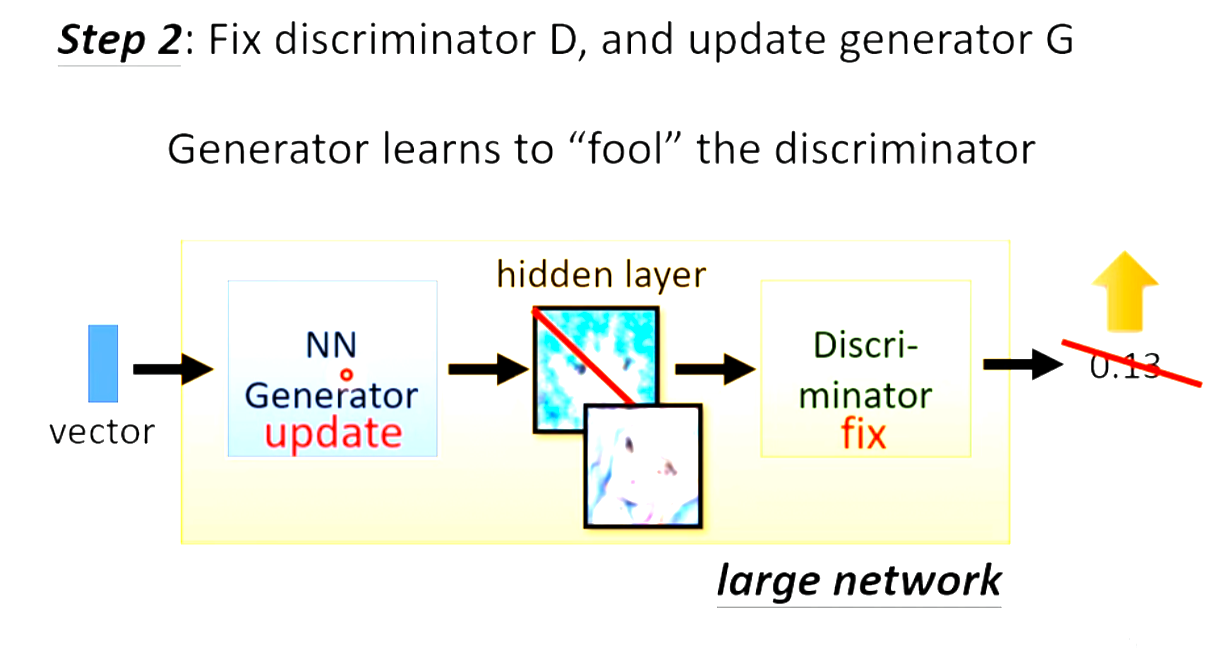
之前的network只是一个函数,给一个输入,他给出一个输出。现在的这个输入有一个随机的东西拼接,导致了同样的输入有多种可能的输出。generator AND discriminator(发生器和鉴别器)第一步:发生器生成一些图片,鉴别器用来鉴别这些图片的相似处。二者是对抗的关系。第二步:调节generator,使得discriminator的分数输出的越大越好。第三步:反复执行找一组genera
生成对抗网络(Generative Adversarial Networks, GANs)
从Deepfake到AI艺术创作,GAN正在重塑内容生成的边界。尽管存在训练挑战,但其潜力在医疗、娱乐、工业等领域的应用前景广阔。
经典文章GAN解读,建议配合李沐老师视频食用
我们的目标是共同推理和预测一个场景中所有智能体的未来轨迹。我们假设我们接收到一个场景中所有人的轨迹作为输入,X = X1, X2,…, Xn,并同时预测所有人未来的轨迹,Y = Y1, Y2,…Yn。行人的输入轨迹i定义为Xi = (x ti, yt i),从时间步长t = 1,…, tobs,和未来的轨迹(地面真相)可以类似地定义为Yi = (x ti, yt i),从时间步长t = tobs
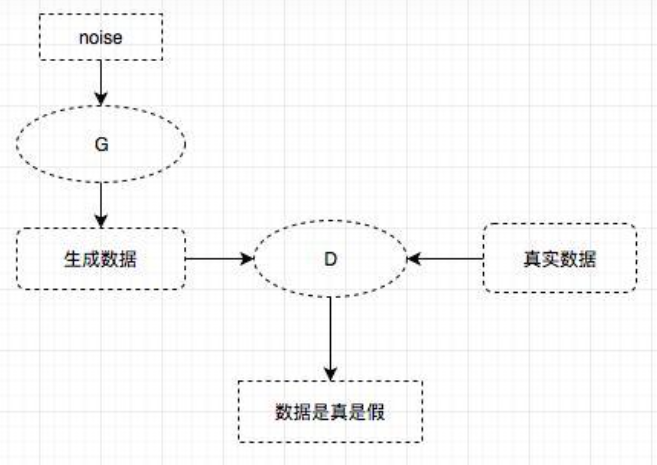
GAN 是通过让一个“造假者”(生成器)和一个“警察”(判别器)不断对抗,最终让造假者学会生成以假乱真的数据。
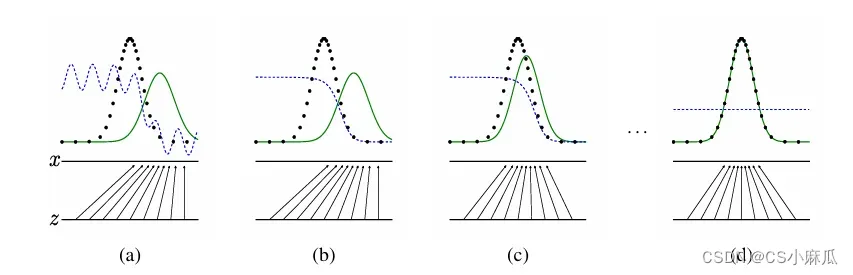
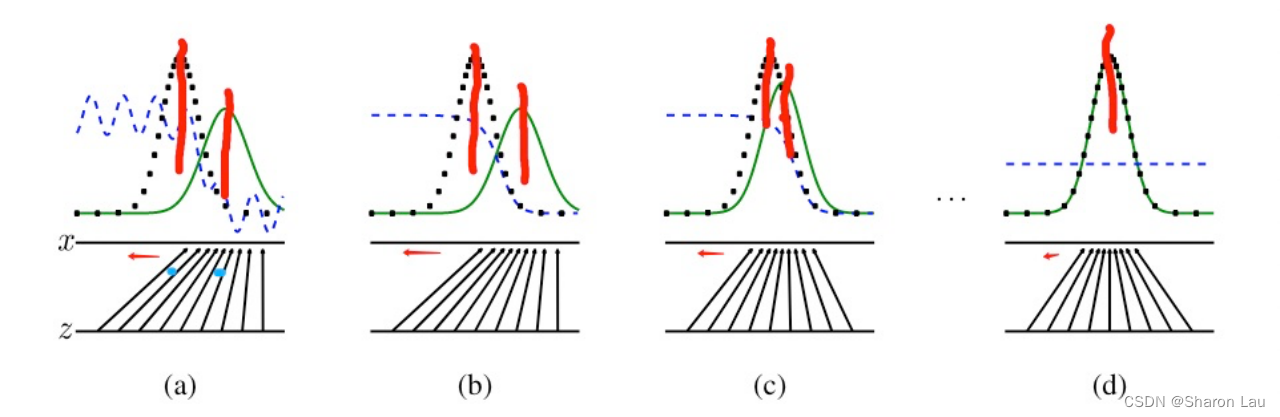
这里介绍会用两个生成模型,一个是生成模型G用来捕捉数据分布,一个是辨别模型D用来估计一个样本到底是从(真实)训练数据来的还是从G生成来的。G的任务就是尽量让D犯错。如果G和D是一个MLP的话就可以通过误差反传来进行训练,并且不需要用到马尔可夫链。
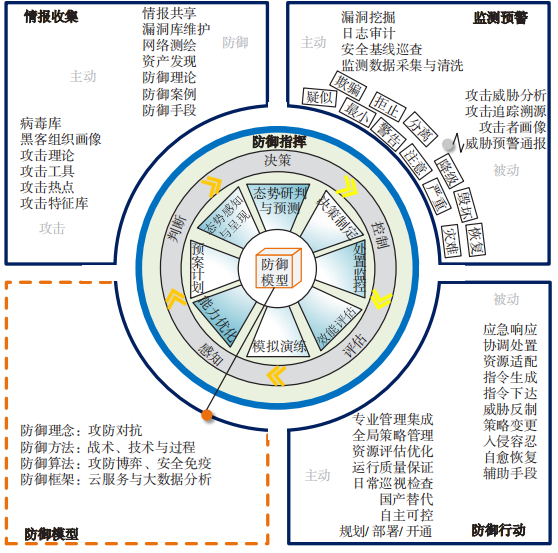
通过分析网络安全领域的攻防对抗发展动态,提出了基于攻防对抗思维,包含情报收集、监测预警、防御指挥和防御行动 4 个要素的网络安全防御体系设想,给出了具备以攻促防特征的防御模型实现思路,阐述了防御指挥活动中防御决策可能的技术途径,并构想了一个体系实践场景。文中对当前网络安全领域出现的攻防对抗研究热点进行了及时响应,为提升组织与企业的网络安全能力提供了一个可供参考的体系设计方向。以此为基础,建议进一步
GAN的详解以及公式推导和代码
生成对抗网络(Generative Adversarial Network,简称)是由Ian Goodfellow等人于2014年提出的一种深度学习模型架构,广泛用于图像生成、文本生成等生成任务。GAN由两个相互对抗的神经网络组成:生成器(Generator)和判别器(Discriminator),它们彼此博弈,共同提高生成数据的质量。
提出了一种新的对抗过程估计生成模型的框架,其中我们同时训练两个模型:一个是捕获数据分布的生成模型G,另一个是估计样本来自训练数据而不是G的概率的判别模型D。G 的训练程序是最大化 D 犯错的概率。该框架对应于 minimax 双人游戏。在任意函数 G 和 D 的空间中,存在一个唯一的解,其中 G 恢复训练数据分布,D 在所有地方都等于1/2。在G和D由多层感知器定义的情况下,整个系统可以通过反向传
报错信息如下:fnt = ImageFont.truetype('Pillow/Tests/fonts/FreeMono.ttf', 50)试了很多方法,把FreeMono.ttf字体文件换成各种其他字体文件,最后还是一直报该错误,我的解决方法是:
从生成器G的角度来看,生成器G希望真实图像x和生成图像G(z)区分不开,即希望虚假数据G(z)可以尽可能骗过判别器D,也就是希望D(G(z))尽可能大,1-D(G(z)就更小,log(1-D(G(z))更小,也就是V(D,G)整体尽可能小,即对G取min V(D,G)。若D(x)是非常完美的判别器,D(x)=1,则V(D,G)=0,而若有误分类时,D(x)<1时,log(D(x))和log(1-D
我们发现“混淆梯度”(obfuscated gradients)作为一种梯度掩码(gradient masking),会在防御对抗样本中导致一种错误的安全感。虽然造成混淆梯度的防御似乎可以击败基于迭代优化的攻击,但我们发现依赖这种效果的防御可以被规避。我们描述了表现出这种效应的防御特征行为,对于我们发现的三种混淆梯度,我们都开发了攻击技术来克服它。在一个案例中,我们检查了发表在ICLR 2018的
每周论文:PAC-GAN: Packet Generation of Network Traffic using Generative Adversarial Networks
如果训练太多次判别器再训练生成器,那么可能导致【模式崩溃】(不管给什么噪声,输出结果一样)因为生成器没有直接接触样本,而是通过判别器告诉它像不像,就像枯叶蝶不知道枯叶长什么样子;源码地址:http://www.github.com/goodfeli/adversarial。论文链接:https://arxiv.org/abs/1406.2661。而是采用的深度学习,深度学习中有完备的训练技巧。条件
。
本文提出了一种利用未配对数据集有效融合多次曝光输入并生成高质量高动态范围(HDR)图像的方法。基于深度学习的HDR图像生成方法严重依赖于成对的数据集。地面真像对生成合理的HDR图像起着主导作用。没有地面真相的数据集很难用于训练深度神经网络。最近,生成对抗网络(Generative Adversarial Networks, GAN)已经证明了在缺少成对例子的情况下,其将图像从源域X转换到目标域Y的
期刊:Transportmetrica B: Transport Dynamics时间:2021作者:Liang Zhang, Jianqing Wu, Jun Shen。
链接:https://pan.baidu.com/s/1rHwdw22bl-l5ID3OJMsldw。使用了一个新的数据集anime,数据集的链接在下方,数据集一共有5w多张动漫头像,都是。首先为数据集建造dataset类,代码如下。训练的代码如下,详细修改见代码注释。,在一个新的数据集完成了复现。
上次带大家了解了什么是黑客,黑客是干嘛的,今天就来看看黑客的收入和方向怎么样。
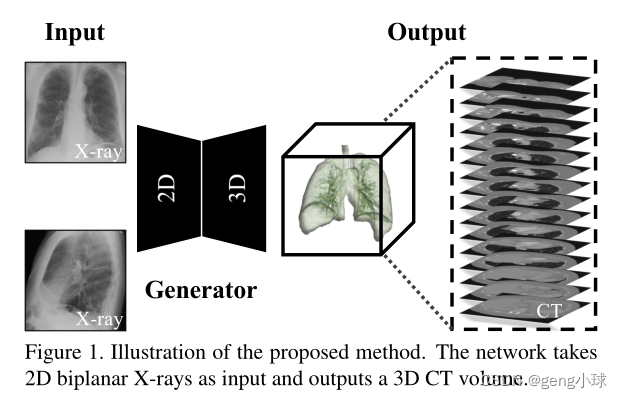
计算机断层扫描(CT)可以提供患者内部器官的3D视图,有助于疾病诊断,但它对患者的辐射剂量更大,而且CT扫描仪比x光机更昂贵。传统的CT重建方法需要通过对身体的全面旋转扫描进行数百次x射线投影,这在典型的x光机上无法完成。在这项工作中,我们建议使用生成对抗网络(GAN)框架从两个正交x射线重建CT。利用一种特殊设计的发生器网络,将数据维数从2D (x -ray)提高到3D (CT),这是以往GAN
这是一篇2021年由华中科技、南洋理工、微软亚洲研究院发表在ICCV的一篇关于黑盒攻击的论文。本文作于2022年10月15日在这篇论文中,作者提出了一种名为Admix的新型输入转换方法,以可迁移性。具体来说,对于每个输入图像,作者随机从其他类别中抽样一组图像,并将每个采样图像的一小部分混合到原始图像中,以制作一组不同的图像,但使用原始图像标签进行计算。广泛的评估表明,Admix攻击方法可以比基于竞
我们引入了一种新的模型,将结构化域自适应应用于合成图像的生成和道路分割。我们将特征金字塔(FP)网络引入生成式对抗网络,以最小化源域和目标域之间的差异。一个发生器被学习产生高质量的合成图像,而鉴别器试图区分它们。我们还提出了一个FPnetwork,通过从网络的所有层中提取有效的特征来描述不同尺度的对象,从而提高了所提模型的性能。
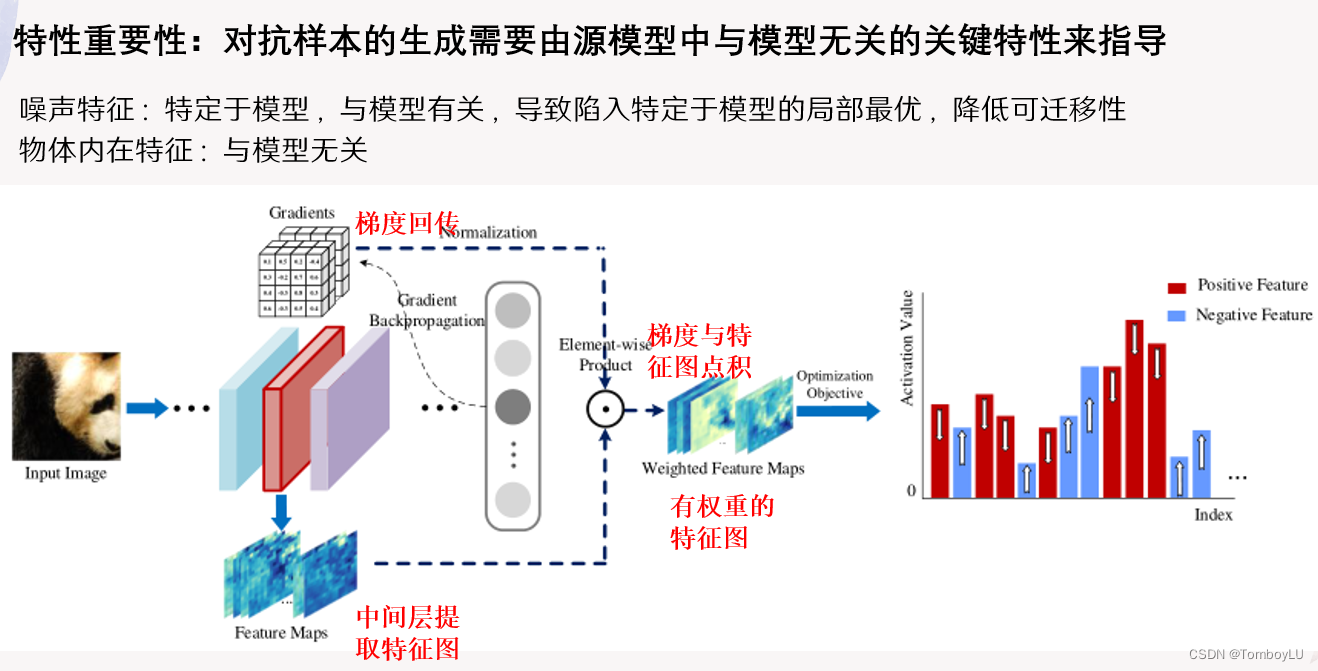
基于迁移性的黑盒攻击首先利用gradient aggregate获取迁移性更好的梯度信息,本文中认为梯度信息代表了该点的feature importance,然后通过抑制比较重要的feature,增强不重要的feature,来干扰模型最终的判断。...
生成对抗网络
——生成对抗网络
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区


 火山引擎视频云技术社区








 DAMO开发者矩阵


 AtomGit AI 社区






 天工造物局