登录社区云,与社区用户共同成长
邀请您加入社区
使用openvino在intel的CPU上部署模型,并使用NNCF进行Int8量化,以加快推理速度,openvino使用2024.1版本。模型采用mobilenetV3与shuffleNetV2。
python + openvino进行图片推理时,要预先对图片进行 image.transpose(2,0,1)操作,这个操作是什么含义?其中的参数 2,0,1又分别是什么?(百度AI回答)
而PP-TinyPose的出世彻底打破了这个僵局,采用Top-Down的方式,先应用3.3M、150FPS的超轻量检测网络。完成一系列针对性的优化,从而对小目标进行关键点检测时,依然能保持同样的精度与速。更特别的是,PP-TinyPose还能同时实现。检测出人体,再用基于Lite-HRNet的移动端优化模型,检测对应关键点,由此确保关键点检测的。,同时扩大数据集,减小输入尺寸,预处理与后处理加入A
本篇主要想关于openvino针对于yolov5的一些转换流程,以及会带有查阅资料了解到的openvino的相关demo与一些需要注意到的点进行总结。关于openvino,有人说是基于CPU上最快的模型加速套件,这当然是显而易见的,因为在我印象里除了Intel本尊,没有啥企业会做这种事情了,emmm。。。openvino相较于传统的cv pipeline,它具有的优势如下:不过这对比的对象就有点老
我们从ubuntu18升级到ubuntu22,发现有一个模型会卡住,在gtest、onenode planner、orion 等不同的环境都会复现,这是一个cpu模型,在做模型推理的时候卡住,用gdb attach到进程中可以看到是这个堆栈,但是这个是没有符号表的。对应到 is_unsupported_parallel_work_amount 这个变量会把这个匿名类存储在栈上,栈上的变量有个特点,
文章摘要:本文介绍了YOLO模型转换为OpenVINO推理流程:(1)使用ultralytics库将YOLO的pt模型导出为ONNX格式;(2)通过OpenVINO工具链将ONNX转为IR模型(xml/bin);(3)在VS中配置OpenVINO(2024.6.0)和OpenCV(4.11)环境;(4)详细展示了OpenVINO推理代码实现,包括模型加载、图像预处理、推理执行及后处理(NMS)等步
然后笔者这边查找出来有两个文件libtbb.so和libtbb.so.2,缺少openvino的依赖libtbb.so.12,在openvino runtime/3rdparty下找到libtbb.so.12,复制到查找到的目录即可。make[1]: *** [CMakeFiles/Makefile2:76:CMakeFiles/detect.dir/all] 错误 2。make[2]: ***
理论上来说,可以直接访问下载dll文件,然后从官方文档中下载缺少的头文件以直接调用,但我没有尝试过。
万能的网友们,真诚发问,Openvino这玩意,安装之后咋就那么爱缺 dll 呢。求答案
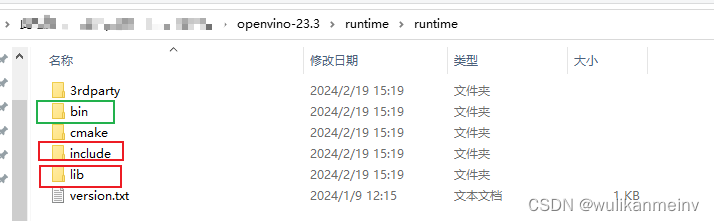
无法找到 “openvino.lib” 文件
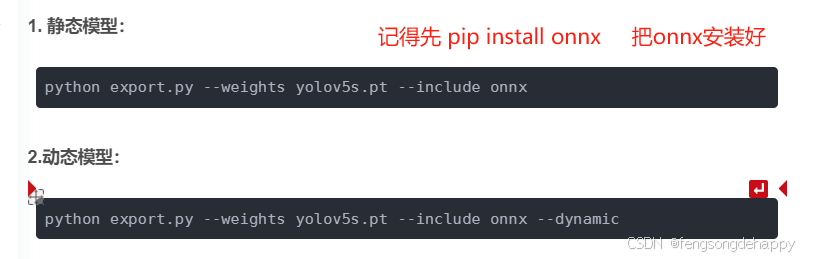
导出的 ONNX 模型的输入形状是静态的,通常是基于训练时的输入尺寸(默认 640x640, batch size = 1)。3.用:python export.py --weights yolov5s.pt --include onnx --dynamic得到yolov5s.onnx。导出的 ONNX 模型支持动态输入尺寸。输入图片可以是任意尺寸,不局限于训练时的尺寸(即我w, h, batch
超简单的安装openvino方法
本文基于ultralyics的yolov8和halcon的标注hdict文件,写了一个一键生成yolo数据集、训练、推理、模型导出、测试的脚本。并且将该脚本编译成traintest.pyd文件(需要可私信),使用主函数yoloit.p文件调用上面traintest.pyd动态库模块,进行训练推理等一系列操作。py编译pyd最终生成如下两个文件,其中yoloit.py为终端输入参数argparse然
2、切换到mo_onnx.py 目录下执行。按照以上链接安装openvino转换环境。1、安装openvino环境。
本文主要介绍在神经网络视觉部署树莓派过程中,配置使用openvino的方法
visual studio 联合openvino与opencv进行编译测试
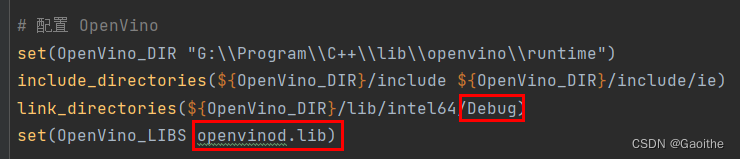
检查项目是Debug模式还是Release模式,Cmake文件需要对应修改为:
修改~/.bashrc,并添加source /opt/intel/openvino_2022/setupvars.sh。下次打开终端时,您会看到[setupvars.sh] OpenVINO™ environment initialized.当您有很多OpenVINO时,不推荐使用上述方法。该脚本将系统上的驱动程序版本与当前版本进行比较。如果系统上的驱动程序版本高于或等于当前版本,则脚本不会安装新
ImportError: DLL load failed while importing _pyopenvino: 找不到指定的程序。完全按照官方的pip安装方式,但是报错。否则会有报错信息输出!无报错信息输出,说明成功。
pyinstaller打包openvino 2021.4.2
论文: https://arxiv.org/abs/2207.02696代码: https://github.com/WongKinYiu/yolov7Anchor是一种用于目标检测的先验框(prior box)生成方法,由Ren等人在2015年提出。Anchor可以在不同尺度和不同纵横比下生成多个先验框,并通过与真实目标框的匹配来预测目标的位置和类别。在传统的目标检测方法中,先验框通常是手工设计
openvino_vs._onnxruntime
本文将详细介绍基于OpenVINO工具包,在C#语言下,部署飞桨PP-Human的全流程,帮助开发者快速掌握并部署产业级AI人体分析解决方案。
ubuntu安装配置openvino2022
在Ubuntu20上基于c++的openvino开发流程
保存到了\openvino_2021.4.752\deployment_tools\open_model_zoo\tools\downloader\intel\vehicle-license-plate-detection-barrier-0106\。终端进入文件夹\openvino_2021.4.752\deployment_tools\open_model_zoo\tools\download
pytorch模型转onnx到openvino
windows、openvino
openvino源码安装
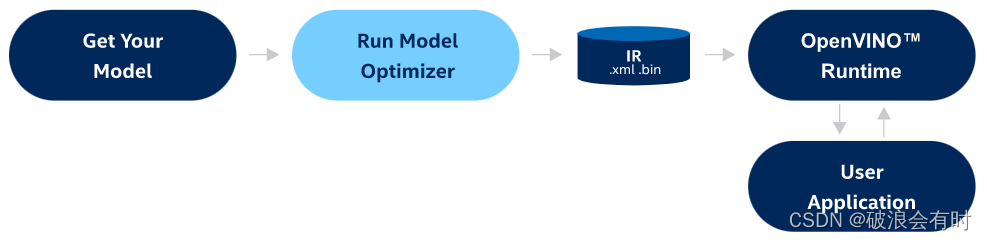
这里的后处理模块其实是复用了PaddleX中提供的参考示例,整体逻辑大家可以参考开篇的那张图片,关于具体的功能模块我们可以直接看其中的头文件。目前 OpenVINO 2022.1的 runtime 可以直接支持对 Paddle 静态模型的读取和加载,但为了追求更好的性能,这里我们还是展示了如果通过 OpenVINO 的 Model Optimizer 工具对下载后的 Paddle 模型进行转换。G
python里进行openvino格式模型的多输入输出动态尺寸推断示例(动态仅支持cpu)。
openvino推理及转格式
pyinstaller 打包openvino 2022.1
场景:利用openvino检查blob文件错误,验证文件代码如这个:链接简单来说:缺库引用官方【用于你没有装VPU的依赖的时候再去看,这是你检查缺库的第一步】:如果你依赖安装了,仍然有文件,这个时候,又要回到安装的openvino-toolkit里面找答案了。参考这个链接,他们的库文件都在一起。...
将OpenVINO的 SSDLite MobileNetV2 物体识别算法在视频流中进行推理。另外,如何通过多线程的方式进行视频读取,以及视频分析。
Windows安装openvino过程中的问题记录
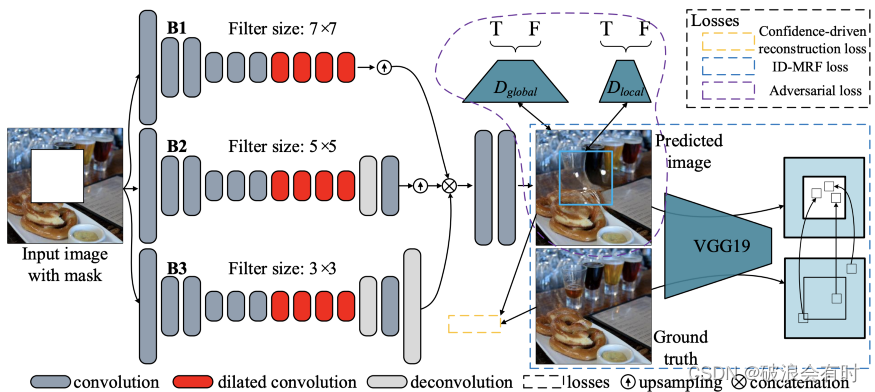
GMCNN 图像修复案例:1. 下载模型`gmcnn-places2-tf`以及中间件`IR`转换;2. 加载`IR`模型;3. 导入测试图片,新建mask,两者合成为mask测试图片;4. 调整mask以及mask测试图片大小,使之与模型输入大小匹配;5. 模型推理,显示结果。
本案例展示了如何将 MobileNetV3 模型从PaddleHub加载到本地,最终转换为 OpenVINO IR 模型。我们还展示了如何使用 OpenVINO 的 推理引擎对样本图像执行分类推理,并比较 PaddlePaddle 模型与 IR 模型。
本文适用:在win10的conda虚拟环境下使用pip install openvino后出现错误错误原因:个人理解:软件补丁版本等不兼容 导致 win10找不到 openvino在哪里笔者在网上尝试了:运行C:\Program Files (x86)\Intel\openvino_2021\bin\setupvars.bat该脚本setupvars.bat就是添加环境变量的。不多BB,直接上解决
还记得在这篇文章,我们提到了cv::dnn::readNetFromModelOptimizer可以读取深度学习模型,但是当时并未使用,这个函数可以直接读取openvino格式的模型,我们可以先去下载一个人脸检测的模型。现在我们直接使用,和之前使用没啥区别,只是模型文件变成了xml和bin文件,使用代码如下:#include<iostream>#include<opencv2/c
// reference from https://docs.openvinotoolkit.org/latest/openvino_docs_IE_DG_supported_plugins_GPU_RemoteBlob_API.html#pragma once#include <algorithm>#include <chrono>#include <memory&
基于Ubuntu20.04下opencv-openvino版配置,内容全面后续会持续更新(主要为robomaster视觉设备配置)
前记:最近在做openvino推理模型的C++部署,需要在VS2019上设置openvino和opencv开发环境,做点小记录,省得以后忘记!环境及软件版本:Windows10 64位+VS2019社区版+openvino2020.0428+opencv3.49openvino默认路径安装,安装路径为 C:\Program Files (x86)\IntelSWTools\openvino_202
一、问题描述d08: 9.77.5.155 机器上可以使用openvinod21: 9.77.80.242 无法使用openvino二、原因Openvino的源码中:https://github.com/opencv/dldt/tree/2018inference-engine/src/mkldnn_plugin/mkldnn/os/lin/lin_omp_manager.cpp1. ...
实时 AI 视频分析是一种基于人工智能的技术,可分析视频流以检测特定行为和事件。这种类型的系统通过人工智能机器学习引擎检查来自监控摄像头的视频流来进行相关工作。该引擎使用一系列深度学习算法和程序来理解数据,并将数据转换为可理解的、有意义的信息。
基本的图像分割的例子,遵循下面三个步骤:首先,我们需要读取模型(ie.read_model)并且编译(ie.compile_model);第二步,我们读取图片,并且reshape其大小以符合模型的输入;第三部,模型推理(compiled_model([input_image])[output_layer_ir])。得到的结果的尺寸和模型的输出尺寸相符。
开启cmd,“以管理员身份运行”,先激活之前创建的虚拟环境并设置环境变量,导航到有.pb文件的地方,使用Windows上的Model Optimizer生成IR文件,按照你自己在Windows上的OpenVINO安装路径来运行下面的代码。接下来为Model Optimizer做准备,因为我只打算将TensorFlow的模型文件作为我的转换媒介,因此我只做关于TensorFlow的准备,其他模型文件
MiniCPM5-2B 把「端侧 2B 混合思考」做到了开源 SOTA;OpenVINO™ + Optimum Intel + GenAI 这一套组合,让你只需一条 optimum-cli + 几十行 Python,就能在 Intel CPU / iGPU / 独显上跑出生产级别的多轮 chat,并随手切换两种思考模式。
生成resnet50.xml模型结构文件和resnet50.bin模型权重文件。
openvino
——openvino
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 天工造物局
















 DAMO开发者矩阵

 英特尔开发套件专区
 乐奇 Rokid 开放社区
