登录社区云,与社区用户共同成长
邀请您加入社区
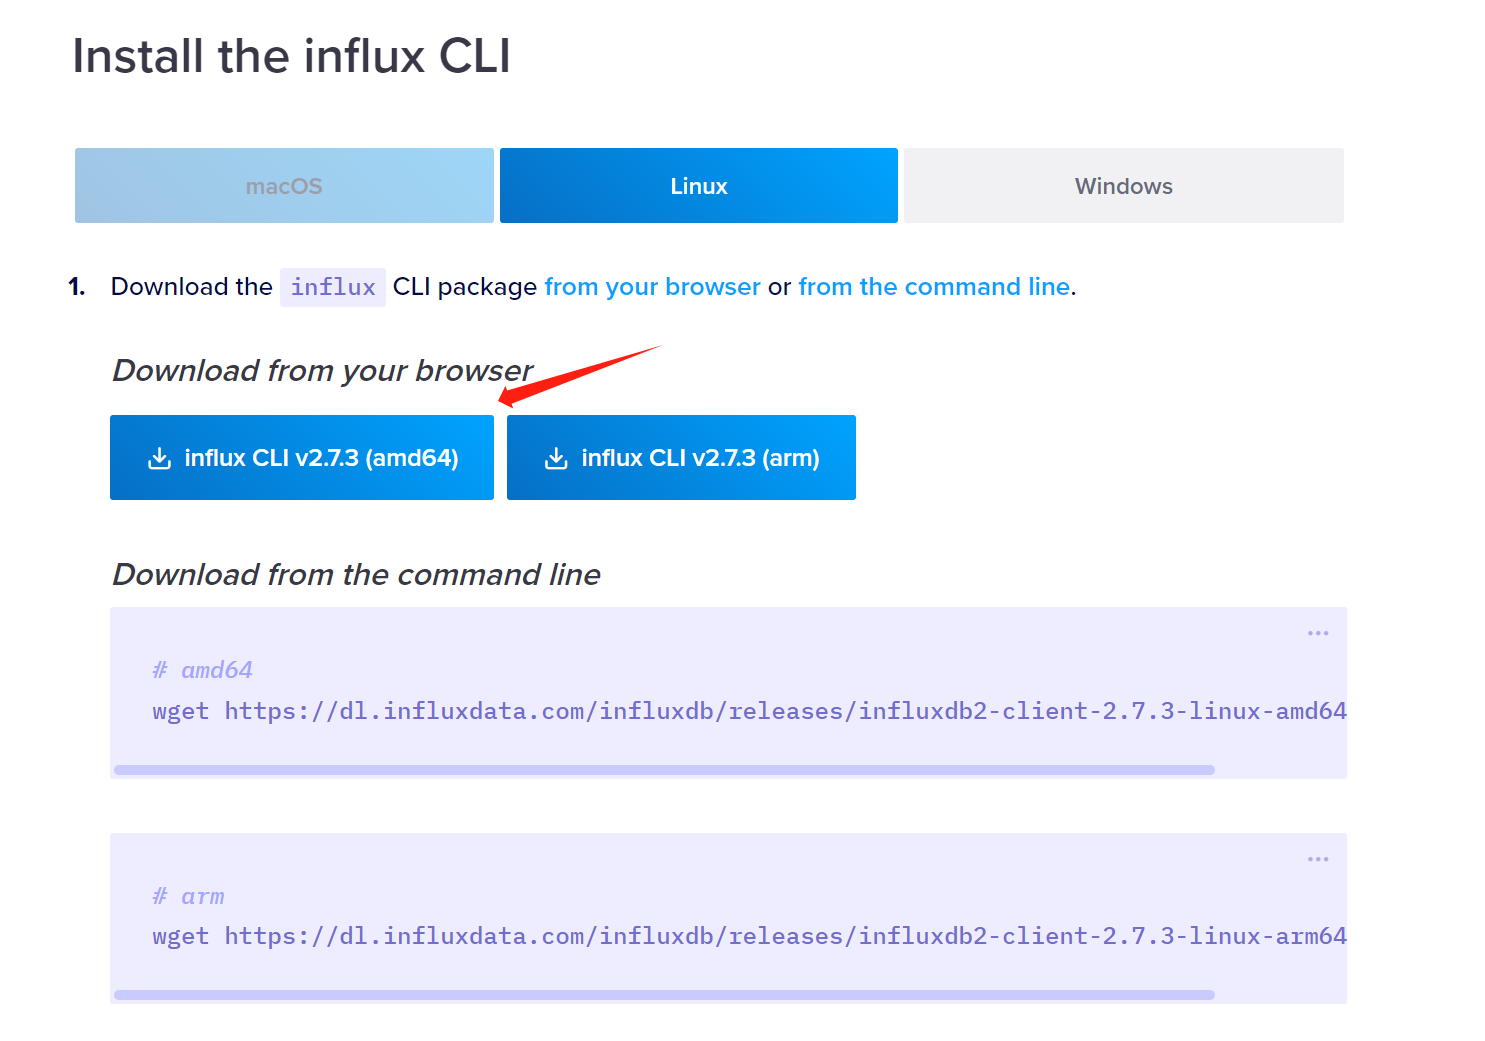
influxdb cli工具连接操作iinfluxdb 2.7.x
前言Taos 主要针对物联网使用,物联网设备的特点是:设备基本有固定的上报数数据,上报的数据有时序性。设备种类不同,上报的数据格式不同。设备数据格式千变万化,需要根据具体设备创建具体的数据模型Taos关键词概念库: 单纯的数据库。所有的超级表、表都属于库。在创建表之前,必须先创建库。处于两个不同库的表是不能进行JOIN操作的。超级表: 表的模板, 可以包含表。 目的是整合同一类数据,共享...
点击关注公众号,Java干货及时送达????来源:零度匠心说实话,国外人写的 ppt 真的简单但是内容又很全,这个内容是 VictoriaMetrics 作者写的,非常赞,我读了大概好多遍了,ClickHosuse 作为时序数据库存在什么问题?之后借鉴那些思路,之后怎么演变为到 VictoriaMetrics?看完你应该对时序数据库很多内容就很清晰了,推荐的。热门内容:公司入职一个阿里大佬,把 S
时序数据是随时间不断产生的一系列数据,简单来说,就是带时间戳的数据。时序数据库 (Time Series Database,TSDB) 是优化用于摄取、处理和存储时间戳数据的数据库。此类数据可能包括来自服务器和应用程序的指标、来自物联网传感器的读数、网站或应用程序上的用户交互或金融市场上的交易活动。
csv文件和txt文件导入influxdb时序数据库中
项目场景:InfluxDB是一个由InfluxData开发的开源时序型数据。它由Go写成,着力于高性能地查询与存储时序型数据。InfluxDB被广泛应用于存储系统的监控数据,IoT行业的实时数据等场景。问题描述使用influxdb做数据统计,运行一段时间之后,发现页面查询缓慢。原因分析:经查询发现数据存储量很大,在做聚合查询时缓慢会导致查询失败。解决方案:计划使用influxdb的连续查询功能,将
本文将介绍如何使用 EMQ X 规则引擎的 MQTT 数据桥接功能,接收 MQTT 客户端发送的数据,并实时插入到时序数据库 IoTDB。
时间序列数据(Time Series Data)是带时间戳、按时间顺序排列的数据。每条记录回答一个问题:“某个时刻,某个对象,某个指标是多少。概念说明示例timestamp时间戳metric指标名cpu_usagetag标签/维度field数值75.5三个特征决定了它的存储与查询方式:写多读少、只追加不更新;时间戳天然有序;指标基数高(一台设备一个 ID)。时序数据库(Time Series Da
<think>我们需要根据用户要求,生成≤150字的文章摘要。用户提供了整个文章内容,需要提炼核心。文章主题:工业数字化中时序数据库从“能用”到“好用”再到“敢用作核心”,以DolphinDB为例。摘要需精炼。注意不超过150字。需要覆盖背景、转变、关键点、案例。可能包括:数据规模与实时需求使传统架构不足,时序数据库从可选变关键;好用需全场景接入、存算一体、低门槛运维;DolphinDB通过列式存
当业务规模从单厂区扩展到集团级,或是设备接入量从几千台飙升至数十万台时,单机版的时序数据库必然会撞上性能天花板
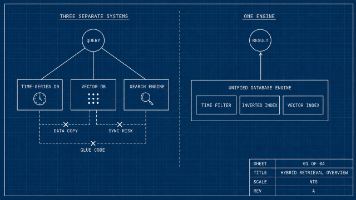
大模型应用普及之后,检索重新成了数据库领域最热闹的考场:语义检索要向量数据库,全文检索要搜索引擎,结构化筛选要时序库或数仓——一个 RAG 应用背后常常站着三套系统,各自存储、各自索引,结果在应用层对齐。
刚接触时序数据库的时候,我其实也跟很多人一样,把目光死死盯在一个问题上。那就是每秒到底能写进去多少条数据。
10.SQL 参考 |:08 SQL 差异:TDengine v3.x(v3.3.x / v3.4.x)|最后更新:2026-07-22TDengine 兼容大部分标准 SQL 但有时序特性扩展和限制。本文系统列出与 MySQL/PostgreSQL 等关系数据库的核心差异,帮助迁移和误用排查。
时序数据库是2026年增长最快的数据库细分赛道之一。全球时序数据年复合增长率已突破45%,单一大型能源或制造企业的日均时序数据增量已可突破PB级。面对金仓时序数据库、TDengine、InfluxDB、TimescaleDB、IoTDB等众多选择,选型不能只看QPS数字。本文从架构设计、写入性能、查询能力、压缩效率、生态兼容五个维度,对5款主流时序数据库进行深度对比,帮助读者根据实际业务场景做出合
IoT 物联网平台:设备时序 + 元数据宽表 + 日志检索统一管理,适用于替代 InfluxDB+MySQL+ES 三库拼接方案工业物联网:传感器时序采集 + 设备画像 + 异常检索,适用于预测性维护与数字孪生车联网与智能交通:车载传感器时序 + 车辆档案 + 轨迹检索,适用于大规模车队数据底座互联网运维监控:Metrics 时序 + 配置宽表 + 日志检索,适用于替代 Prometheus+My
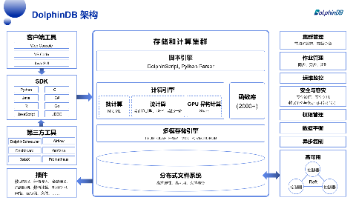
中国信息安全测评中心与国家保密科技测评中心联合发布的2026年第2号公告显示,DolphinDB时序数据库V2.0以最高安全等级通过国家安全可靠测评,成为首批获认证的国产时序数据库。测评从核心技术、安全保障、持续发展和行业应用四大维度严格审核,标志着国产时序数据库已具备支撑金融、能源等关键领域核心系统的能力。DolphinDB凭借高性能分布式存储引擎、存算一体架构、流批融合技术及AI原生能力,有效
时序数据库(TSDB)是专为处理时间序列数据设计的数据库系统,具备高写入吞吐、高效压缩和时间排序特性。其核心原理采用LSM树存储引擎,通过内存缓冲、批量写入和列式压缩(压缩率可达90%)优化性能,支持自动分片和生命周期管理。典型应用包括物联网监控、金融分析和运维指标采集。主流产品如InfluxDB、Prometheus和国产TDengine各具特色,适用于不同场景。TSDB通过倒排索引快速定位数据
本文从 TCO(总拥有成本)角度,深入分析 TDengine 在硬件成本、运维成本、开发成本方面的优势,为企业技术选型提供成本参考。从 TCO 角度分析,TDengine 在硬件、软件、运维、开发四个维度均具有显著成本优势,是性价比最高的国产时序数据库选择。:时序数据库、TDengine、成本分析、TCO、性价比。存储 100TB 数据。写入 100万条/秒。高(Flux 语言)
性能提升:通过这次平台升级,指标计算的及时性得到了大幅提升。对比以往,我们的计算时效性最少提高了 4 倍,最高的时候,例如从年指标计算频率两天一次提高到每分钟一次,时效性提高了 100 倍。计算时长方面,最少也缩短了两倍,最高提升了 8 倍。准确性提升:通过流式处理和层级加工的方式,我们的指标数据能够前后一致地匹配,解决了无序数据带来的准确性问题,客户投诉率接近零。同时,延迟数据的处理也更加智能化
本文从 TCO(总拥有成本)角度,深入分析 TDengine 在硬件成本、运维成本、开发成本方面的优势,为企业技术选型提供成本参考。
在信创战略推动下,本文分析工业场景中国产时序数据库的选型要点,重点介绍 TDengine 的国产化适配能力和企业级特性。在信创背景下,TDengine 凭借其全面的国产化适配、企业级特性和开源优势,是工业场景时序数据库选型的理想选择。信创(信息技术应用创新)战略要求核心系统实现自主可控。在工业数据管理领域,时序数据库的国产化替代尤为关键。:时序数据库、TDengine、信创、国产化、自主可控。#
最新安可测评新增时序数据库品类,系行业标志性突破。DolphinDB 依托全自研技术与丰富行业落地经验成功入选,也印证了国产时序数据库技术实力与应用价值全面提升。
开箱即用的Java项目模板,基于SpringBoot 2.x/3.x构建,已预集成国产高性能时序数据库TDengine(支持JDBC直连),并配置Druid作为生产级数据库连接池。项目包含完整的Maven结构,pom.xml中已声明tdengine-jdbc驱动、spring-boot-starter-jdbc及druid-spring-boot-starter依赖;src/main下提供标准分层
构建一个高性能的光伏能源管理系统是一项系统性工程,需要打通从底层硬件协议到上层大数据分析的全链路。采集端:建议采用具备容器化部署能力的智能网关,采集器选型可以参考我们的 SmartPVLog 三档(ZEL-50 / Pro / 80),以应对不同规模的测点需求。存储端:TimescaleDB 兼顾了 SQL 的灵活性与时序存储的高性能,是目前中大型 EMS 系统的首选方案。应用层:解耦实时监控与离
面对设备运行、能耗监测、业务流量、销量变化等大量时间序列数据,企业到底该如何更低门槛地把数据真正用起来?欢迎所有关注时序数据库 IoTDB 、时序大模型 Timer 的行业用户、技术人员与合作伙伴,—— 面向时序预测与智能分析的云服务平台,为企业时序数据价值释放打开新可能。从时序数据库到时序智能,TimechoAI 的第一场公开分享要来了!数据库、通用大模型、时序大模型,我们如何看待这三者的关系。
influxdb数据库笔记
SonnetDB 为 .NET 开发者提供了一个在 IoT 场景下替代 InfluxDB、Prometheus 的优秀选择。随着 IoTSharp 生态的持续完善,SonnetDB 有望成为 .NET 领域时序数据存储的事实标准。这些 benchmark 数据表明,SonnetDB 在写入吞吐量、查询延迟和聚合计算等核心场景中,相比主流时序数据库有。设计,标志着 .NET 生态在时序数据领域的重大
非技术读者:知道时序数据库能帮企业 “降本提效”,比如设备少停机、系统少故障,是数字化转型的关键工具。特别是 DolphinDB,以其国产化优势和强大功能,为企业在数字化浪潮中提供了可靠的数据管理和分析手段,助力企业实现自主可控的数字化转型。企业决策者:通过选型速查表,30 秒确定适合自己的产品,避免踩 “高价低效” 的坑。对于大中型国产企业,在复杂业务场景下,DolphinDB 凭借其国产可控、
展望未来,随着智能网联汽车的普及和自动驾驶技术的成熟,时序数据库将在车联网领域创造更大价值,为汽车强国建设贡献力量。在这场深刻的产业变革中,数据正在成为汽车企业的核心资产,而时序数据库作为车联网数据管理的核心引擎,正在发挥着越来越重要的作用。作为全球最大的汽车市场,车联网发展迅猛。本文深度分析车联网产业发展新格局,探讨时序数据库在智能网联汽车中的战略价值,以TDengine为例分析车联网数据基础设
“双碳”目标的推进正在深刻重构电力系统的运行逻辑。新能源装机占比持续攀升,储能、虚拟电厂、需求响应等新业态快速涌现,源、网、荷、储各侧的角色与互动方式正在被重新定义。
本文深入探讨了时序数据库InfluxDB在IoT项目中的优势,从写入性能到压缩算法进行全面对比。InfluxDB凭借其TSM存储引擎和Gorilla压缩算法,显著提升了数据处理效率和存储空间利用率,特别适合高并发写入和时间序列数据场景。通过实测数据展示了InfluxDB相比传统数据库的性能优势,为物联网项目提供了可靠的数据库选型指南。
本文详细介绍了在CentOS 7上手动部署TDengine时序数据库的完整实践,包括环境准备、二进制安装、配置调优、服务管理及性能压测等关键步骤。通过实战操作演示和常见问题排查,帮助用户快速掌握这一国产高性能时序数据库的部署与应用技巧。
分页往往伴随着大量的列表请求。对于动辄存储千亿级数据的 TDengine 时序数据库,如果 API 接口的设计和调用依然沿用传统思维,必将陷入极其严重的性能泥潭。在 TDengine 中,由于时序数据天然以时间戳(Timestamp)作为主键,前端在请求下一页时,只需传入上一页最后一条记录的时间戳,底层引擎便能利用主键索引瞬间定位到目标数据块,无论翻到第几页,查询延迟都始终稳定。其核心思路是,记住
本文深入探讨了InfluxDB作为IoT项目首选时序数据库的核心优势,从架构设计到性能对比全面解析。InfluxDB专为时序数据优化的TSM存储引擎、高效内存管理和智能压缩策略,使其在写入吞吐量、存储效率和查询性能上远超传统数据库,是处理海量物联网数据的理想选择。
本文详细介绍了如何利用TDengine时序数据库的超级表功能,结合C#和SqlSugar ORM框架高效处理百万级传感器数据。内容涵盖从环境搭建、超级表设计,到使用C#实现高性能批量写入和复杂聚合查询的完整实战流程,为物联网数据存储与分析提供了可落地的解决方案。
本文详细介绍了在三台服务器上搭建高可用Apache IoTDB集群的完整实战指南。内容涵盖集群规划、环境配置、以及Docker与原生两种部署方案的详细步骤与核心对比,帮助读者根据性能、运维复杂度等需求选择最适合的时序数据库部署方案,确保系统的高可用性与可扩展性。
在钢铁行业数智化转型的浪潮中,球团生产线作为钢铁冶炼的关键环节,正面临着海量工控数据爆发式增长与复杂工艺实时管控的双重挑战。某头部钢铁集团(下称“ A 公司”)通过引入 DolphinDB 多模引擎与流计算框架,成功破解带式焙烧机场景下的数据存储、实时计算与高效分析难题,为国产时序数据库在重工业领域的应用树立了标杆。
本文提供了一份详尽的实战指南,手把手教你如何使用Docker在5分钟内快速搭建一个高可用的Apache IoTDB时序数据库集群。文章详细介绍了3C3D集群架构的配置、一键启动与验证步骤,并涵盖了性能调优、数据持久化及Python客户端读写演示,为物联网数据处理提供了高效、可靠的解决方案。
本文深入解析Apache IoTDB时序数据库的架构设计,针对工业物联网场景中海量时序数据的管理挑战,提供从单机到分布式集群的实战部署指南。详细探讨了其核心存储引擎TsFile、对齐时间序列等关键技术,并结合设备监控、能源管理、车联网等典型场景,给出具体的配置方案与性能优化建议,帮助开发者高效构建稳定的工业数据平台。
在模型能力持续演进的过程中,零样本预测、分位数预测以及协变量建模等能力已逐步得到支持。协变量预测的核心,并不是简单增加模型的输入变量数量,而是让模型理解变量之间的动态关联与耦合关系。在很多人印象中,时间序列预测的逻辑十分简单 —— 以历史数据预测未来趋势,但在真实的工业系统中,这一过程远非如此直接。在 IoTDB 的持续演进中,我们同样将协变量预测视为重要发展方向之一,围绕这一能力的相关技术也在持
本文深入探讨了工业物联网场景下时序数据库的选型策略与性能优化。面对高频写入、海量存储和复杂查询的挑战,文章从写入性能、存储效率、查询能力、扩展性及生态兼容五大核心维度进行剖析,并以Apache IoTDB、TDengine和InfluxDB为例进行横向对比,为不同工业场景提供选型建议。最后,以Apache IoTDB为例,分享了从写入调优到生产部署的实战优化指南与落地路线图。
在当下的技术条件与产业环境下,时序数据库真正需要正视的对手,究竟是谁?
2026年国产时序数据库
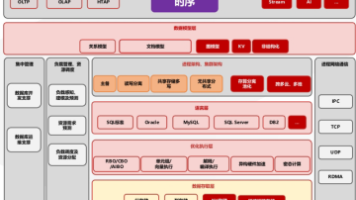
2026年国产时序数据库呈现专业深耕与融合多模双轨发展。金仓数据库凭借内核级多模态融合架构,为需时序与业务数据深度整合的场景提供了独特的企业级解决方案。
进入2026年,在“数字中国”与工业物联网浪潮的强劲推动下,国产时序数据库市场持续繁荣,竞争格局日趋清晰。本文将对当前主流的国产时序数据库进行梳理盘点,并特别聚焦于金仓数据库(Kingbase),深入剖析其以融合多模架构为核心的差异化竞争实力,为企业在数字化转型中的时序数据底座选型提供参考。
时序数据库
——时序数据库
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 天工造物局