登录社区云,与社区用户共同成长
邀请您加入社区
机器学习反爬通过多维度行为建模,从时序、设备指纹、交互语义等层面识别爬虫。传统规则被突破后,风控转向概率判断:利用人类行为的随机性、生理特征与设备指纹差异,结合深度学习与无监督算法,实现对自动化程序的精准识别。攻防持续升级,核心在于提升爬虫成本,构建动态平衡。
本文详解2025年后主流AI爬虫(如GPTBot、ChatGPT-User、Bytespider等)的识别与管理策略,区分搜索引擎、联网搜索与训练爬虫三类,推荐“三段式”robots.txt配置:放行搜索引擎与联网搜索爬虫,按数据敏感度控制训练爬虫访问。提供语法检查、模拟测试与日志监控验证方法,并建议配合llms.txt实现精准内容管控,确保网站安全与价值可控。
一个做小家电的客户,十月中的时候挺高兴:客户在 ChatGPT 里问「静音空气循环扇推荐」,他的品牌被提到了,排在第三个。一周后他拿着后台数据来找我:那条答案下面多了一个「去购买」的按钮,客户点了,跳转的是电商平台,不是他的官网。他问我一句很实在的话:「被推荐了,怎么客户还是没到我这儿来?因为。前者解决「有没有你」,后者才解决「客户去哪下单」。
本文围绕人工智能核心方向,系统梳理了涵盖深度学习、计算机视觉、自然语言处理、智能预测、智能系统开发、机器学习优化及安全伦理等七大领域的200个研究课题。内容聚焦模型优化、算法创新、多模态应用与实际场景落地,涵盖图像识别、语音处理、文本生成、风险预测、智能安防与隐私保护等前沿议题,体现人工智能技术在理论深化与工程实践中的深度融合与广泛应用。
适用读者:知识付费/在线教育平台运维与后端、被 AI 爬虫流量困扰的站长、负责成本优化的技术管理者。
*函数,该函数用于在控制台打印输出内容,并在输出后自动添加一个换行符。若如上图所示,输入go version 命令后回车,显示 go 的版本信息,则说明安装成功。同样新建一个系统变量,变量名为GOPATH ,变量值则选择一个自定义路径,用来做项目存储。(按照提示进行安装即可,注意安装位置,下图便是安装之后go的所有文件了)新建一个系统变量,变量名为 GOROOT ,变量值为go的安装目录即可。这是
经过一系列分析,验证码请求接口会给我们返回3个参数,slider、background,还有一段js。这段js是搭配网页的js执行的,会返回一个数字,它决定了滑块距离验证码顶部的像素,咱就可以用它来判断那个缺口是真的。模型训练好了,就不展示接口搭建调用了,接下来是网站的逆向。改完就可以开始跑了,效果杠杠的。
程序员这个行业,前些年真是赶上了好时候。那时候互联网公司遍地开花,程序员成了最吃香的职业——重点大学计算机专业录取分一年比一年高,各种编程培训班开得满大街都是,刚毕业的学生拿好几个30万年薪的offer,这些事在朋友圈里刷屏都不稀奇。但到了2023年,情况开始变了。全球科技公司增长变慢,大家开始精打细算过日子。大厂裁员的消息和招聘冻结的通知一个接一个,招人要求也越来越狠:既要会做网站又要懂人工智能
PyCharm是一种Python IDE(Integrated Development Environment,集成开发环境),带有一整套可以帮助用户在使用Python语言开发时提高其效率的工具,比如调试、语法高亮、项目管理、代码跳转、智能提示、自动完成、单元测试、版本控制。此外,该IDE提供了一些高级功能,以用于支持Django框架下的专业Web开发。
如果你也想自学Python,可以关注我。我会把踩过的坑分享给你,让你不要踩坑,提高学习速度,还整理出了一套系统的学习路线,这套资料涵盖了诸多学习内容:开发工具,基础视频教程,项目实战源码,51本电子书籍,100道练习题等。相信可以帮助大家在最短的时间内,能达到事半功倍效果,用来复习也是非常不错的。希望这篇文章对你有帮助,也希望能帮到大家,因为你我都是热爱python的编程语言爱好者。↓↓↓↓资料获
『scrapy爬虫』pycharm运行scrapy时没有在pycharm中输出日志
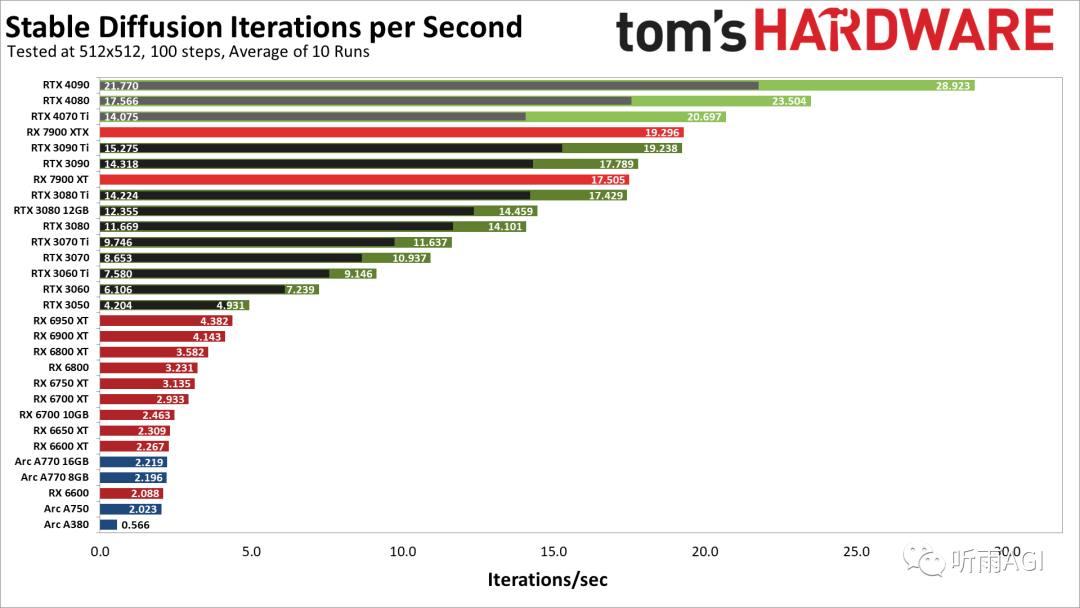
具体介绍呢,其实可以对照 Midjourney「后续简称MJ」 ,只不过MJ是线上付费的,SD是可以免费安装在自己电脑里的「就是对电脑的配置要求有点高」;然后大家选择算力市场,默认计费方式就是「按量计费」,我们默认就行,以下是不同 GPU 型号每个小时的价格,大家可以按自己的需求租赁。嗯,咋说呢,以武林秘籍为例,SD的心法等级要比MJ更高一些,你投入的精力越多,收获也就越大。如果电脑配置不够,又想
Scrapy分布式爬虫意味着几台机器通过某种方式共同执行一套爬取任务
分布式爬虫scrapy-redis的搭建与运行
Python 是这两年来比较流行的一门编程语言,主要卖点是其相对简单的语法以及丰富的第三方库,下面我来带大家安装、配置 Python。(文章最后有各种疑难杂症的解决方法!(Python、Sublime 官方下载地址是外国的服务器,所以会很慢,下载有问题的私聊我拿网盘链接)很多人会推荐 Anaconda(400M以上),但实际上原版 Python(26M)对新手来说就足够了有部分喜欢用360安装的电
Windows操作系统允许创建多个账号用户,每个账户有自己的使用权限,Install Now默认当前账户安装,安装路径和内容是默认的,其它非管理员账户登录到windows系统不能使用这个账户安装的python。
Python是最受欢迎的爬虫语言之一,因为它易于学习和使用,有大量的库和框架可供选择。JavaScript通常用于Web爬虫,因为它可以直接在浏览器中运行,可以轻松地从动态网站中提取数据。java是一种广泛使用的语言,它有很多强大的库和框架,可以用于爬虫。
先简单介绍下个人背景,三流大学毕业,物流专业,学习能力一般,没啥特别技能,反正就很普通的一个人!工作4年存款7000,感觉生活无望,就直接决定转行
这一阶段的学习更多是要为自己的工作/项目服务,真正的[程序员](https://www.zhihu.com/search?进阶学习是整个Python学习环节中耗时最长、学习量最大的阶段,因为入门接触的更多是概念和兴趣性的东西,进阶就要真正见世面了。我见过很多技术小白因为语言工具包和 IDE 安装的失败而失去了学习的欲望,可以先使用一些安卓APP来探索,不需要掌握所有的知识,但是应该知道一些常识,因
服务器蓝屏后查出错误文件是ntkrnlmp.exe,求各位大神指导一下
我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。Python所有方向路线就是把Python常用的技术点做整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。python 是脚本语言。光学理论是没用
2.1.5 python2 的安装 1、点击下载好的 python2 的安装包,默认选择的是为所有用户安装,直接点击下一步 2、点击更改安装路径,建议安装在 D 盘根目录下(D:\Python27) 3、更改完安装路径 4、安装选项页面有个添加到环境变量的选项,此处建议不选,保持默认,点击下一步。
本文罗列了了python零基础入门到精通的详细教程,内容均以知识目录的形式展开。01.python由来与发展介绍02.项目开发流程。
python入门 对json进行基本操作,提取想要的数据
原始文档矫正后文档思路:只要获得倾斜文档的倾斜角度,然后通过仿射变化旋转一下就可以实现矫正了,这里获取倾斜角度的方法有两个,下面分别介绍1、利用霍夫变换,文档内容都是平行的,首先利用利用霍夫变换检测直线,然后将所有直线的平均倾斜角度当做文档的倾斜角度,最后再进行仿射变换就可以了。import cv2import numpy as npdef imshow(img):cv2.imshow("img"
什么是爬虫?爬虫是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本,简单来说就是模拟浏览器发送http 请求,然后获取数据实战目标网站:https://www.baidu.com/第一步 分析打开浏览器的开发者工具,快捷键f12然后在浏览器输入https://www.baidu.com/回车,我们可以看到我们选择响应就可以看到浏览器给我们返回数据了,点一下原始我们就可以到html我们可以打开
一、nginx的常用概念1.nginx简介Nginx (“engine x”) 是一个高性能的 HTTP 和反向代理服务器,特点是占有内存少,并发能力强,事实上nginx的并发能力确实在同类型的网页服务器中表现较好,中国大陆使用nginx网站用户有:百度、京东、新浪、网易、腾讯、淘宝等2.nginx中的反向代理反向代理,其实客户端对代理是无感知的,因为客户端不需要任何配置就可以访问,我们只需要将请
我们在做爬虫的时候经常要使用谷歌浏览器驱动,今天分享下这个Chromedriver 插件的安装方法。第一步、打开谷歌浏览器打开设置面板第二步、查看当前谷歌浏览器版本号第三步、点击插件下载,进去这个界面,找到跟自己谷歌浏览器版本号最相近的那一个。下载地址:插件下载这里有许多的版本,注意 icons/向下的版本是无用的。选择icons/以上的版本,越靠近icons/的版本越新。第四步、找到对应版本后点
c#爬虫窗体Demo开发工具:vs2017,sql server 2014框架版本:.net framework 4.6.1开发模式:三层架构、轻量级orm PetaPoco思路:爬虫最为关键的一环就是读取网页的源码,其核心内容也是对网页源码的处理。通过对网页源码进行字符串的处理,以便于获取需要的字段信息。...
现在市面上大部分都是PYthon 做的爬虫,这里另辟蹊径用一下c#本文获取的网站是:https://www.bqktxt.com有更好的方法欢迎大佬指点好了!开始吧!首先创建一个winfrom窗体应用,并画出窗体用到的组件有:Lable,textbox,button,linklable,progressBar各位注意区别2. 创建一个接收类(用于传参)检测URL按钮代码这一步的主要作用是把网页的所
开启第十五关,先尝试注入,注入多次后发现页面无报错也无回显,于是尝试盲注使用万能密码’ or 1=1登陆成功,’ or 1=2登录失败,这里可以使用布尔盲注,研究响应页面发现登录成功和登录失败时底下的提示是一个图片,而图片的命名不同,可以此区分成功和失败,开始写脚本,脚本的思路和之前使用布尔盲注的关卡类似,只需修改请求类型、数据和if条件即可,代码如下:import requests# 获取数据库
前言市面上的python图书真的是太多啦,对于刚接触到python的小白是真的很不友好,这里分享几点学习心得和一份精选书单,希望能够帮到想学习python的你。自己给自己定一个进阶目标。在学python基础的时候,最好有一个进阶目标。比如以后想做爬虫?还是数据分析?还是拿来搞量化?这样才有针对性学习。下面是我的推荐书单:1.python入门书单《Python编程:从入门到实践》 适合人群:新手小白
最近在学习爬虫,查了一些资料,可以实现爬虫的语言很多,但多推荐python,所以就先学学python。以前没有接触过太多python,但对C比较熟,所以学习python比较容易,后面几篇博客就写写学习python过程中做的笔记吧。print,input:print(“www”,”baidu”,”com”,sep=”.”)输出:www.baidu.com作用:以”.”作为分隔符,输出字符串a = i
文章目录7.7. scrapy-redis实战-- IT桔子分布式项目17.7. scrapy-redis实战-- IT桔子分布式项目1IT桔子是关注IT互联网行业的结构化的公司数据库和商业信息服务提供商,于2013年5月21日上线。IT桔子致力于通过信息和数据的生产、聚合、挖掘、加工、处理,帮助目标用户和客户节约时间和金钱、提高效率,以辅助其各类商业行为,包括风险投资、收购、竞争情报、...
python 安装配置常见问题总结1. 下载python源码包并重新编译安装官网 https://www.python.org/ 下载python指定版本源码包,如 Python-2.7.16.tgz;解压后编译安装,命令如下:$ tar -zxvf Python-2.7.16.tgz$ cd Python-2.7.16$ ./configure --prefix=/usr/loca...
scrapy-redis + Bloom Filter分布式爬取tencent社招信息什么是scrapy-redis什么是 Bloom Filter为什么需要使用scrapy-redis + Bloom Filter目标任务安装爬虫创建爬虫编写items.py编写spiders/tencent.py编写pipelines.py编写...
在server {} 块中添加下面的配置location =/robots.txt {default_type text/html;add_header Content-Type "text/plain; charset=UTF-8";return 200 "User-Agent: *\nDisallow: /";...
背景随着业务需求的变化,大规模爬虫遇到各种问题。python爬虫具有先天优势,社区资源比较齐全,各种框架也完美支持。爬虫性能也得到极大提升。本次分享从基础知识入手,涉及python 的两大爬虫框架pyspider、scrapy,并基于scrapy、scrapy-redis 做了分布式爬虫的介绍(直接粘贴的ppt截图)会涉及 redis、mongodb等相关知识。一、前沿1.1 爬虫是什...
需求:如果本地没有这个url就rewrite到另外服务器上去请求;实现:server{listen8080;if(!-e$request_filename){rewrite^/(.*)$http://192.168.2.42/$1permanent;}}说明:当本地web上没有这个资源的时候,就跳转到192.168....
robots协议(网络爬虫排除标准)方法一:修改nginx.confserver {listen 80;server_name www.lvnian.com;#添加如下内容即可防止爬虫if ($http_user_agent ~* "qihoobot|Baiduspider|Googlebot|Googlebot-Mobile|Googlebot-Image|Media...
已经决定买一台虚拟服务器,但还不能决定使用哪个 Linux 发行版?我们都经历过这种困扰。对于 Linux 发行版来说,要在这么多的发行版和种种支派flavors中选择一个,那简直能让人崩溃。不过,对于服务器而言,有两个主流的 Linux 发行版,那就是 CentOS 和 Ubuntu。但如何从这两个之中选择,这是摆在管理员、初学者和专业人士面前的主要问...
需求:如果本地没有这个url就rewrite到另外服务器上去请求;实现:server{listen8080;if(!-e$request_filename){rewrite^/(.*)$http://192.168.2.42/$1permanent;}}说明:当本地web上没有这个...
前言(备注一下,我的开发环境不是Linux就是MacOSX,Windows很多写法不是这样的)在爬取数据的过程中,有时候需要用到定时、增量爬取。定时这里暂且不说,先说增量爬取。我想要的增量爬取目前只是简单的,根据url请求来判断是否爬过,如果爬过则不再爬。复杂一些的增量则是重复爬取,根据指定的几个字...
若要检查您当前的评估期上剩余的时间,可以使用System32文件夹中的脚本“Slmgr.vbs“ ,这个脚本可以用-dli开关来运行此脚本。具体方法如下:1.单击开始,然后以管理员身份命令提示符。2.键入slmgr.vbs-dli,然后按ENTER以检查您的评估期的当前状态。此时,系统会显示评估期剩余时间,就是你说的不激活的情况下,还可以用多...
今天给大家讲一下如何安装Pycharm和python以及在Pycharm中加载python需要的库一、安装Pycharm1、首先我们可以去Pycharm的官网http://www.jetbrains.com/pycharm/点击Download Now下载我们需要的Pycharm版本。如红色方框所示:2、双击我们刚才下载的安装包,进行安装,然后会弹出如下界面,然后单击Next继续3、选择...
依赖配置cnpm install egg-redis --saveconfig/plugin.jsenable: false启用redisexports.redis = {enable: false,package: 'egg-redis',};config/config.default.jsconfig....
安装 Scrapy_redis 模块: pip3 install scrapy-redis 项目名/spiders/爬虫名.py(爬虫,分布式爬虫,继承RedisSpider):# -*- coding: utf-8 -*-import scrapyfrom scrapy_redis.spiders import RedisSpider# 导入RedisSpider# ...
爬虫
——爬虫
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 AtomGit AI 社区


 乐奇 Rokid 开放社区