登录社区云,与社区用户共同成长
邀请您加入社区
在5G MEC场景下,Prometheus的瘦身不是简单的功能裁剪,而是对监控范式的重新思考。通过架构解耦、协议优化和硬件协同,我们证明即使是最严苛的边缘环境,也能构建高效可靠的监控体系。未来,随着WebAssembly和边缘AI芯片的普及,这一领域将迎来更深刻的变革。
很多传统企业的监控现状是:Zabbix 跑了好几年,管着网络设备、存储、Windows 服务器和一堆老业务系统。这时候领导说要上 Prometheus,运维第一反应是——重复建设?其实不是。维度ZabbixPrometheus强项网络设备 SNMP、无 Agent 监控、Web 界面配置、告警收敛多维标签、PromQL 查询、容器/K8s、云原生生态弱项指标维度固定、查询能力弱、容器监控吃力配置文
这个运维 Agent 不是简单的 Demo,是在金融交付运维场景落地可用的自动化工具。核心思路不是让大模型做复杂推理,而是把 LLM 当成结构化文本汇总工具,依靠强约束 Prompt 规避幻觉,贴合金融行业对准确性、稳定性的硬性要求。整个项目从 0 到 1 踩了协议兼容、Prompt 拼接、指标采集不全、接口超时等一系列坑,最终实现每日自动巡检,解放运维人员重复的汇总工作。
本文介绍了Prometheus+Alertmanager告警系统与钉钉机器人的集成方案,通过自定义模板(monitor.tmpl)实现告警触发与恢复通知的可视化展示。模板支持按严重级别(严重/警告/提示)区分告警状态,包含实例、摘要、详情及时间信息,并在钉钉中以清晰格式呈现。文中提供了模拟告警触发与恢复的curl命令测试方法,验证了告警通知的完整流程,确保监控告警及时、准确地推送至团队。
本文介绍了基于Prometheus+Alertmanager+prometheus-webhook-dingtalk的钉钉告警通知实现方案。通过配置Prometheus采集服务器资源指标并触发告警,Alertmanager进行告警分组、抑制与通知管理,再由prometheus-webhook-dingtalk将告警转换为钉钉机器人可识别的Markdown格式消息,最终推送至钉钉群。文中详细阐述了各
WGCLOUD从v4.0.1版本开始,支持agent自动升级更新,从这个版本开始,往后就不用手动更新agent 了。
本项目从零构建了一套企业级 AIOps 智能运维平台:既有 K8s 集群搭建的硬核实操,也有 LangGraph Agent 的智能编排,更有“鉴权—分级—审批—自愈”的安全闭环。其价值不在于接入大模型本身,而在于用工程确定性约束模型不确定性,让 AI 安全可控地融入运维生产。源码仓库:Gitee。
本文以息壤冥想应用为例,展示如何基于魔珐星云端到端具身交互智能平台,通过六步配置(应用创建、形象、场景、音色、表演、服务)实现呼吸引导的全链路打通。借助SDK,将呼吸引擎、环境声场与数字人引导融合,打造可感知用户节奏、实时互动、多模态表达的虚拟引导师“安澜”。其核心在于让AI不仅“会讲”,更能“懂你”——随呼吸变化递进引导,支持语音追问,实现真正沉浸的陪伴式冥想体验,展现具身智能在心理健康领域的落
本文记录在 openEuler 22.03 环境下,基于已运行的 Prometheus、node_exporter 与 Grafana,接入 Alertmanager 及钉钉机器人实现中文告警通知的完整实践。通过二进制部署 Alertmanager 0.29.0 与 prometheus-webhook-dingtalk 2.1.0,配置规则分组、去重、静默及 Webhook 路由,并使用自定义中
打开 飞书 App(或网页版 https://www.feishu.cn)创建一个新群聊,点击右上角 设置→ 「群机器人」 → 「添加机器人」选择 「自定义机器人」名称可以自定义,例如:打卡通知打卡成功。点击「添加」,复制 Webhook 地址(一长串 URL,以 https://open.feishu.cn/open-apis/bot/v2/hook/ 开头)原文使用了“自定义关键词”安全规则,
本文详细梳理了Prometheus告警链路的完整配置流程,强调将告警链路拆解为“Prometheus→Alertmanager→webhook-dingtalk→钉钉机器人”四层,逐层验证连通性。通过部署prometheus-webhook-dingtalk、配置钉钉自定义机器人、启用恢复通知,并结合cpolar实现跨网络访问,确保每跳均可用。重点在于分步验证而非盲目集成,避免“告警已触发但无人知
本文分享了作者在时序数据预测中的痛点及使用TimechoAI大模型的实测体验。传统时序模型存在上手难、调参复杂、泛化差等问题,尤其对中小团队不友好。而TimechoAI作为专为时序场景设计的大模型,通过Python SDK与REST API轻松集成,支持原始数据直接输入,自动处理频率与预测任务,提供高精度预测及可信区间,显著提升开发效率与预测准确性,真正实现“零门槛”落地智能预测。
本文详述Prometheus+node_exporter+Grafana监控栈在openEuler/Ubuntu主机上的落地全流程,涵盖进程保活(systemd托管)、配置备份、资源限流(CPU/Memory/IO优先级)、端口释放与自愈验证。重点实现监控服务高可用、低负载侵入,通过分级采集策略(30s间隔)降低业务机压力,并提供回滚方案与健康检查,确保系统稳定运行。
本文介绍在鸿蒙(OpenHarmony)平台上使用 React Native 鸿蒙(RNOH)的 @react-native-oh-tpl/datetimepicker 库实现日期时间选择器的接入与使用。该库基于上游 @react-native-community/datetimepicker,适配鸿蒙 ArkUI 体系,支持 date/time 模式、多种显示样式(spinner/inline/
Redis承担缓存、分布式锁或限流等任务后,服务进程仍在运行,并不代表实例状态完全正常。内存持续增长、连接数接近上限、缓存命中率下降或主从同步异常,都可能在业务明显报错前逐渐出现。redis_exporter可以读取Redis的运行信息,并将内存、连接、命令、持久化和网络等数据转换为Prometheus能够抓取的指标。Prometheus再按照固定周期保存这些数据,并通过PromQL和告警规则判断
摘要: Prometheus+Node Exporter+cpolar组合为跨主机Linux监控提供高效解决方案。Node Exporter轻量采集服务器指标,Prometheus集中监控并告警,cpolar内网穿透实现公网访问,无需公网IP。适用于中小企业集中监控、个人开发者远程调试等场景,低成本、易操作,支持固定地址与安全访问,打破内网限制,实现随时随地监控。(150字) 关键词: Prome
是什么Nginx(engine x)是一个高性能的HTTP和反向代理web服务器,同时也提供了IMAP/IPOP3/SMTP服务。Nginx是由俄罗斯人伊戈尔·赛索耶夫开发的,第一个公开版本0.1.0发布于2004年10月4日。官网:http://nginx.org/其将源代码以类BSD许可证的形式发布,因它的稳定性、丰富的功能集、示例配置文件和低系统资源的消耗而闻名。2011年6月1日,ngin
摘要: 本文介绍了一套基于Prometheus+node_exporter+Alertmanager+cpolar的服务器监控方案,适用于Centos7等Linux系统。Prometheus负责实时采集服务器指标,node_exporter提供硬件数据,Alertmanager实现智能告警推送,cpolar解决内网穿透问题,使监控系统可通过公网访问。该组合能实现7×24小时自动监控、异常预警和远程
Prometheus监控Redis。
cd /opt安装包下载解压下依赖。
Redis → 部署 redis_exporter(端口9121) → Prometheus 抓取并打标签 → Grafana 导入 Dashboard →(可选)Prometheus Rule 告警。按以上步骤即可快速搭建 Prometheus 监控 Redis 的完整体系。
使用 Prometheus 和 Grafana 监控 Redis 的方案与监控 MySQL 类似,需要通过 Redis Exporter 来暴露 Redis 的监控指标,再由 Prometheus 采集并通过 Grafana 可视化。
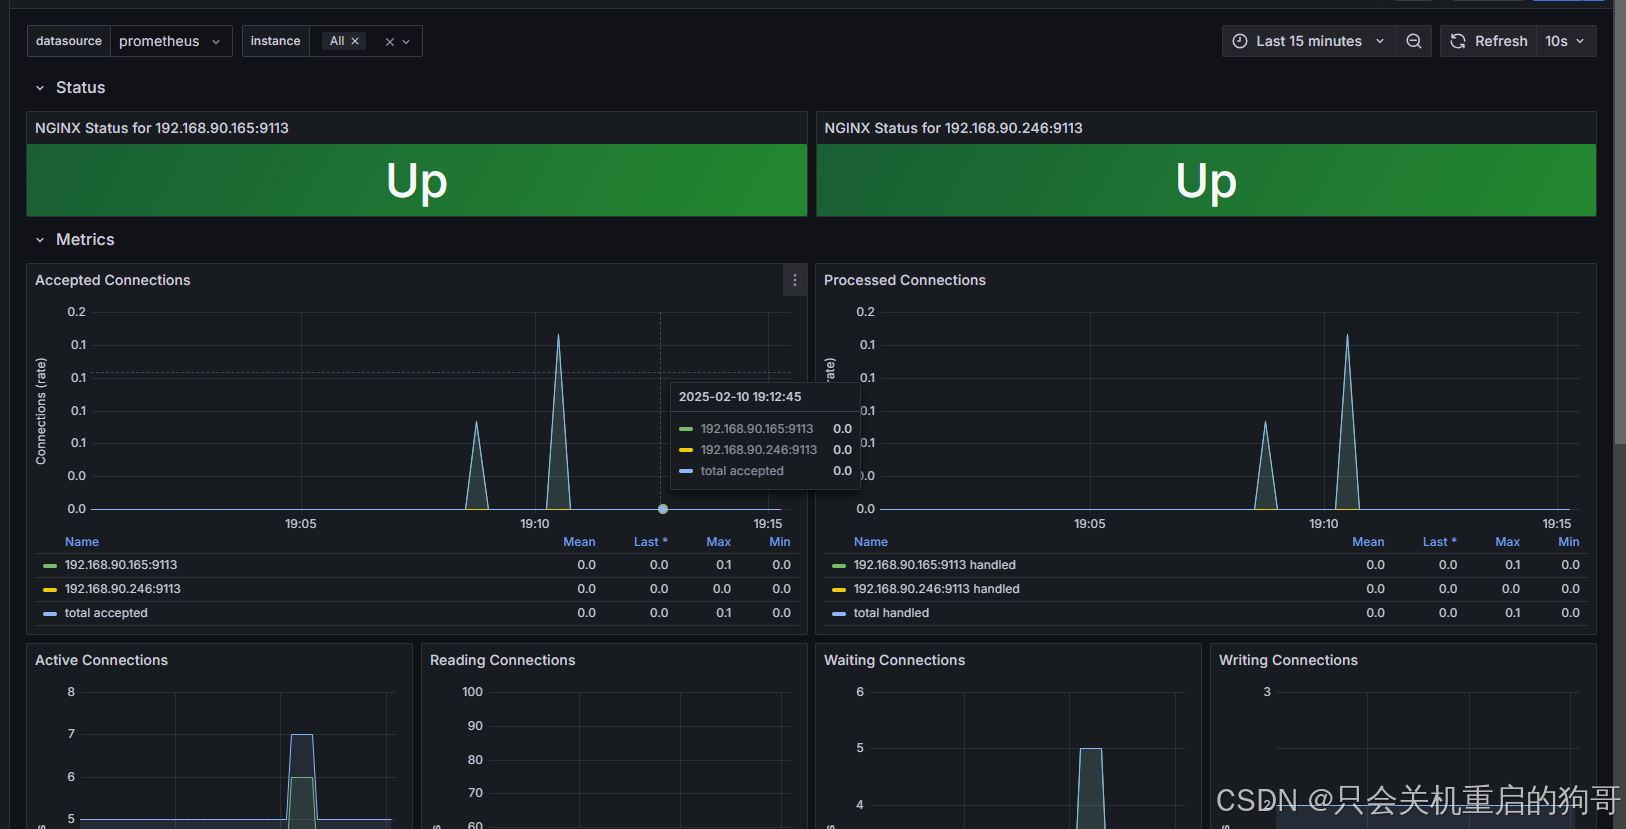
本文介绍了使用Prometheus+Grafana监控Nginx实例的完整流程。首先需配置nginx_status模块获取监控数据,然后通过Docker部署nginx-prometheus-exporter容器连接被监控的Nginx服务器(192.168.3.78)。测试成功后,在Prometheus配置文件中添加exporter任务(192.168.3.76:9113),最后在Grafana中导
本文介绍了Nginx监控的两种方案:1)官方nginx-exporter(社区版指标较少,plus版收费),适合基础监控;2)第三方nginx-vts-exporter,适合生产环境非plus版本。详细说明了两种方案的部署方式,包括Nginx配置、Exporter部署(支持Docker/K8s)以及Prometheus集成步骤。最后提到可通过开源Dashboard与Grafana集成可视化监控数据
prometheus.yml配置。
prometheus+grafana接入nginx实战
环境:docker ubuntu, 似乎不能使用systemd。nginx配置: 关键是最后的rewrite。
你的环境已经可以正常监控 ingress-nginx,后续只需关注 Grafana Dashboard 即可实时观察流量、错误率等关键指标!release: prometheus# 必须匹配 Prometheus 的 serviceMonitorSelector。- --enable-metrics=true# 启用 Prometheus 指标。- --metrics-per-host=true#
grafana中导入11835模块后查看redis监控信息如下。查看redis-exporter的yaml如下。创建serviceMonitor,yaml如下。创建角色权限,因为这个是跨namespace的。
【代码】使用prometheus下nginx-prometheus-exporter插件监控ngnix服务器。
通过以上步骤,你可以在 Linux 上成功安装并配置 Prometheus 和 Grafana。Prometheus 用于收集和存储度量数据,而 Grafana 则用于将这些数据可视化。两者结合使用能帮助你更好地监控和管理你的系统和应用性能。
服务器配置 prometheus.yml 文件
或者使用docker-compose运行,配置docker-compose文件。注:根据需求自行修改。
Prometheus监控nginx有两种方式。一种是通过nginx-exporter监控,需要开启nginx_stub_status,主要是nginx自身的status信息,metrics数据相对较少;另一种是使用nginx-vts-exporter监控,但是需要在编译nginx的时候添加nginx-module-vts模块,监控数据较多,提供了包含server、upstream以及cache的相
在生产环境下,您已经部署了 Prometheus 和 Grafana,并希望通过它们来监控另一台 Ubuntu 20.04 上的 Nginx 服务。
嘿!饭都喂到你嘴里啦。
python脚本自定义prometheus监控
Redis 接入 Prometheus 监控系统
1. 本文介绍两种安装方式,一种安装为service,使用systemctl start node_exporter管理,第二种为安装docker内 容器内使用。1.2.3上述这个文本,保存为docker-compose.yml, 然后下述命令需要在当前文件位置。1.2.2 我选择是1.8.1 下载好后,启动即可。,将Description换掉。1.1.3 解压缩,并命名为node_exporte
Nginx 不自带用于 Prometheus 的指标接口,但可以通过使用第三方模块或导出器来暴露相关的监控指标。通常,这些指标包括 HTTP 请求处理的各种细节、连接数、处理时间等。接下来,我们将详细介绍如何为 Nginx 开启指标接口,并配置 Prometheus 来抓取这些指标。
prometheus,本身是一个【数据收集】和【数据处理】的工具,如果效果要监控一台服务器物理机,有两种方式,一种是在物理机上部署“node-export”来收集数据上报给prometheus,另一种是“自定义监控”;node-exporter,就是将服务器物理机的数据,收集好,不需要运维人员自己配置了,是一个比较简单的监控物理机的组件;本节,我们就来讲述node-exporter的使用方式,及p
2.编译配置在nginx编译时添加vts模块下载官方的软件包并编译进vts模块,例如:3.安装:二、Nginx Conf配置更改Nginx Conf的配置,添加监控接口/status/:http {server {配置建议:1.打开vhost过滤:开启此功能,在Nginx配置有多个server_name的情况下,会根据不同的server_name进行流量的统计,否则默认会把流量全部计算到第一个se
这些步骤概括了从下载到设置自动启动的整个流程。如果你遇到任何具体问题或需要更详细的帮助,随时告诉我!在 Linux 系统中使用二进制文件安装。创建一个没有登录权限的新用户。,以便可以用系统服务管理。
(img-f4TJicEN-1713345331146)]3,创建ServiceMonitor,注入promethu。5,增加grafana模板。6, 进入监控看大屏。插入刚刚官网的id号。
prometheus
——prometheus
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区


 北京朝阳AI社区


 DAMO开发者矩阵


 openEuler 社区


 2048 AI社区

 开源鸿蒙跨平台开发者社区


 乐奇 Rokid 开放社区