登录社区云,与社区用户共同成长
邀请您加入社区
通过合理配置滚动策略,IoTDB可在保障日志完整性的同时,实现存储资源的高效利用。具体参数需根据业务负载和存储条件动态调整。时序数据库的日志管理是保障系统稳定性的关键环节。Apache IoTDB通过**日志切割(Rolling)归档(Archiving)**策略解决日志文件无限增长问题,其实现基于Logback框架的配置优化。后,日志存储成本降低83%,故障排查时日志定位效率提升40%。:某工业
Release Announcement Version 1.2.2Apache IoTDB v1.2.2 已经发布,主要增加了 flink-sql-iotdb-connector 插件、tsfile 文件级级联传输、count_time 聚合函数等新特性,优化了 Limit & Offset 查询性能、ConfigNode 重启逻辑等,并提升压缩效果、删除操作效率、对齐序列合并速度...
维度IoTDB 优势(2026 版)对比其他 TSDB适用场景数据模型树形结构:设备 → 序列(支持对齐/非对齐)更灵活于 InfluxDB 的标签系统多设备 IoT 数据写入性能单机 >1M 点/秒,分布式 >10M 点/秒优于 Prometheus / TimescaleDB高频传感器数据查询性能时间窗口聚合、降采样、UDF 支持SQL 兼容强,内置时序函数实时监控 / 历史分析存储效率TsF
Apache IoTDB采用。
时序数据库 Apache IoTDB 实战:基于 Kubernetes 的部署运维全指南
本次针对对齐序列手动创建时间,设置时间序列的类型都为 float,后面因为设备添加了点位,上报的数据被自动写入对齐序列,自动创建的时间序列类型是 double 类型,为了类型能统一,切记一定要先在数据库中创建时间序列,再添加设备的点位读取,否则就要手动修改自动创建的时间序列类型,由于官方并不支持直接修改时间序列的类型,下面是变相修改时间序列类型的步骤。
部分小伙伴根据安装教程无法运行IoTDB的start-standalone.bat文件,一打开就闪退,是因为新版本Windows逐渐弃用wmic,导致行为不稳定。进 conf 目录 然后 把confignode-env.bat 与datanode-env.bat替换成我给的文件。start-standalone.bat文件与start-cli.bat文件就可以了。以上仅个人经询问IoTDB官方人员
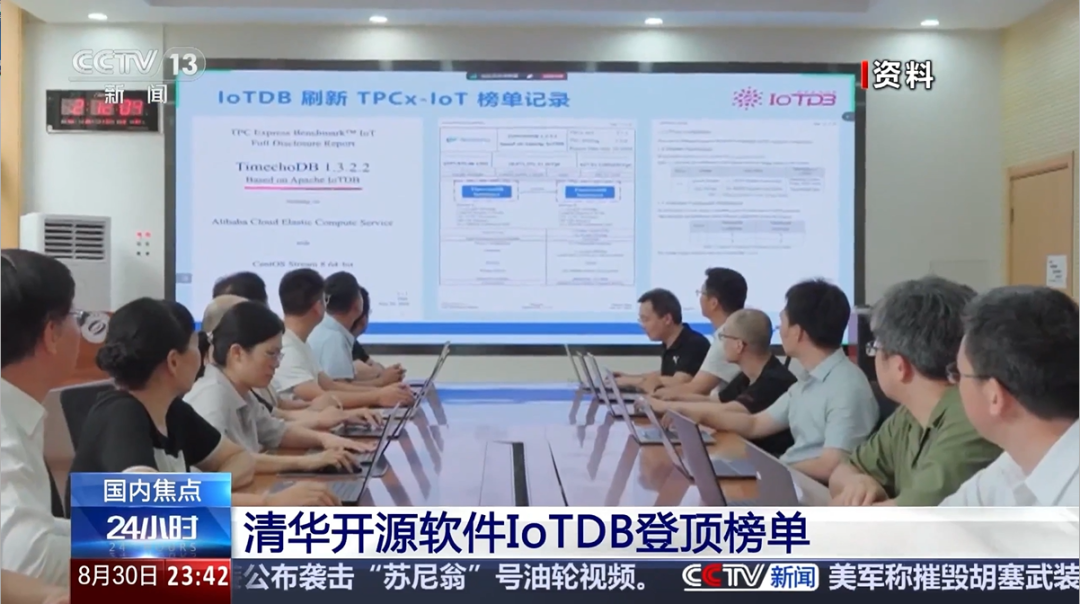
8 月 30 日,央视《24小时》节目报道了源于清华大学软件学院的国产开源时间序列数据库 IoTDB 登顶数据库国际权威榜单 TPCx-IoT,性能、性价比双指标刷新世界纪录。以下为新闻原文:今天,在广州举行的数据库国际基准委员会 TPC 年度大会上,公布数据库事务处理性能权威榜单,清华大学软件学院发起研制的国际开源时间序列数据库 Apache IoTDB 刷新了工业物联网场景榜单,在性能和成本维
语法约定
本文讲解Apache IoTDB选型指南。其原生树形模型完美匹配工业设备层级,凭借端边云协同架构与高压缩TsFile格式,在边缘计算与存储敏感场景优势显著,是推动国产化替代、挖掘物联网数据价值的关键技术选择。
因此,若直接应用现有的数据库外时序聚类方法,必须将所有数据完全加载到内存中,并重新按时间排序,且每次处理跨不同时间范围的查询时都需从头开始聚类,效率低下。在物联网(IoT)场景中,随着传感器数量的不断增长,集群也会随之扩展,重新平衡存储的一种常见方法是迁移现有分区,但这会产生额外的开销。这对时间序列数据管理提出了新的需求,而现有解决方案未能充分应对这些需求,包括:设备定义的持续演进模式、周期性的数
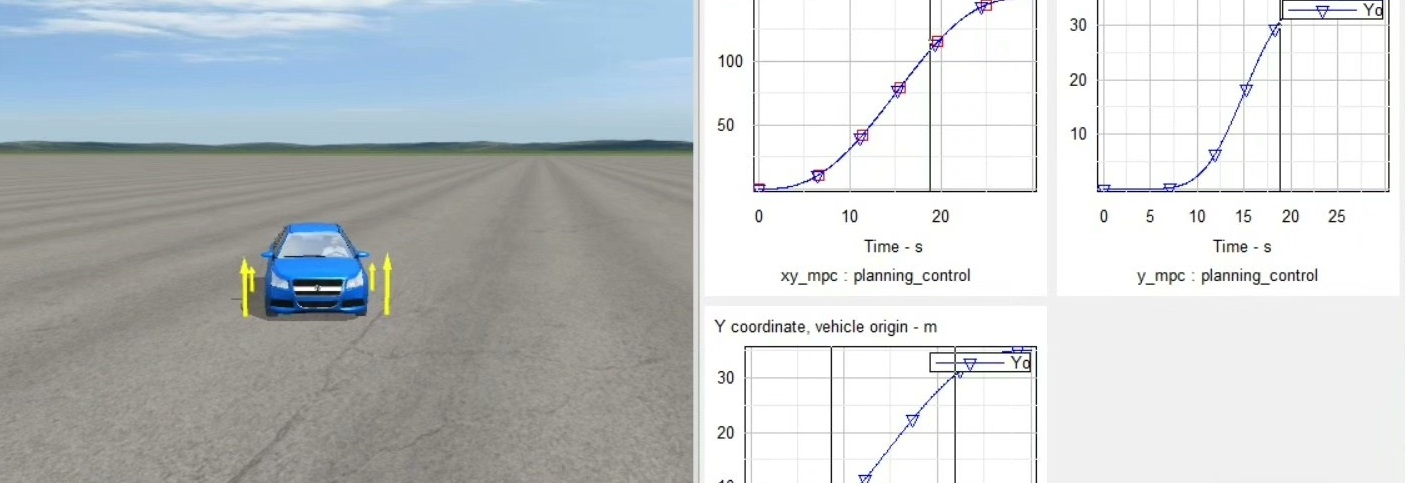
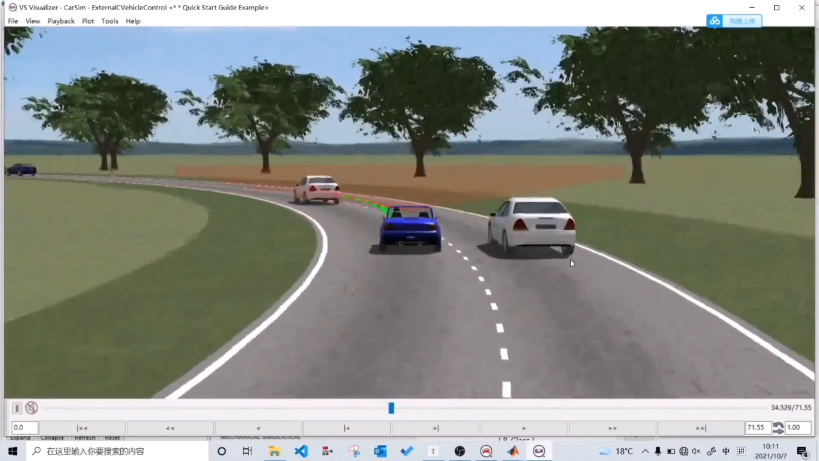
注意看Q矩阵的系数设置——横向位移的权重是纵向的2倍,这可不是随便填的数,实战中发现加大横向误差惩罚能有效防止"画龙"现象。随包的案例文件已经调好了所有参数,直接导入就能看到丝滑的超车轨迹。把CarSim的动力学模型和Simulink的智能算法结合,这事儿就像给赛车手装了个AI大脑。有个取巧的方法——在模型里加个示波器同时监控这三路信号,确保它们的时延差不超过2个仿真步长。CarSim与Simul
IoTDB 通过多层缓存设计将元数据热区加载到内存,减少磁盘随机 IO 开销,提升查询响应速度。其核心价值在于平衡内存占用与元数据访问效率,尤其适合工业物联网场景下设备元数据规模动态变化的业务需求。启动时通过懒加载策略将部分元数据加载到内存,后续访问时通过 LRU 算法动态调整缓存优先级。写入操作通过 WAL 日志保证数据持久性,元数据变更先写入内存再异步刷盘,避免每次更新触发磁盘 IO。在 10
→ 是 → Amazon Timestream。→ 是 → TimescaleDB。→ 是 → TDengine。→ 是 → IoTDB。
修复 last 查询的 where time > X and time <X 未应用于分区表拉取,无法命中 PartitionCache 的问题。修复单设备或多设备跨 region,聚合查询 order by time + align by device 报错的问题。修复大 TEXT 对象 + align by device + order by time 查询报内存不足的问题。我们为大家提供了参
选型决策矩阵需求场景推荐版本配置建议超高频采样(>10kHz)IoTDB 1.0集群版启用TsFile压缩多数据中心同步IoTDB 1.2+配置跨机房副本实时流分析启用TsFile-HDFS适配性能优化口诀一调JVM内存,二优磁盘IO,三扩DataNode数,四分时间区间。🔥🔥🔥道阻且长,行则将至,让我们一起加油吧!🌙🌙🌙。
支持两卫星星间交换监控数据:管理卫星的 CPU 负载、温度、电压等测点数据,并通过双活架构建立星际双副本传输,实现星间数据实时同步,构建高可用太空数据库。值得一提的是,作为高性能国产时序数据库,IoTDB 为朱雀二号改进型火箭试验提供了高效数据管理支撑,同时为天仪 45 星(北邮二号)和天仪 46 星(北邮三号)提供了卫星间的数据互备份、星地数据协同、不定期关机场景下数据的断点恢复与续传等能力,实
数据派THU作为数据科学类公众号,背靠清华大学大数据研究中心,分享前沿数据科学与大数据技术创新研究动态、持续传播数据科学知识,努力建设数据人才聚集平台、打造中国大数据最强集团军。为天仪 45 星(北邮二号)和天仪 46 星(北邮三号)提供了卫星间的数据互备份、星地数据协同、不定期关机场景下数据的断点恢复与续传等能力,,天算星座是北京邮电大学发起并主导建设的开放开源卫星研究平台,旨在使全球学术界能够
摘要:本章是java环境下升级V2.0.2IoTDB环境下的一些配套升级和注意点。
iotdbtool 是一个使用 Go 语言编写的命令行工具,基于 Kubernetes 环境,提供了 IoTDB 数据的备份功能。它可以从 Kubernetes 集群中的 IoTDB Pod 中提取数据,并将其上传到阿里云 OSS 存储桶中。iotdbtool 支持 iotDB 单机、集群,备份与恢复,备份文件存储在 oss 上,主要实现了 k8s 部署的有状态服务的备份恢复。
IoTDB 在 TPCx-IoT 榜单的 What 与 Why 解答!
专注物联网场景特点,详解 IoTDB 设计的数据分片与负载均衡策略。我们都知道,当数据库服务的业务负载增加时,往往需要扩展服务资源,一般有两种扩展方式:纵向扩展和横向扩展。纵向扩展是指增加单台机器的能力,比如增加更多的内存、硬盘和更强的处理器。这种方法有一个限制,就是单台机器的硬件能力是有上限的。横向扩展是指增加更多的机器,把数据和处理请求分摊到多台机器上。这种方法更加灵活,因为可以不断增加机器,
好评满满的【IoTDB 视频小课】系列又来了~关于 IoTDB,关于物联网,关于时序数据库,关于开源...你想学习的重点,给我们 3-5 分钟,清晰地讲给你听:时序数据库VS实时数据库工业数字化转型愈发受到重视的当下,处理实时性强的工业数据有两类“热门”软件。一类是如 IoTDB 的时序数据库,一类是实时数据库。你是否了解这两个概念的异同呢?未来这两类产品的发展趋势又可能是什么?今天我们将为大家.
示例 2: 查询 root.ln.wf01.wt01 下 status,temperature 时间戳大于等于 2017-11-07T23:50:00 的最新数据点。在物联网数据分析场景中,此功能尤为重要。为了满足了用户对设备实时监控的需求,Apache IoTDB 对最新点查询进行了缓存优化,能够提供毫秒级的返回速度。示例 3: 查询 root.ln.wf01.wt01 下所有序列的最新数据点,
时序数据智能管理新高度:Apache IoTDB技术解析 Apache IoTDB作为新一代时序数据库,凭借创新的TsFile存储格式和极致的压缩技术(15-20倍压缩比),实现了毫秒级查询和百万级数据点写入能力。其核心优势包括: 革命性架构:专为时序数据优化的列式存储+多级索引体系 部署灵活性:端边云一体化架构,最小512MB内存即可运行 企业级可靠性:多副本机制+自动故障检测,可用性达99.9
本文系统性地介绍了时序数据库及其选型标准,重点分析了Apache IoTDB的核心技术架构与应用优势。文章首先定义了时序数据库的特点,提出了五维评估框架(性能、存储、运维、生态、成本),并对比了主流时序数据库的性能表现。随后深入解析了IoTDB的三层部署架构、数据处理流水线和智能压缩算法体系,展示了其在车联网、智能运维等场景的应用价值。最后提供了IoTDB的环境准备与安装部署指南,为读者构建了从理
《时序数据库选型指南:从IoTDB看未来数据管理趋势》 本文全面剖析了时序数据库的核心特性与应用场景。随着物联网和大数据技术的普及,时序数据库凭借高效写入、压缩存储和快速查询能力,在工业监控、金融分析等领域展现出独特价值。文章重点介绍了国产开源时序数据库IoTDB的四大优势:树状数据模型与工业场景高度契合、自研TsFile格式实现超高压缩比、强大的乱序数据处理能力,以及轻量化的边云协同设计。通过上
的主题演讲介绍了工业时序数据的管理挑战,与国产自研时序数据库 IoTDB 的性能优势、实践案例情况,并详细阐述了 IoTDB 2.0 最新版本所实现的树表双模型架构与其对应建模场景。在 AIoT 爆发、智能制造数字化升级背景下,如何利用时序数据库的端边云协同、AI 深度分析等多项特性,构建自主可控的数据基础设施,7 位领域专家与线下和线上直播中。,进一步拓展了 IoTDB 的应用场景与效能,并降低
FQDN = Fully Qualified Domain Name,全限定域名。通俗讲,就是「一台机器在网络上的完整名字」。名称例子说明hostname(短名)td1机器自己的短名字,hostname命令可查看FQDN(全限定域名)带完整域名的名字,可查看IP 地址网络地址,会随环境变化为什么 TDengine 不用 IP,而是用 FQDN 来标识机器?机器换 IP、换网段时,只需改 hosts
安装maven3.9.6以上版本执行编译iotdb启动,使用安装包sbin目录下的start-standalone.bat执行报错如果是内存问题,可以在对应的node配置中修改,如conf\datanode-evn.bat中修改。
原理
最近在Carsim+Simulink联合仿真里搞了套横纵向控制器,实测在双移线工况下横向误差能压到0.2米以内,纵向速度误差控制在±3km/h,虽然离完美还有距离,但已经能看出这两个经典算法的实战能力。自动驾驶横纵向控制,纵向采用pid控制,横向采用mpc控制,根据的是车辆二自由度车辆动力学模型,得到各矩阵之后在S函数里面进行编写,纵向参考百度Apollo纵向双环PID控制算法,横向参考百度Apo
物联网场景下,时序数据库的选型直接影响数据存储效率与查询性能。对于超大规模物联网部署(如车联网百万级设备),IoTDB的分区策略和国产化优势更明显。基于TSM(Time-Structured Merge)存储引擎,采用倒排索引加速时间范围查询。IoTDB在批量写入场景下可达百万级数据点/秒,InfluxDB单节点写入约10万-50万数据点/秒。适合设备层级明确的工业物联网场景,如电力监控中变电站-
IoTDB采用分层架构,支持从边缘设备到云端的数据全生命周期管理。在相同硬件环境下,IoTDB相比InfluxDB写入吞吐量提升3.2倍,查询延迟降低67%。IoTDB作为Apache顶级项目,专为物联网场景优化,提供高吞吐、低延迟的时序数据存储方案。某风电集团采用IoTDB后,2000+风机传感器数据存储成本降低70%,实时故障诊断响应速度从分钟级提升至秒级。智能家居平台通过IoTDB的边缘版实
ApacheIoTDB是一款专为物联网设计的开源时序数据库,由清华大学团队开发,已成为Apache顶级项目。它针对物联网数据特点(海量、高并发、时序性)提供高效解决方案,具备数据压缩、高速写入、灵活查询等优势,支持"端-边-云"协同架构。适用于工业监控、车联网等场景,能与Spark、Grafana等工具集成,是管理物联网时序数据的理想选择。
工业 4.0 与数字化转型中,海量传感器时序数据成企业核心资产。IDC 预测 2025 年全球时序数据将占总数据 30% 以上,为多领域核心生产要素。但传统数据库处理时序场景存性能与成本瓶颈,Apache IoTDB 作为中国自主研发 TSDB 标杆,凭 “自主可控、场景适配、生态开放”,重新定义时序数据基础设施价值。
在python使用sql查询,column1返回值0,column2返回值1。使用多个方法读取sql结果都与dbeaver查询结果不一致。在数据库客户端dbeaver查询,column1返回值1,column2返回值0。在java使用sql查询,column1返回值1,column2返回值0。查询iotdb表A,column1,column2。可能原因:python版本与iotdb存在冲突。
随着数据库领域三大国际顶级会议 ICDE、SIGMOD、VLDB 2024 会议落幕,我们骄傲的宣布 Apache IoTDB 团队成员的多篇论文均被收录!
iotdb
——iotdb
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区





 天工造物局






 DAMO开发者矩阵




 2048 AI社区