- @2301_80395604


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本系统采用Python与Django框架构建,前端基于Vue与Echarts呈现,核心依托Hadoop与Spark大数据生态。系统针对宫颈癌变光谱特征数据,实现了数据上传、分布式存储、Spark清洗及特征提取功能,并通过可视化大屏展示分析结果,有效检验了大数据技术在医疗数据处理场景的落地效果,是一套技术完善的毕设方案。

本系统利用Hadoop与Spark处理大规模轨迹数据,通过Django搭建后端接口。系统实现了智能体分布、动作选择率、策略熵分布等十六项核心数据分析功能,并运用K-Means聚类、FP-Growth序列挖掘及Isolation Forest异常检测算法探索轨迹模式。最终结合Vue与Echarts实现数据可视化,帮助用户直观理解强化学习智能体的决策过程与行为特征。

系统基于Hadoop与Spark大数据框架,结合Django后端与Vue前端技术,专注于跨平台消费者评论的情感强度分析。系统通过预处理机制生成实体标签与情感强度,利用Spark SQL及Pandas完成热度榜、时段活跃度等宏观统计,并融合K-Means聚类、孤立森林异常检测与FP-Growth关联规则算法,计算实体活跃画像与异常热度点,最终通过Echarts实现数据可视化展示。

基于Hadoop+Spark的中国火车站站点地理数据可视化分析系统 毕业设计 Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy如果你觉得内容不错,欢迎一键三连(点赞、收藏、关注)支持一下!欢迎在评论区留下你的想法或提出宝贵意见,期待与大家交流探讨!谢谢!

本系统是一个基于Spark的生成式AI软件服务用户行为与算力消耗数据分析与可视化系统。技术采用Python语言,依托Hadoop与Spark框架处理海量数据,结合Django和Vue实现前后端搭建。系统覆盖套餐占比、Token消耗、采纳率等分析功能,并融合K-Means、FP-Growth及Isolation Forest算法对用户分群、关联规则与异常算力进行挖掘,最终通过Echarts直观呈现数

本课题设计并实现了一个基于Hadoop的电商与本地服务消费评论数据分析系统。系统利用HDFS存储海量数据,通过Spark进行多维时间切片统计与总体量排名,计算波动系数和零值小时比。核心模块引入K-Means对实体行为聚类,用Isolation Forest揪出异常波动实体,并借助FP-Growth挖掘活跃时段关联规则,最终通过Echarts实现可视化展示。
基于协同过滤算法的美食推荐系统 计算机毕设选题推荐 python毕设 大数据毕设 可适用毕业设计 课程设计 实习项目 附源码+安装+讲解+文档

【从0带做】基于推荐算法的在线课程推荐系统的设计与实现 【附源码+讲解+部署】适合作为毕业设计,课程设计,实习项目
Hadoop+Spark计算机毕设选题:烟酒成瘾数据分析系统的大数据技术栈完整实现方案毕业设计/选题推荐/深度学习/数据分析/数据挖掘/机器学习/随机森林/数据可视化/大屏/预测/爬虫/推荐算法
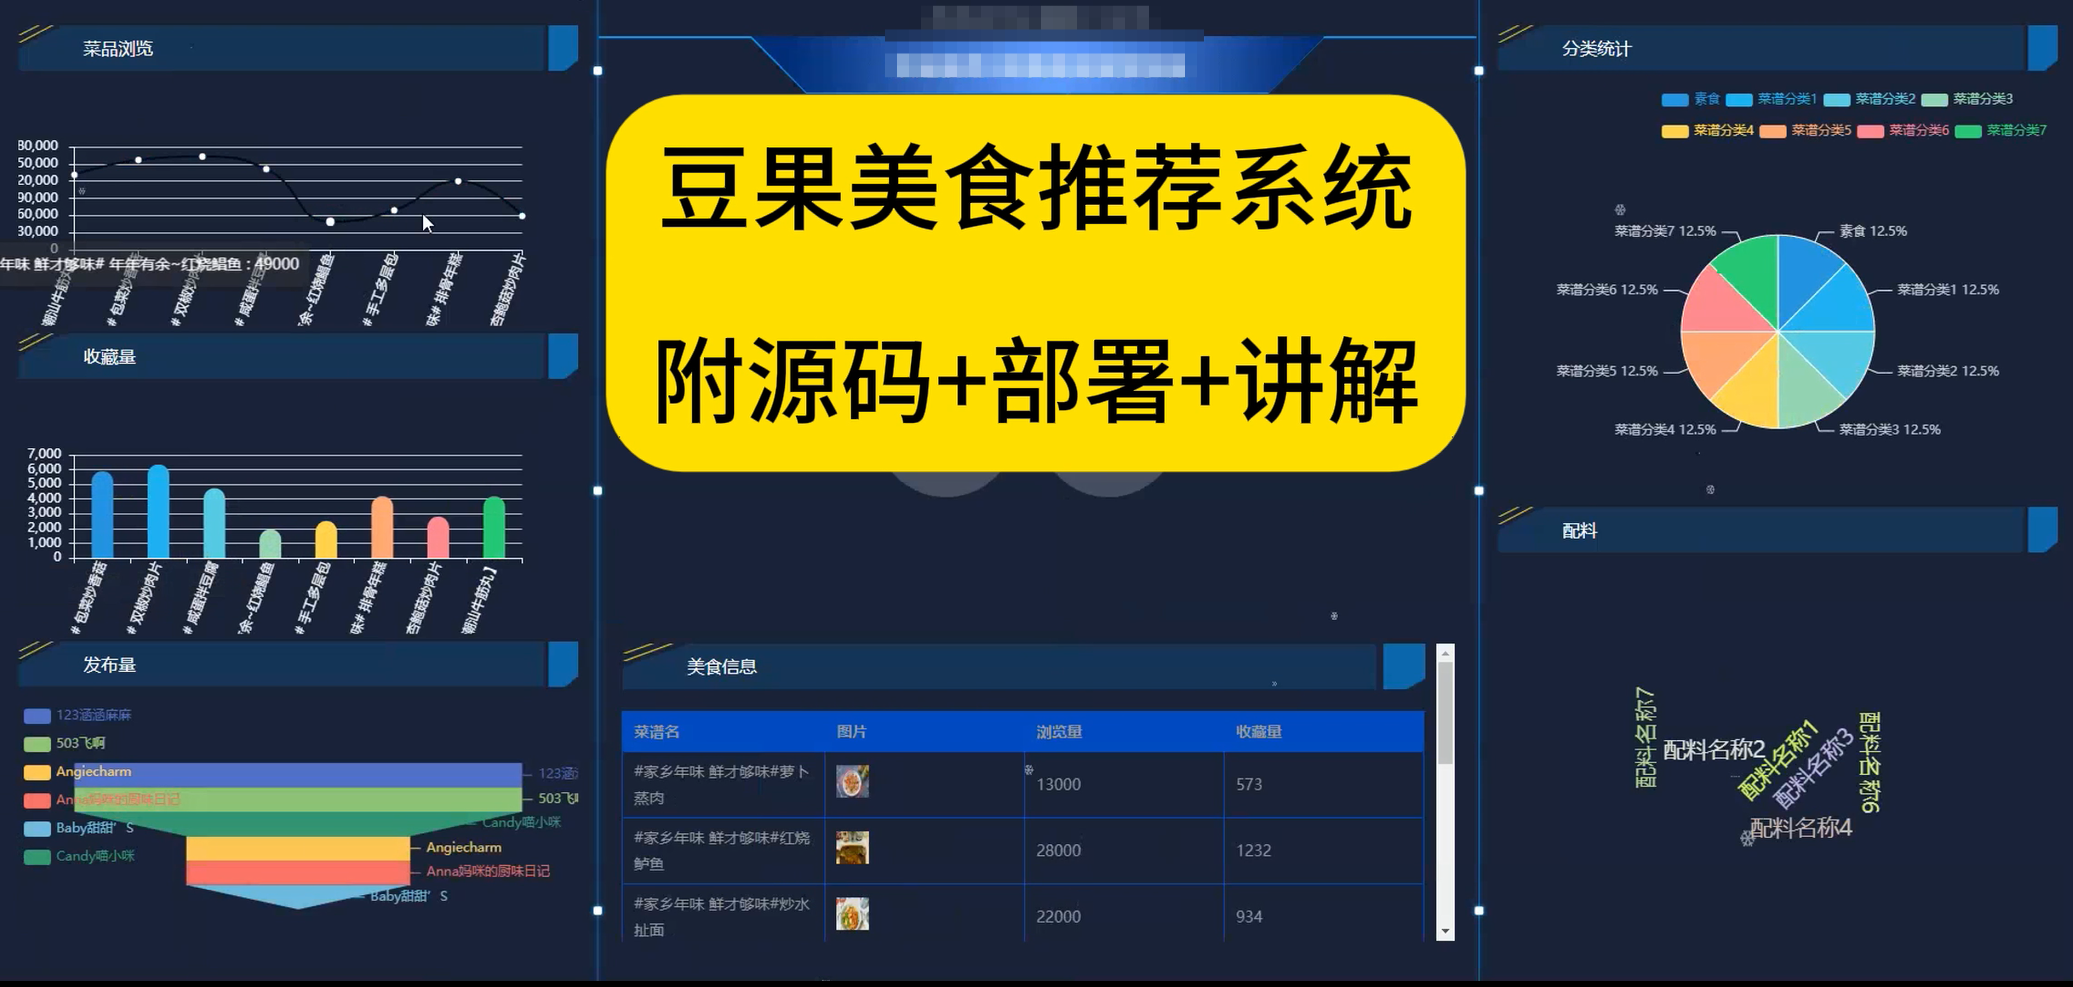
【计算机毕业设计选题推荐】基于python的豆果美食推荐系统的设计与实现 【附源码+安装调试+视频讲解】