登录社区云,与社区用户共同成长
邀请您加入社区
ip操作系统内存硬盘部署的服务centos8G200Gkafkacentos8G200Gdoriscentos8G200GfineBIcentos8G200Gflume。
分别对应 jobmamager taskmanager taskslot 由 taskslot 执行任务 每个。时间为 0-10分钟这个窗口内的数据 第二次 为 1-11分钟这个窗口内的数据 以此类推。比如如下为 10分钟一个窗口 然后间隔时间为 1分钟那么 第一次计算的窗口。根据数据条数触发计算 比如如下就是 每来五条计算一次 并且并行度 等于1。根据固定时间确定一个窗口 然后间隔一定的时间触发
水位线 = 12-2 = 10>10(窗口时间) 那么这个时候刚好可以触发计算 12分钟到的那条数据也被包含在了这个窗口。举个例子 当前 窗口时间为10分钟 但是有一条本应该9分钟到的数据 12分钟才到 那么你可以设置。时间为 0-10分钟这个窗口内的数据 第二次 为 1-11分钟这个窗口内的数据 以此类推。比如如下为 10分钟一个窗口 然后间隔时间为 1分钟那么 第一次计算的窗口。允许延迟的时间
环境为 ubuntu 16.04,ip:192.168.1.100,单机模式0x00.JAVA环境搭建0x01.kafka环境搭建1. zookeeper启动:./zkServer.sh start-foreground2. kafka为了使kafka能够通过ip访问,需要修改`conf/server.properties`文件:advertised.lis...
Sink Processors类型包括这三种:Default Sink Processor、Load balancing Sink Processor和Failover Sink Processor。Default Sink Processor是默认的,不用配置Sink group,就是咱们现在使用的这种最普通的形式,一个Channel后面接一个Sink的形式;
总结一下在学 Flume的故障转移和负载均衡的知识和经验总结
1 查卡我的hadoop支撑的压缩方式hdfs 配置控制台收索:io.compression.codecs可见没有LzopCodec方式2LzoCodec和LzopCodec区别LzoCodec和LzopCodec区别两种压缩编码LzoCodec和LzopCodec区别:1. LzoCodec比LzopCodec更快, LzopCodec为了兼容LZOP程序添加了如 bytes signature
一、首先更加数据的表结构在hive中进行表的创建。 create table AREA1(unid string,area_punid string,area_no string,area_name string,area_dept_unid string,area_longitude string,area_latitude string,area_sortid string,c
在如今互联网行业中,数据的收集特别是日志数据的收集已经成为了系统的标配。将用户行为日志或者线上系统生产的数据通过flume收集起来,存放到数据仓库(hive)中,然后离线通过sql进行统计分析,这一套数据流的建设对系统有非常重要的意义。 1、思路:1)线上系统通过log4j将数据打印到本地磁盘上;2)在线上系统服务器上安装flume,作为agent使用exec source将线上系...
应核查服务水平协议或服务合同中是否规范了安全服务商和云服务供应商的权限与责任,包括管理范围、职责划分、访问授权、隐私保护、行为准则、违约责任等。应核查服务水平协议或服务合同中是否规范了安全服务商和云服务供应商的权限与责任,包括管理范围、职责划分、访问授权、隐私保护、行为准则、违约责任等。2、应核查云计算平台建设方案,云计算服务器、存储设备、网络设备、云管理平台、信息系统等运行业务和承载数据的软硬件
问题一:在hadoop3.1.3上使用Flume上传日志文件至hdfs时有可能会出现错误如下图:该错误的原因是flume中的guava-11.0.2.jar版本较低。解决方法是:删除flume中的对应的低版本guava-11.0.2.jar再将hadoop3.1.3中对应的高版本拷贝到flume中,高版本guava在hadoop3.1.3/share/hadoop/common/lib下的guav
kafkakafka中文教程Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据。 kafka的设计初衷是希望作为一个统一的信息收集平台,能够实时的收集反馈信息,并需要能够支撑较大的数据量,且具备良好的容错能力.Apache kafka是消息中间件的一种。一 、术语介绍BrokerKafka集群包含一个或多个服务器,这种服务器被称为broke
Flume的自定义拦截器、复制选择器、多路选择器、自动容灾、负载均衡
如果命令输入后无回显,则表示没有这个相关连接,有回显后查看对应的状态,如果存在 ESTABLISHED 这个状态的,那么八九不离十对应连接的IP就是数据库服务器,例如上图数据库服务器为172.17.200.13。,有些运维人员习惯不好,比如需要更新tomcat 的系统版本,他会下载一个新的版本,但是老版本他也不会删除,这就是为什么有时候我们去查看的时候会发现操作系统上存在多个中间件。那么通过这样的
为了能成功通过等级测评,企业要根据等级保护建设要求,对信息和信息系统进行网络安全升级,对定级对象当前不满足要求的进行建设整改,包括技术层面的整改,也包括管理方面的整改。这类问题的整改我们统称为安全服务整改建设,整改时需要做到:把安全防护设备硬件配置合适正规的策略,主机及应用做应有的结构加固,关闭不必要的端口,对高危漏洞进行打补丁,合理划分不同网络区域等等。具体的等保整改方案是没有的,因为每一个企业
云剪贴板 - 洛谷 | 计算机科学教育新生态 (luogu.com.cn)
【代码】电商风控系统(flink+groovy+flume+kafka+redis,2024年最新值得一看。
Flume学习---2、Flume进阶(事务)、负载均衡、故障转移、聚合
Flume部署,Kafka(包含自带zookeeper)部署,Flume整合Kafka
java.lang.NoClassDefFoundError: org/apache/hadoop/conf/Configurationflume-ng 启动后错误如下:flume配置flume数据ETL配置文件:原因分析启动flume的serve上没有安装hadoop, 没有配置hadoop的环境变量.导致flume启动时无法查找到所需的hadoop依赖.export HADOOP_HOME=/
尚硅谷电商数仓superset
Flume 理论、简介、特点、结构;创建并解压配置文件Flume、配置 flume-env.sh文件、Flume环境变量;配置conf、分发文件;Flume的conf 多种部署。显示结果是过滤数据、通过netcat作为source, sink写到hdfs、通过HTTP作为source, sink写到logger、多节点进行串联。
解决flume采集hive日志写到hdfs问题在配置flume写日志到hdfs发现写不进去,很苦恼,查了很多资料,终于找到了原因!原来用Flume监听目录,在自己建的.conf文件中需要配置hdfs的路径hdfs://node1.itcast.cn:8020/flume/%Y%m%d/%H这里的端口号应该和hadoop下的core-site.xml里面的配置必须一样,否则就会出现写不进去的情况更改
hive安装hive内置元数据库Derby,但一般采用自有的元数据库,这里用mysqlhive集群分配:软件warehouse101warehouse102warehouse103hadoop√√√hive√√√mysql√元数据(metastore)采用远程模式配置,配置规划:服务warehouse101warehouse102warehouse103metastore√√HiveServer2
# Kafka启动服务安装配置好zookeeper,添加好环境变量,打开cmd,输入命令启动服务。zkServer在%KAFKA_HOME%目录,按shift+鼠标右键,选择“在此处打开命令窗口”,在控制台输入命令启动服务。.\bin\windows\kafka-server-start.bat .\config\server.propertieskafka命令创建主题.\bin\windows\
第五讲
这里写自定义目录标题使用flink采集kafka数据后存到mongodb实体类mongodb工具类MongoDBSinkFlinkTestpom文件使用flink采集kafka数据后存到mongodb话不多说直接上代码实体类import java.io.Serializable;public class FlinkDao implements Serializable{private String
flume到kafkahttpsourceflume到kafkahttpsource 定义一直出错,这边是以接口的形式采集数据推到kafka 但是 这边给的接口是需要拼接。这种的接口形式的如何实现flume采集数据到kafka。下面是获得数据的方式5.测试准备首先将flume配置完毕,参考flume的单机版配置及测试hadoop集群搭建完毕,参考hadoop单机版搭建,hadoop集群搭...
flume加载数据hive sink;kafka sink
上一篇文章《 linux安装flume和集成kafka测试》,我们介绍了flume安装和集成数据到kafka,本篇文章我们将集成kafka,flume,hadoop,通过flume发送kafka数据到hadoop的hdfs文件。一.前期准备1.1 hadoop安装版本:Hadoop 2.6.5安装: linux hadoop完全分布式集群搭建图文详解1.2 zookeeper安装版本:zookee
centos 6.4通过flume采集rsyslog发送的linux secure日志,并发送到ES中,通过kibana来展现。
随着科技的发展,锂离子电池在各种电子产品中的应用越来越广泛。为了满足不同设备的充电需求,充电管理IC也得到了迅速的发展。其中,升降压型充电芯片支持双节串联8.4V/12.6V充电管理IC成为了一种备受关注的新型充电解决方案。
鉴于实在是比较少python相关是spark streaming的例子,对于自己实现的测试例子分享上来一起讨论。强烈建议scala去写spark streaming程序,python资料太少,翻遍github也才发现几份代码
比如用到了%Y%m%d/%H,但没传时间进去,设置使用本地时间戳就行hdfs.useLocalTimeStamp = true。配置文件解析出了问题。
环境配置要注意配置好:JAVA_HOME, HADOOP_HOME, HADOOP_CONF_DIR,选择名称最短的那个tar包:然后把安装包解压后记住路径:(我的是:"E:\hadoop-2.7.1")最后还要添加hadoop.dll和文件到你的bin目录下。将hadoop.dll和文件复制粘贴一下即可。
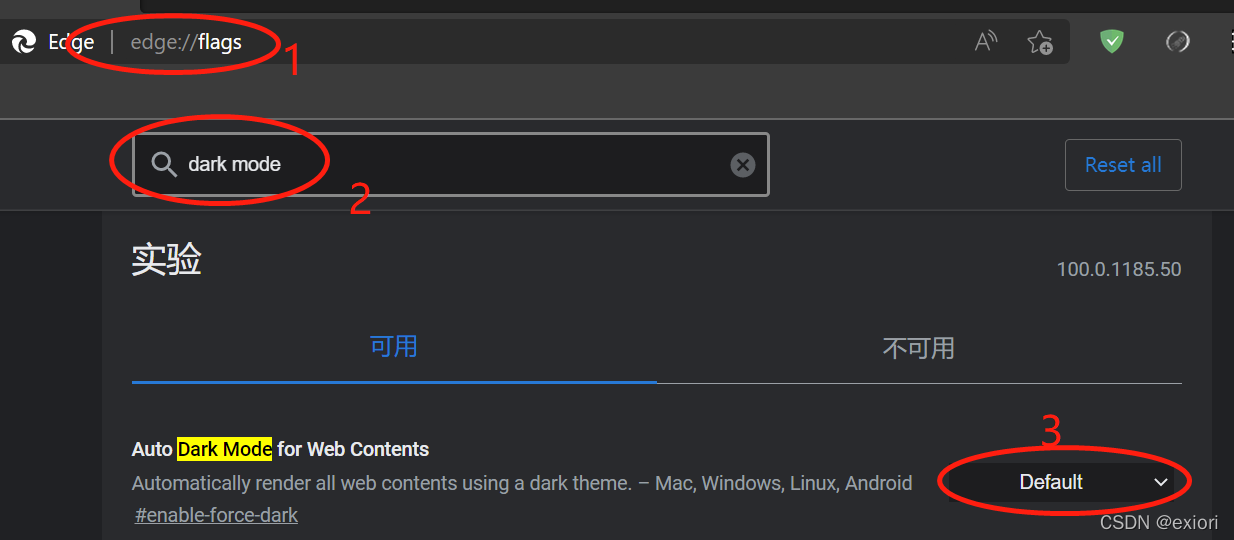
浏览器修改暗色主题edge://flags/ 与 chrome://flags/win 修改背景颜色为绿色,保护眼睛复制以下代码,保存为.reg 文件运行Windows Registry Editor Version 5.00[HKEY_CURRENT_USER\Control Panel\Colors]"Window"="202 234 206"打开win10夜间模式,调整效果...
flume启动一直报错ERROR - org.apache.flume.SinkRunner$PollingRunner.run(SinkRunner.java:158)] Unable to deliver event. Exception follows.,报错详情如下2021-12-27 20:41:52,509 (SinkRunner-PollingRunner-DefaultSinkPr
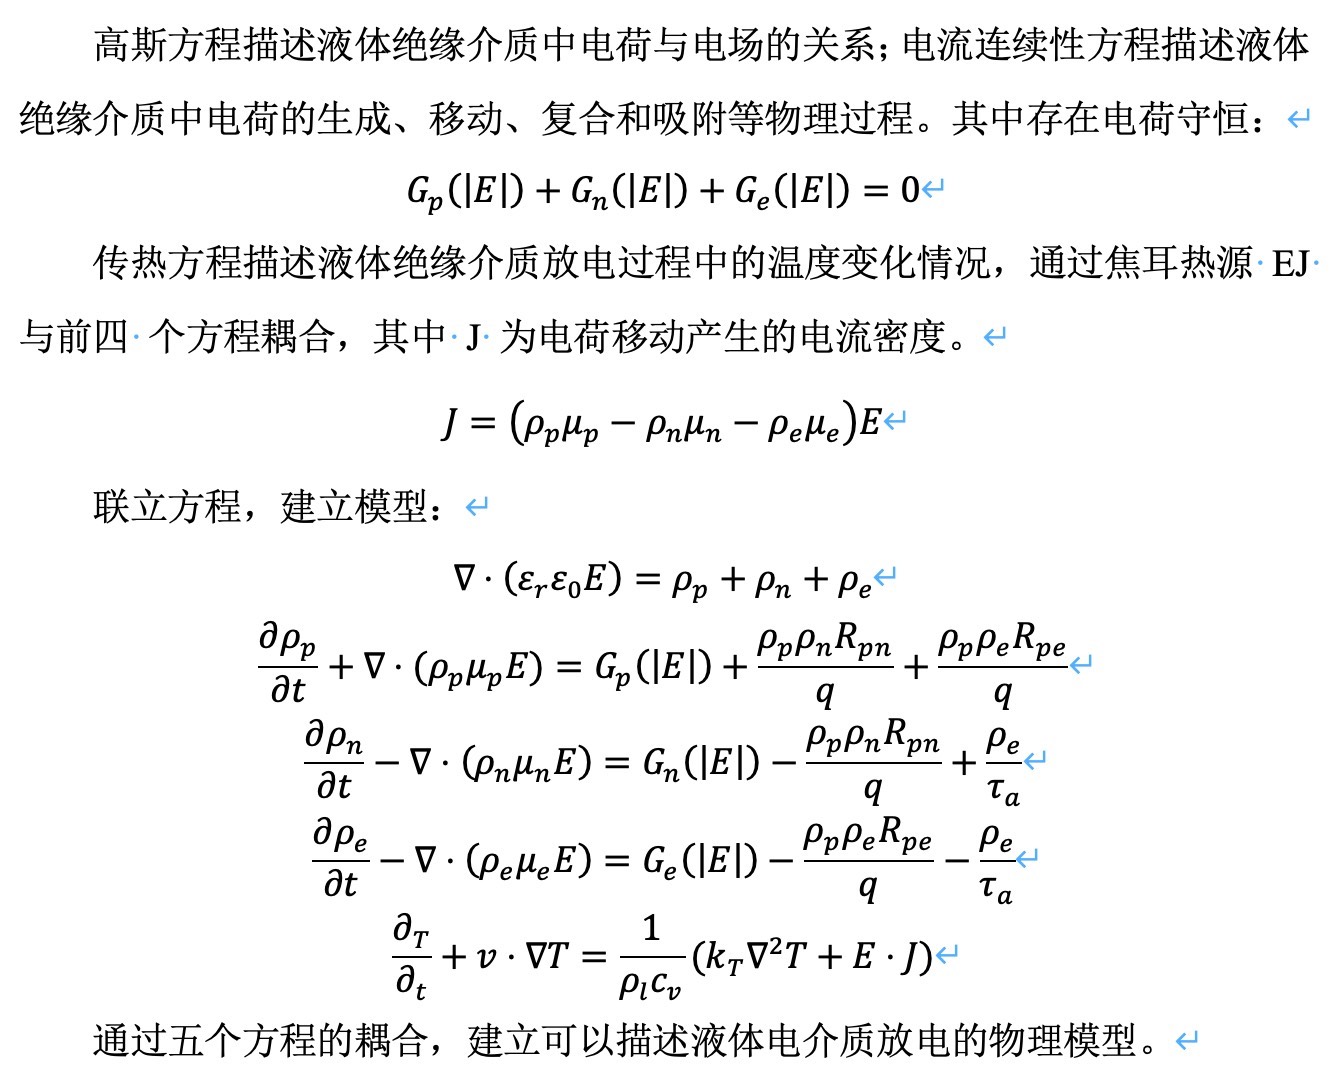
comsol变压器绝缘油中流注放电仿真,使用PDE模块建立MIT飘逸扩散模型。模型到手即用,提供MIT鼻祖论文中文版,及相关学习笔记资料。流注放电,绝缘油,油纸绝缘。在变压器的运行过程中,绝缘油和油纸绝缘的性能至关重要,而流注放电现象可能会对其绝缘性能造成严重威胁。今天咱们就来聊聊用 Comsol 进行变压器绝缘油中流注放电仿真,这里用到的是 PDE 模块建立的 MIT 飘逸扩散模型。
本DEMO是一款基于C#语言开发的轻量级高并发物联网服务器接收程序,专注于硬件数据接收与管理,不包含Web端功能。系统采用.NET Framework 4.6框架构建,整合了SQLite数据库存储、高并发TCP通信、设备管理、数据监控等核心能力,适用于物联网场景下多设备数据采集与控制需求,可稳定接收硬件设备上传的多通道数据并提供实时监控与历史数据查询功能。
5G与AI协同推动工业互联网智能化转型。5G提供高速、低延迟的网络支撑,实现智能制造、远程操作和自动化生产;AI则赋能智能决策、预测维护和质量控制。两者结合促进实时数据处理、边缘计算协同,驱动自动化生产、智慧供应链和远程管理。未来,技术持续创新与产业链协同发展将推动制造业向更智能高效的方向演进。
本文介绍了基于Docker的多节点大数据环境配置方案,重点讲解了Hadoop生态组件(HDFS、YARN、HBase)、Spark、Kafka、Flink等服务的容器化部署方法。
使用独立metasto嵌方式访问元数据,需安装mysql和配置mysql,不需要启动 HiveServer2 服务和配置 HiveServer2,需要配置和启动独立的 Metastore 服务。-- ==================== 【核心】远程元存储(Remote Metastore)配置 ==================== -->-- ==================== M
(2)下载地址:http://archive.apache.org/dist/flume/Flume是Cloudera提供的一个高可用的,高可靠的,分布式的海量日志采集、聚合和传输的系统。Flume基于流式架构,灵活简单。Flume最主要的作用就是,实时读取服务器本地磁盘的数据,将数据写入到HDFS。
本系统基于Hadoop设计开发一个疫情分析系统,该系统的主要功能分为疫情数据采集与存储、疫情数据分析、疫情数据可视化。通过收集和爬虫方式获取疫情数据并通过Flume传输;将分析结果和数据通过Sqoop传输至MySQL,采用SpringBoot进行后端搭建并通过ECharts图形库在前端用Vue框架实现数据可视化,将疫情信息图表化显示。将分析数据通过sqoop传输到MySQL,通过spring bo
1单选(2分)第三次信息化浪潮的标志是:A.个人电脑的普及B.互联网的普及C.虚拟现实技术的普及D.云计算、大数据、物联网技术的普及正确答案:D你选对了提问2单选(2分)就数据的量级而言,1PB数据是多少TB?A.2048B.1024C.512D.1000正确答案:B你选对了提问3单选(2分)以下关于云计算、大数据和物联网之间的关系,论述错误的是:A.云计算侧重于数据分析B.云计算、大数据和
1、Hadoop Distributed File System (HDFS):HDFS是Hadoop的分布式文件系统,它将数据存储在多个服务器上,实现了数据冗余和高可用性。它可以确保数据的一致性和可靠性,并提供了一些常见的同步原语,例如锁和信号量。强烈推荐《Hadoop大数据实战权威指南(第2版)》,是一本非常好的Hadoop学习教程,内容充实详细,很有实战意义,非常适合开发人员学习,希望对大家
工作的过程中我们会遇见数据分类的情况,想要根据自己的需求定义分区的规则,让符合规则的数据发送到不同的分区中,这个时候我们就需要自定义分区器了。定义分区器,让数据发送到不同的分区,从而不同的task任务输出的文件结果内容也不同# 自己创建数据data/a.txt# 需求就是将数据按照规则进行分发到不同的分区中# 存储的时候一个文件存储hello其他的文件存储tom jack分区器的定义需要实现分区器
flume
——flume
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区




 天工造物局






 DAMO开发者矩阵