登录社区云,与社区用户共同成长
邀请您加入社区
创建新虚拟环境 mydata(mydata自己起的名字)后面版本对应自己的python版本号。选择想要的版本下载到本地再拖到虚拟机上面。然后到该下载目录下直接运行。一路enter ,<<< 遇到选择的就选择yes。第一步:下载linux版本的anaconda。退出环境返回默认环境。
新手配置yum源可能出现的问题,重新配置官网yum源,安装gcc环境
在传统焦化生产中,配煤工作高度依赖配煤师的经验,效率低且易出现焦炭指标偏差,导致炼焦煤成本常居高不下。此外,该智能焦化方案还提供完善的数字化流程管控,包含实时数据中心的数据看板、智能配煤、智能煤仓、库存管理、客户管理等模块,分别从原料煤质量数据库、原料煤供应商数据库、最优配煤方案生成、配比方案比较、焦炭质量预测、化产负荷预测、焦炭数据库、煤焦评价体系、排班排产计划、原料煤采购计划、客户反馈管理等功
使用redis - zset实现排行榜引出实现过程一、接收uri时统计系统和用户1. 主要方法2. 备注3. 代码说明二、 从reids上获取排行榜信息1.主要方法2.备注3.代码说明四、从redis上获取监控图表数据1.主要方法2.备注3.代码说明五、前端使用排行数据,显示成图表2.代码说明引出最近做一个请求uri排行榜的功能,效果如图,统计发出uri最多的十个应用及每个应用下发出uri最多的3
ElasticSeach详细安装教程--图文介绍超详细。Elasticsearch 是一个分布式、RESTful 风格的搜索和数据分析引擎,能够解决不断涌现出的各种用例。 作为 Elastic Stack 的核心,它集中存储您的数据,帮助您发现意料之中以及意料之外的情况。Elasticsearch 是一个基于JSON的分布式搜索和分析引擎。
积少成多,再坚持一会
1、操作数据库头文件#include <QWidget>#include <QSqlDatabase>#include <QSqlQuery>#include <QDebug>public:explicit Widget(QWidget *parent = 0);~Widget();QSqlDatabase db;void conDB();void
我这里采用了jdk1.8.0_301+hadoop-3.3.1+zookeeper-3.6.3+hbase-2.4.6的版本不同版本可能不能兼容,兼容性问题可以去官网查看http://hbase.apache.org/book.html#_preface我这里有三台虚拟机,hadoop102,hadoop103,hadoop1041、zookeeper正常部署首先保证三台机器的zookeeper正
load data infile 'C:/Users/86183/Desktop/weather.csv' into table `tb_1`character set gb2312#注意查看记事本中的脚本是否为gb2312fields terminated by ','optionally ebclosed by '"'escaped by '"'lines terminated by '\r\
1、解压:sudo tar xvzf sqlite-autoconf-3071601.tar.gz -C /opt2、进入解压后的目录:$ cd sqlite-autoconf-30716013、执行:./configure CC=aarch64-linux-gnu-gcc --host=arm-linux --prefix=/opt/sqlite-autoconf-3071601/temp/说明
1.centos7数据库不能用navicat打开,后来发现是openssl版本问题,网上搜索如下设置可以解决:https://mp.csdn.net/mp_blog/creation/editor/1200805402.操作完之后navicat可以练数据库了但是editplus又拒绝访问,经过资料查找,在服务器/var/log查看登陆日志 secure找到失败原因:根据提示只要在刚刚的sshd_c
Redis数据库1、Redis数据库介绍Redis 是完全开源免费的,遵守BSD协议,是一个高性能的key-value数据库。主要用作缓存使用。服务器一旦关闭保存在里面的数据如果没有进行手动的持久化保存,将会自动清除。Redis 与其他 key - value 缓存产品有以下三个特点:Redis支持数据的持久化,可以将内存中的数据保存在磁盘中,重启的时候可以再次加载进行使用。Redis不仅仅支持简
永洪BI的超链接功能允许用户在报告、图表、文本等组件上设置超链接,从而实现数据的快速跳转和深入分析。这种功能不仅增强了报告的交互性,也为用户提供了更加灵活的数据探索方式。
头歌Flume进阶代码答案
第1关:QueueStreamimport java.text.SimpleDateFormatimport java.util.Dateimport org.apache.spark.{HashPartitioner, SparkConf}import org.apache.spark.rdd.RDDimport org.apache.spark.streaming.{Seconds, Stre
问题:Exception in thread “Thread-6” java.lang.IllegalStateException: Trying to access closed classloader. Please check if you store classloaders directly or indirectly in static fields. If the stacktrac
电商人货场指标体系
在搭建hive时,进行最后一步初始化出现了下面的错误Initialization script hive-schema-2.3.0.mysql.sqlError: Syntax error: Encountered "<EOF>" at line 1, column 64. (state=42X01,code=30000)org.apache.hadoop.hive.metastore
先注册个账号:麒麟生态
不管是要学习深度学习课程还是研究深度学习项目,数据集都是必不可少的,但网上的数据集大多都无法直接下载,这里为大家总结了各种数据集,而且都是已经标注好的,直接百度网盘下载。
介绍:Hadoop是一个开源软件框架,用于在商用硬件集群上存储数据和运行应用程序。它为任何类型的数据提供海量存储,巨大的处理能力以及处理几乎无限的并发任务或作业的能力。第一步:前期需要准备的材料:① Hadoop-3.0.0下载从http://archive.apache.org/dist/hadoop/core/下载Hadoop-3.0.0,下载二进制压缩包文件:hadoop-3.0.0.tar
当信息的传递被人类这种智慧生物赋予了哲学意义上的概念以后,对于未来人类发展的一些思考。《人论》恩斯特·卡希尔不是学西方哲学的人估计没有人知道,在他晚年的时候,他写了一本总结性的书籍《人论》。这本书给处于中二期的我提供了一个全新的思考角度。我在玩到《死亡搁浅》的时候,突然想起了这本书里的一些观点。所以这篇文章从这里出发,深入到冥滩之上,来俯瞰整个生命历程。在恩斯特·卡希尔论述中,无数的生物学家、人类
使用Navicat链接MYSQL数据库错误解决办法错误:1在用Navicat连接Mysql时,出现 1045-Access denied for user ‘root’@’localhost’(using password:YES)错误原因:出现这个问题的原因之一是权限的问题,也就是说你的电脑可能没有权限访问mysql数据库。因为我们在安装mysql之后,root其实是有最高权限的,而且很少会有人
mysql连接不上本地数据库,显示ERROR 2003 (HY000): Can‘t connect to MySQL server on ‘localhost‘ (10061)
当我们要跨本地数据库,访问另外一个数据库表中的数据时,本地数据库中就必须要创建远程数据库的DBLINK,通过DBLINK本地数据库可以像访问本地数据库一样访问远程数据库表中的数据。一、 创建DBLINK(我们这里已图文的形式展现简单点)1、登录要链接的数据库2、点击 服务对象-》链接服务器然后左击3、点击现键链接服务器4、根据需求设置被链接服务器地址(一般情况下是IP地址)、选择SQL SERVE
最近有一个项目需要将一个word文档中的数据提取到数据库中。就去网上查了好多资料,网上很多都是提取简历那种带表格的,但是我这个项目需要提取带目录的。找了好久,最终实现了(我的这篇博客主要是借鉴https://blog.csdn.net/qq_16601953/article/details/82415518)。目录截图下面贴上主要代码我是按照上面博客借鉴的稍微根据我的需求改了改/*** word文
项目场景:由于我们的测试环境的数据库默认连接数是200,而我正好做了一个导出的需求,导出的整个流程是:首先从好多数据表中拿到数据在内存中进行组装,组装好了之后上传到导出服务器,然后返回给用户下载链接。问题描述:由于导出服务本身就开了10个协程, 在取数据时取三个表的数据又单独开了协程,取每张表大约开了10个协程,总共开了10X10X10个协程去数据库表取数据,然后在测试环境可能同时有很多导出任务在
基本的使用方法总结:1 导出所有库系统命令行mysqldump -uusername -ppassword --all-databases > all.sql2 导入所有库mysql命令行mysql>source all.sql;3 导出某些库系统命令行mysqldump -uusername -ppassword --databas
Issue:When you compile your java class, you may got following error. The code of method is exceeding the 65535 bytes limit Reason:According Java specification, one Java method size must be l
用户画像离线标签数据存储在es内,实时画像标签数据存储在redis内,离线用于圈选,实时用于点查。随着业务的增长,目前需要离线标签数据和实时标签数据同时进行圈选用户,上述架构无法满足,故需要一个离线数据和实时数据共存在一张表中提供圈选和点查的能力。通过调研压测不同的产品,最后选择了doris2.1版本升级画像的架构。
数据可视化Tableau课程内容
当下,“数字化、智能化”已经不再是新鲜词汇。事实上,早在几年前,就有企业开始大力推动数字化转型,并持续进行了一段时间。一些业内人士甚至认为,“如今的企业数字化已经走过了成熟期,进入了深水区。随着工业4.0时代的到来,越来越多的企业开始尝试利用数据和算法来指导自身的研发和生产实践。然而,根据发布的《智能制造成熟度指数报告(2022)》数据显示,在接受调查的6万家国内企业中,仅有4%的企业达到了深度数
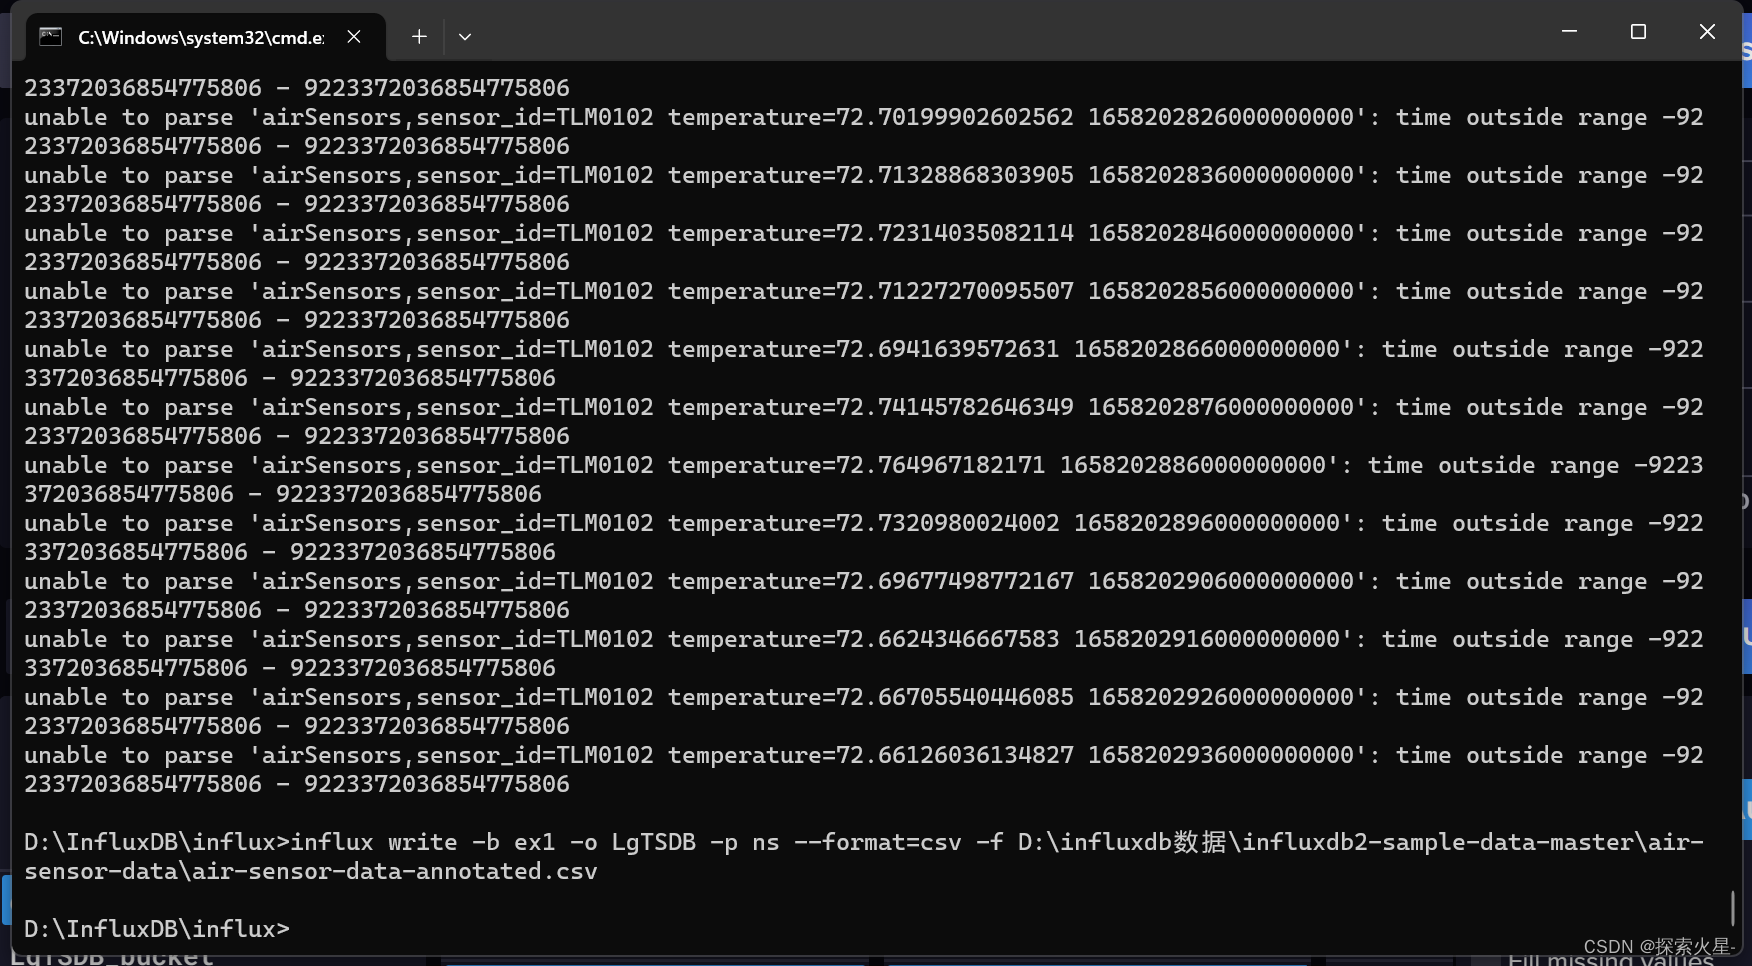
选择好你写入的桶进行界面展示submit即可,可选择时间段(图中选择了2022-7-19 11:00-xxxxxxxx),也可以csv下载数据。错误401:未进行身份认证,INFLUX_TOKEN,如何认证在之前说明过,在此不再介绍。打开cmd命令,输入语句set INFLUX_TOKEN=xxxxxxxxxxxx。p代表精度,在这里是ns级别,根据你的文件进行不一样的修改,比如s代表秒级。之后利
先来解释一下什么是全源码交付。全源码交付是指低代码开发平台在生成应用程序后,将其全部源代码毫无保留地完整提供给开发者。这种方式相较于传统软件开发中的编译后交付方式,具有更高的灵活性和可定制性。通过全源码交付,开发者可以自由地对应用程序进行修改、定制和扩展,从而更好地满足企业与用户之间复杂多样的业务需求。这种交付方式赋予了开发者更大的自主权和掌控力,同时也为应用程序的长期发展和维护提供了坚实的基础。
这里我们在另外一台机器上部署clickhouse-client, 因为我们的clickhouse-server一般是部署在服务器端的,我们的clickhouse-client 是部署在客户端的,所以我们先拉去镜像。这里我们创建一个新的用户root ,所以我们需要创建一个 标签,添加到 下,和 同级。保存退出, 接下来重启容器,
首先下载包,有源码和预编译两种包 。我这用的预编译下载 | Apache Doris我的架构是3FE+7BE首先操作系统安装要求#设置系统最大打开文件句柄数时钟同步Doris 的元数据要求时间精度要小于5000ms,所以所有集群所有机器要进行时钟同步,避免因为时钟问题引发的元数据不一致导致服务出现异常。#关闭交换分区(swap)Linux交换分区会给Doris带来很严重的性能问题,需要在安装之前禁
错误信息:warning: here-document at line 58 delimited by end-of-file (wanted `EOF')业务场景,使用hive对数据进行批量清洗,hive语句放到shell脚本中方便执行。#定义hqlsql=$(cat <<!EOFhive的hql语句块!EOF)#执行hql$HIVE_HOME/bin/hive...
匿名用户user=anonymous执行SQL语句时,报错!再执行SQL语句,就可以了。如果还不行,基本就是权限的问题了。像这样:那我们只能使用hdfs用户操作了。
默认Spark操作Hudi使用表类型为Copy On Write模式。Hudi与Spark整合时有很多参数配置,可以参照https://hudi.apache.org/docs/configurations.html配置项来查询,此外,整合时有几个需要注意的点,如下:2、编写向Hudi插入数据代码向Hudi中存储数据时,如果没有指定分区列,那么默认只有一个default分区,我们可以保存数据时指定
用户连续登录天数hive统计
和数集团在相关互联网司法方面采用区块链技术有过大量研究,同时还通过探索“区块链+”在商品溯源、供应链金融、版权保护、信任证明、合同存证、金融风控等领域的应用,加快区块链和人工智能、大数据、物联网等前沿信息技术的深度融合,推动集成创新和融合应用。...
CirroData-TimeS时序数据库可以应用于多种场景,通用的时序数据库提供的内置函数一般具有业务通用性,对于具有业务特性的处理逻辑,CirroData-TimeS能够提供更灵活的处理框架能将处理逻辑下推,获得更好的性能。
生产线数字孪生是通过对生产过程的数字化重建,在虚拟的空间当中实时的呈现出生产的过程。利用数字孪生系统来实现转运过程监控,转运统计以及其他储存的功能板块,还可以通过历史数据提供报表。
script字段值过滤查询indexName索引中,name==‘测试’ && fieldName字段值的长度>2的文档GET /indexName/_search{"query": {"bool": {"must": [{"match_phrase": {"name": "测试"}},{"script":
原因:hbase 默认注释掉 HBASE_PID_DIR,而 hbase 默认把 pid 文件放在 /tmp 下, 这个目录可能会被系统删除等原因无法找到解决方法:把 hbase/conf/hbase-env.sh 中的 HBASE_PID_DIR 属性打开修改为非临时路径,例如 opt/module/hbase/pids, 然后重启 zookeeper 和 Hbase 即可...
可变数据的处理一直以来都是大数据系统,尤其是实时系统的一大难点。在调研多种方案后,我们选择了 CDC to Hudi 的数据摄入方案,目前在生产环境可实现分钟级的数据实时性,希望本文所述对大家的生产实践有所启发。1. 背景Linkflow 作为客户数据平台(CDP),为企业提供从客户数据采集、分析到执行的运营闭环。每天都会通过一方数据采集端点(SDK)和三方数据源,如微信,微博等,收集大量的数据。
Delta Lake 是 DataBricks 公司开源的、用于构建湖仓架构的存储框架。能够支持 Spark,Flink,Hive,PrestoDB,Trino 等查询/计算引擎。作为一个开放格式的存储层,它在提供了批流一体的同时,为湖仓架构提供可靠的,安全的,高性能的保证。
数字孪生智慧交通建设,可视化三维全景建模模型场景概念优势。数字孪生智慧交通面对较高的汽车保有率以及复杂多样的驾驶场景变化,如何提高车辆的自适应能力,从而保障日常行驶的稳定性,一直以来是智慧交通的痛点。而通过数字孪生技术,将会从多个方面赋能智能交通,以满足未来出行的需求。
如今,各行各业对数据分析的关注度也越来越高,很多企业已经意识到通过数据分析而获得的知识和信息对企业的日常经营活动具有积极的促进作用。
准备工作hadoop版本:3.0.0-cdh6.3.2hive版本:hive-2.1.1linux环境:centos7.6jdk1.8maven-3.6以上protobuf-2.5.0.tar.gz(只能是这个版本,用外网下载Releases · protocolbuffers/protobuf · GitHubtez-0.9.2源码Apache Downloads...
big data
——big data
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区