


- @youyouxiong


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这些引脚的具体功能可能会根据实际的电路设计和应用需求有所不同。在设计电路时,应参考STM32F103C8T6的官方数据手册,以确保正确使用各个引脚。STM32F103C8T6是一款中等密度性能的微控制器,具有多种功能的引脚。:如PB2(BOOT1),与BOOT0引脚配合,用于配置系统启动模式。:用于连接模拟信号,通常用于ADC转换。:如PC13,通常用作用户LED。:用于CAN通信协议的总线引脚。
4. **文件操作**:涉及文件的读写操作,如使用`fopen`、`fclose`、`fread`、`fwrite`等函数进行文件处理。3. **算法和逻辑**:包括排序算法、查找算法、递归、贪心算法、动态规划等,要求参赛者能够用C语言实现这些算法解决具体问题。2. **数据结构**:考察对数组、字符串、结构体、指针、动态内存分配等C语言内置数据结构的理解和使用。5. **阅读资料**:阅读相关的
模块,这是Python标准库的一部分,专门用于编写和运行测试。下面是一个简单的测试用例的例子,展示了如何使用。这只是一个简单的例子,实际的测试用例可能包含更多的测试方法和复杂的测试逻辑。模块,你可以构建强大的测试套件来确保你的代码按预期工作。在Python中编写测试用例通常使用。在这个例子中,我们定义了一个测试类。模块来测试一个函数。
在上述代码中,我们首先将时间序列数据转换为LSTM模型可以接受的格式,即创建了一系列的窗口数据。接下来,我们创建了一个简单的LSTM模型,其中包含一个LSTM层和一个全连接层。在实际应用中,可能需要调整LSTM层的神经元数量、增加更多的层、调整学习率和其他超参数,以及进行更复杂的数据预处理和特征工程来提高模型的性能。此外,根据问题的具体情况,可能需要使用更复杂的时间序列分割方法,例如使用滚动窗口或
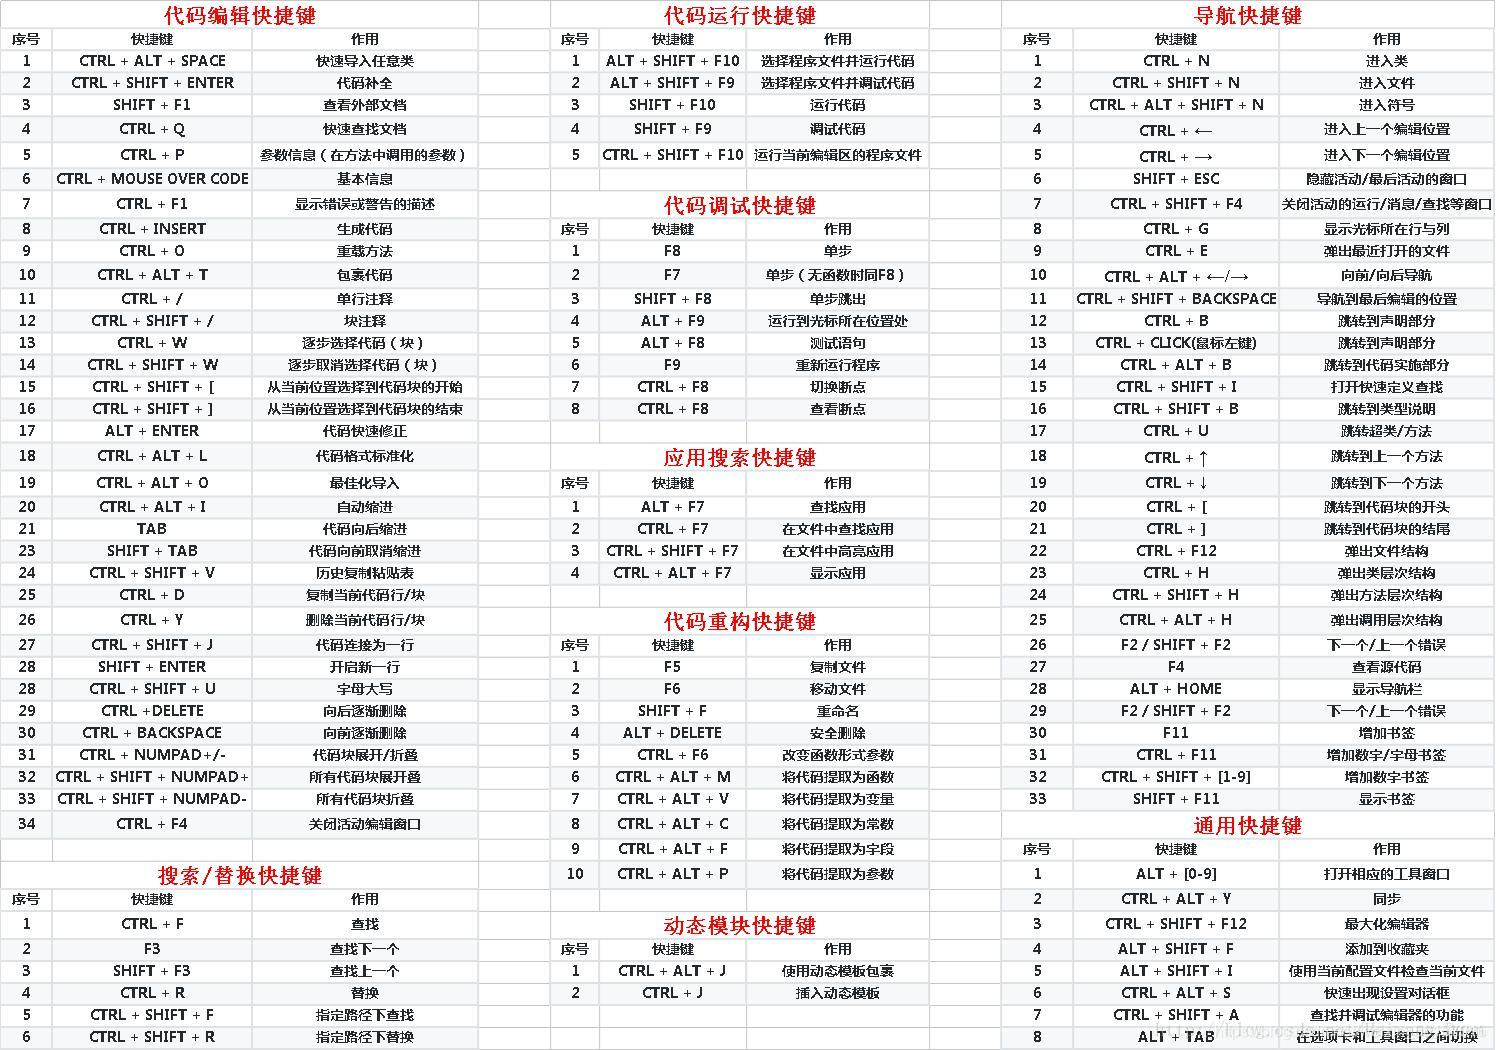
建议收藏!PyCharm快捷键大全
MapReduce是一个编程模型和处理大数据集的框架,它由Google开发并广泛使用于分布式计算环境中。MapReduce模型包含两个主要的函数:Map和Reduce。Map函数用于处理输入的键值对生成中间键值对,Reduce函数则用于合并Map函数输出的具有相同键的中间值。在招聘数据清洗的案例中,MapReduce可以被用来处理和清洗大量的简历数据,以便于后续的数据分析和处理。
请注意,这些步骤是非常基础的,实际的数据聚合可能需要更复杂的操作,比如使用多个聚合函数、处理更复杂的数据结构等。如果您有具体的数据和需求,可以提供更多的信息,我可以给出更具体的指导。在Python中进行数据聚合通常涉及到使用Pandas库,它是一个功能强大的数据分析工具。在聚合之前,通常需要清洗数据,比如处理缺失值、去除重复项等。假设您有两个CSV文件,我们可以使用。聚合后的数据可以导出到CSV文
通过以上步骤,您可以快速掌握GitHub的基本使用方法,并逐步深入学习更多高级功能。在本地仓库中,输入git remote add origin [仓库URL],将远程仓库添加为默认分支。官方教程: GitHub官方提供了10分钟入门教程,内容包括新建仓库、新建分支、修改提交以及请求拉取等。输入git push -u origin master(或其他分支名)将本地仓库推送到远程仓库。将您的分支合
您提到的“头歌python共享单车6.4”似乎是一个特定上下文中的术语或者是某个项目、课程、教程的名称。如果您能提供更多的上下文或者详细描述,我可以为您提供更准确的帮助。:构建机器学习模型来预测共享单车的需求量,使用Python的机器学习库(如scikit-learn、TensorFlow等)。:利用Python的可视化库(如Matplotlib、Seaborn、Plotly等)对共享单车的使用情
使用Hadoop进行数据分析是一个复杂的过程,需要对Hadoop的各个组件和生态系统工具有深入的了解。如果你有具体的数据分析任务或者需要帮助编写MapReduce程序,可以提供更多的信息,我可以提供更具体的帮助。Hadoop是一个开源框架,它允许分布式处理大数据集群上的大量数据。Hadoop由两个主要部分组成:HDFS(Hadoop分布式文件系统)和MapReduce。
