登录社区云,与社区用户共同成长
邀请您加入社区
开源鸿蒙PC社区推出适配Apache Hive的原生客户端,基于Qt 5.15.12构建桌面应用,支持arm64-v8a架构,实现鸿蒙端与传统Hive集群的无缝对接。采用“鸿蒙客户端 + 服务端Gateway + 原有集群”三层架构,不迁移服务端组件,保障安全边界。通过HTTP/JSON协议桥接Hive JDBC,支持连接管理、HiveQL执行、元数据浏览、查询监控等核心功能,已在华为MateBo
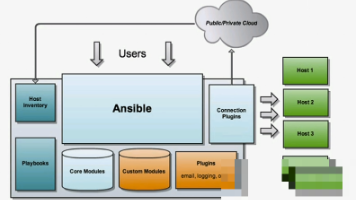
Ansible是一款自动化运维工具,基于Python开发,集合了众多运维工具(puppet、cfengine、chef、func、fabric)的优点,实现了批量系统配置、批量程序部署、批量运行命令等功能。Ansible是基于模块工作的,本身没有批量部署的能力。真正具有批量部署的是Ansible所运行的模块,Ansible只是提供一种框架。主要包括:(1) 连接插件connection plugi
id INT,PARTITIONED BY (dt STRING COMMENT '数据日期,格式yyyyMMdd');版本支持:普通分区表全版本,范围分区表仅4.0+列属性:普通分区表为独立虚拟列,范围分区表可复用普通列形成双属性列分区逻辑:普通分区表为离散值划分,范围分区表为连续范围划分管理方式:普通分区表手动创建/指定,范围分区表规则预定义+自动匹配查询适配:普通分区表适配等值查询,范围分区
Hive中的。
计算机毕业设计PySpark+Hadoop+Hive+LSTM模型美团大众点评分析+评分预测 美食推荐系统(源码+论文+PPT+讲解视频)
hive下载,一篇搞定!
这个Hive报错表明系统在表中找不到名为的分区。
举例json_extract_scalar(json extract_scalar(nessage,'$.extInfo').'$platformtimit'--举例如:get_json_object(get_json_object(message,'$.extInfo').'$.platformLimit')--举例:get_json_object(data_json,'$.customer[1
针对电影资源爆炸式增长带来的选择难题,本文设计了一套基于Hive的智能推荐系统。该系统整合Hive数据仓库、Hadoop大数据存储、Spark实时处理及SpringBoot+Vue前后端技术,构建包含数据抓取、处理、分析和可视化四大模块的完整解决方案。通过爬取豆瓣数据并深度挖掘多维度信息,系统实现了高效电影数据管理与个性化推荐,Echarts可视化界面直观呈现分析结果。研究表明,该架构有效优化了电
hive优化
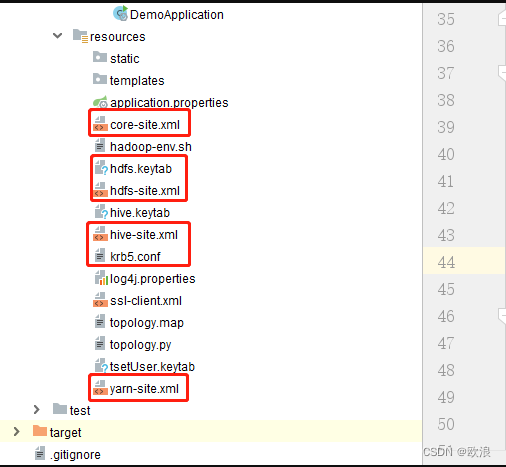
第一种情况: 在/export/servers/apache-hive-2.3.7-bin/conf/ hive-site.xml文件中注意useSSL大小写问题。第二种情况:export/servers/hadoop/etc/hadoop/下的core-site.xml 和hdfs.site.xml文件中需要修改。Ps:hdfs.site.xml文件中其他地方出现ns1也要修改为master。(
2、now() 或 current_timestamp() 当前时间3、datediff(endDate, startDate) 计算日期相差天数4、months_between(endDate, startDate) 日期相差月数5、date_add(startDate, numDays) 日期加N天6、date_sub(startDate, numDays) 日期减N天7、add_months
在hue执行"truncate table db_name.table_name"时报错,报错内容为"Error while compiling statement: FAILED: SemanticException [Error 10146]: Cannot truncate non-managed table db_name.table_name"外部表:hive只管理元数据,hdfs管理实
hive中的数据粒度级别大致分三类:table、partition、bucket。
MySQL 公钥检索错误,MySQL 8.0 默认启用了公钥检索(public key retrieval)功能,而有时需要在 JDBC 连接 URL 中明确指定允许公钥检索。: 在你的 JDBC 连接 URL 中,添加。
尽量使用上述的SQL语句调节进行优化。
hive 日期函数 date_add
特性HiveImpala基础架构基于 MapReduce 或 Tez 架构并行 SQL 查询引擎查询性能适合大规模批量处理专注于交互式查询和实时数据分析延迟较高低延迟应用场景大规模数据仓库处理、离线数据分析实时数据分析、交互式查询综上所述,Hive 更适合大规模数据仓库处理和离线数据分析,而 Impala 则更适合实时数据分析和需要低延迟的交互式查询。选择使用哪种工具应该根据实际需求和场景进行权衡
代码:(敲一遍,你会懂的)
用kettle把mysql中的数据导入到hive并处理相关报错
4,最后排查,这个节点rpm部署了hive,现在只是copy了一个hive的目录过来,导致/usr/bin/hive 这个里面和现在部署的安装包不是同一个。3,把hive-site.xml中无关的配置都删掉,重启metastore还是报错。1,启动hivemetastore后报错日志。2,排查lib下的mysql的驱动也在,这里和mysql的驱动大小一样。
通过对这些数据进行深入挖掘和分析,能够发现用户行为和酒店属性之间的潜在关联,从而为用户推荐最符合其需求的酒店。本文提出了一种基于Hive的酒店推荐系统,旨在通过大数据分析和处理技术,为用户提供精准、高效的酒店推荐服务。该系统不仅为用户提供了个性化的酒店推荐服务,还为酒店业者提供了有价值的用户行为分析数据,有助于提升酒店服务质量和市场竞争力。系统的总体架构分为8层,分别为源数据层、数据获取层、数据存
数据仓库项目报告学生成绩制作报表
将test 表的 S1 列的读权限授权给role_name (TABLE也可以不写)#回收role_name对数据库db_name的SELECT 权限。#将role_name 权限给予user_group用户组。#回收role_name对表test的SELECT 权限。#查看role_name 在数据库db_name中权限。#将role_name 权限给予user_name用户。#查看role_n
公共表表达式(Common Table Expressions,CTE)可以表示一个临时的结果集(表),该表通过一个简单的查询指定,只要在CTE 语句范围内均可共享该临时表。Hive SELECT 语句用于对表进行查询,即按照规定的语法规则从表中选取数据,并将查询结果保存在结果表中。Hive SELECT 语句支持使用正则表达式指定列名称,凡是符合正则表达式规则的列名将被作为结果集中的一列。> 子
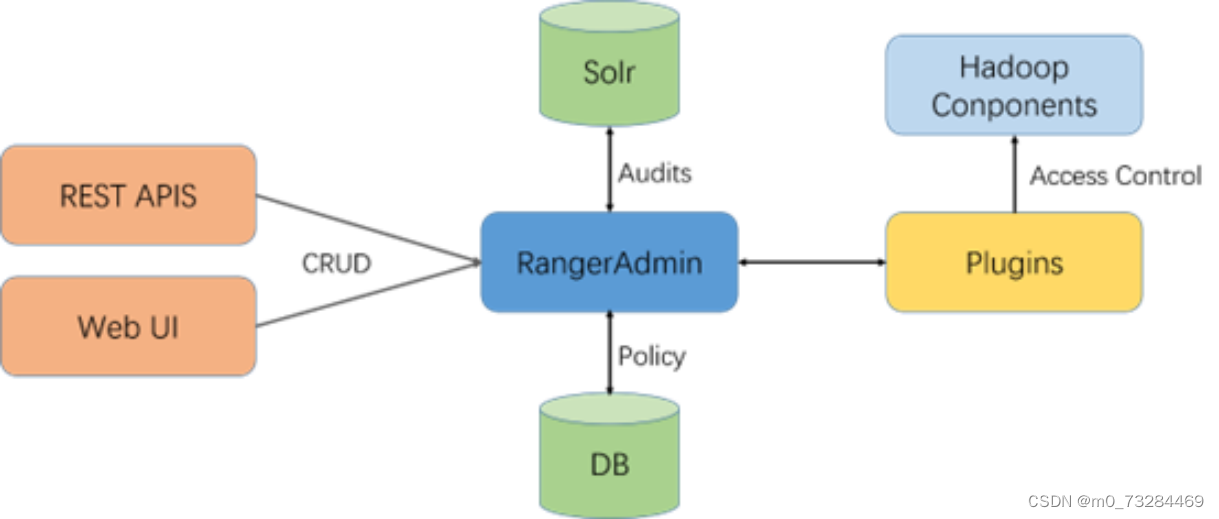
Apache Ranger是一个用来在Hadoop平台上进行监控,启用服务,以及全方位数据安全访问管理的安全框架。Ranger的愿景是在Apache Hadoop生态系统中提供全面的安全管理。随着企业业务的拓展,企业可能在多用户环境中运行多个工作任务,这就要求Hadoop内的数据安全性需要扩展为同时支持多种不同的需求进行数据访问,同时还需要提供一个可以对安全策略进行集中管理,配置和监控用户访问的框
使用beeline连接hive的前提是hive已经部署完毕,Hive单机部署可以看:http://t.csdnimg.cn/54WMQ。
其中囊括了JVM、锁、并发、Java反射、Spring原理、微服务、Zookeeper、数据库、数据结构等大量知识点。
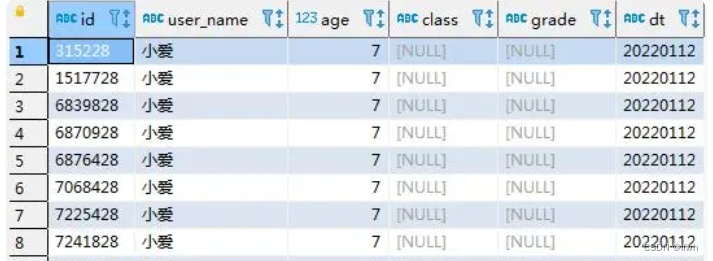
解决hive表新增的字段查询为空null问题
注意:将里面的路径改成自己的,还有在<数据库连接地址配置>中先查看自己数据库的端口号是多少,在<数据库访问密码>中设置自己的密码。添加/tmp和/user/hive/warehouse 并且修改权限。且可发现在Navicat premium的hive数据库中出现了内容。2.path中增加:%HIVE_HOME%\bin。1.hive环境变量配置:(不可以有空格)hive的版本需与hadoop版本相
在kerberos 服务端执行如下命令,创建Hive服务的kerberos Princial主体,然后将服务主体写入keytab文件。#在kerberos 服务端node1节点执行如下命令#将hive服务主体写入keytab文件以上命令执行后,可以在node1节点的/home/keytabs目录下看到生成对应的hive.server.keytab文件。
mapred.invalidinputException:input path does not exists hdfs://表路径/表名/表分区。hive表 insert数据时,报错vertex failed ,vertex name =Map 1...查询不到当前分区 ,说明hive分区表元数据和hdfs文件目录不一致(也可能是分区删除),导致的读异常。这个方式可以解决问题,之后再重新inse
Hive中的explode函数用于将数组类型的列展开成多行数据,每行包含数组中的一个元素。在Hive中,collect_set函数用于将某一列中的元素收集到一个集合中,并去除重复的元素。在Hive中,collect_list函数用于将某一列中的元素收集到一个列表中,保留元素的顺序。通过使用explode函数,我们可以将数组类型的列展开成单独的行,以便更方便地进行进一步的分析、聚合或筛选操作。该函数
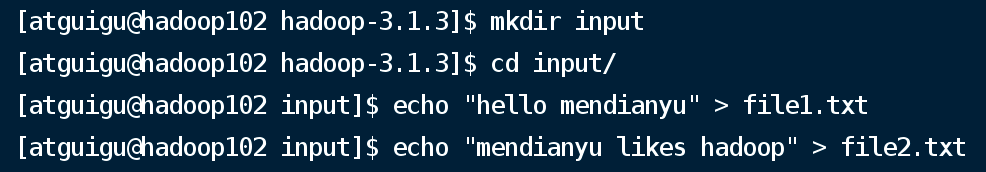
1.首先在hadoop目录下创建一个input文件夹,并在文件夹里建立两个txt文件并写入信息第三行的echo命令会讲引号里的内容写入后边的文件,文件不存在的话会自动创建一个.2.启动hive,创建一个名为docs的表,只含一列,列名为line,类型为string3.将第一步input文件夹中的内容导入表docs引号中的地址为file://加上input文件在所在的地址4....
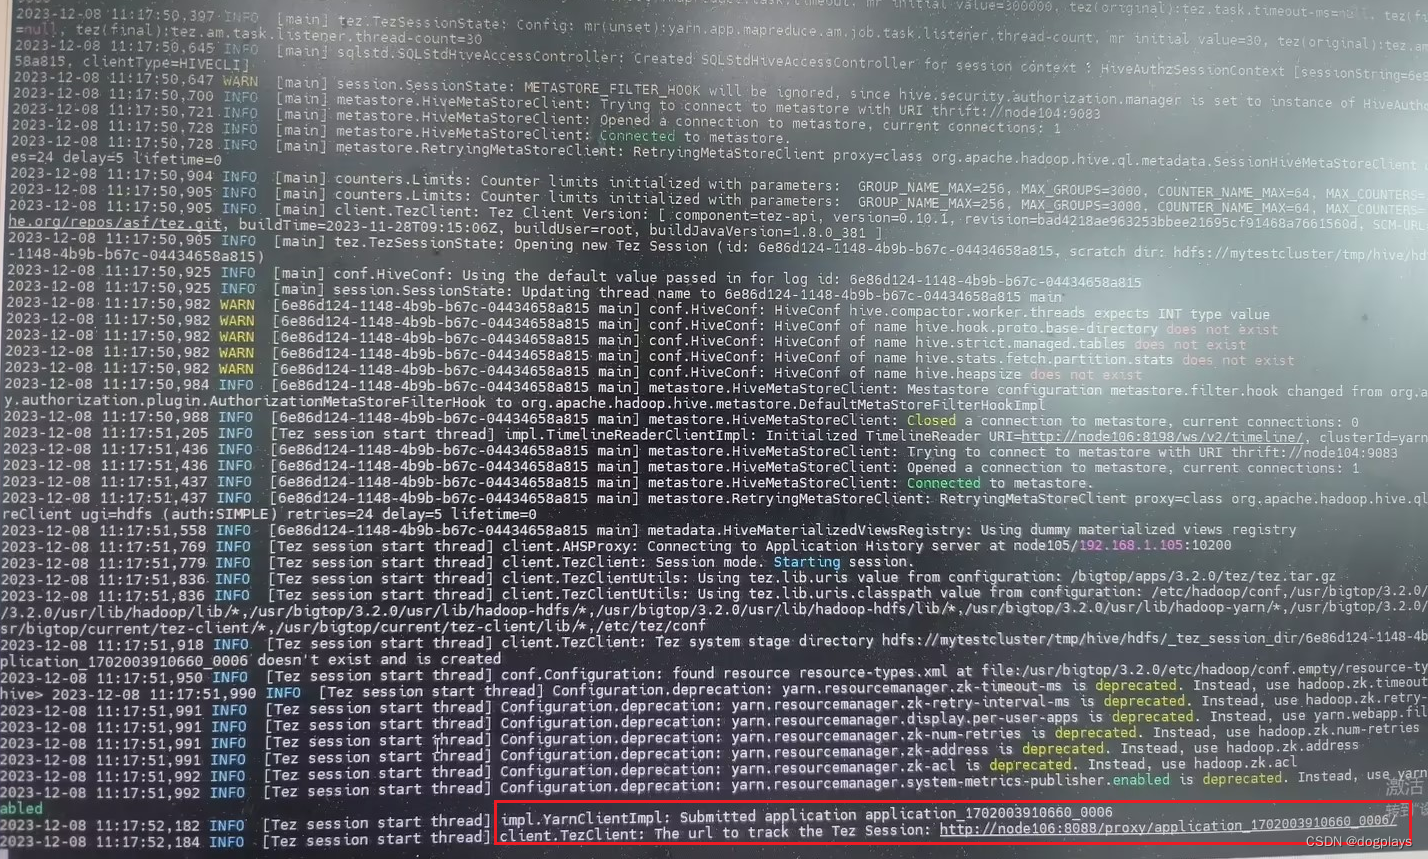
使用TEZ作为Hive默认执行引擎时,需要在调用Hive CLI的时候启动YARN应用,预分配资源,这需要花一些时间,而使用MapReduce作为执行引擎时是在执行语句的时候才会去启用YARN应用。所以说,hive on tez使用./bin/hive后一直卡住是假象,待预分配资源任务结束后,即可输入hive sql正常执行。hive on tez使用./bin/hive启动后一直卡住,无法进入命
加上--columns "first_lv_inst,second_lv_inst,first_lv_page,second_lv_page,date_str" 解决了错位问题。一开始scoop的命令是。
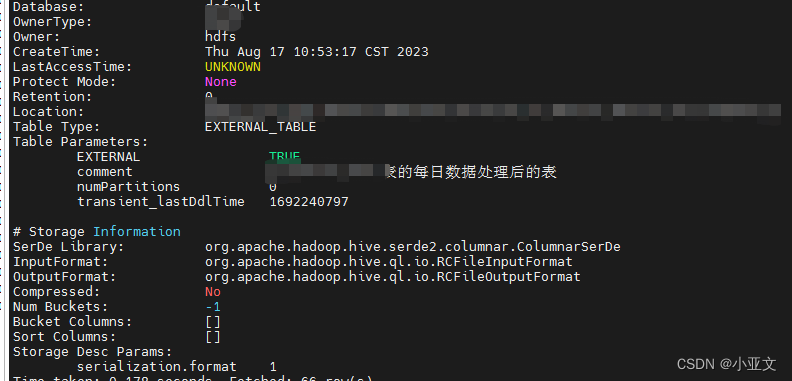
增加之后的注释,会在元数据库(一般在MySQL 中的 hive 库)中的 TABLE_PARAMS 表中显示,该表存储 表/视图 的属性信息。注意:comment一定要是小写的,不能是COMMENT,且必须要加单引号!4.字段名修改添加注释。
数仓 - hive ,身份证和手机号 匹配 - 正则方式。
【代码】hive 三表full join。
java通过kerberos权限认证集成hive,并操作hive实现hive库和表、分区表的增删查等功能
hive-参数配置
spark写入hive表
【代码】[ 08S01] Could not open client transport with JDBC Uri: jdbc:hive2://172.16.27.130:10000: java.net.C。
Unable to instantiate org.apache.hadoop.hive.ql.metadata.SessionHiveMetaStoreClient
时间相关函数的使用(时间戳函数unix_timestamp()/from_unixtime()、日期处理函数datediff()/date_sub()/date_add()等)
Hive 是一个基于 Hadoop 的数据仓库工具,用于处理大规模的结构化和半结构化数据。Hive 的主要目的是提供一种类 SQL 的语言,称为 HiveQL(或 HQL),以便用户可以方便地处理数据,无需编写复杂的 MapReduce 任务。Hive 的基本原理是将 SQL 查询转换为 MapReduce 任务,然后在 Hadoop 上执行这些任务以处理数据。
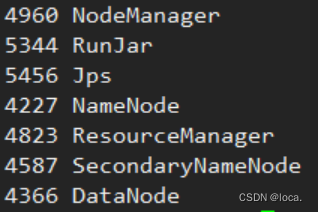
这是一篇工具类的文章,要分析调试hive源码,必须搭建一套hive的运行环境。还记得第一次搭建hive源码调试环境,用了一个月的时间,才完全跑通整个调试过程。中间遇到各种各样莫名奇妙的问题,也有好多次想放弃,幸好坚持了下来。
hive 相关使用
当设置hive.compute.query.using.stats=true时,hive在执行某些查询时,例如select count(),只利用元数据存储中保存的状态信息返回结果,从而提高了响应速度。这是一个CBO(基于成本的优化)的设置。
【hive正则匹配】like,rlike,regexp,regexp_replace,regexp_extract
hive
——hive
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 Harmony PC 开发者社区

 乐奇 Rokid 开放社区