登录社区云,与社区用户共同成长
邀请您加入社区
以ORB_SLAM2的单目初始化为例。流程:(只介绍初始化时的跟踪)在system.ccTracking::Tracking()创建一个tracking线程,传入词典向量、传感器类型、相机设置文件,以及绑定地图、关键帧数据库、地图绘制、帧绘制。然后Tracking::GrabImageMonocular()将图片转为灰度图,根据系统状态mState是未被初始化还是别的,创建当前帧(初始帧的特征点提
摘要:本文介绍了Sqoop 1.4.7的安装配置过程。特别说明Sqoop 1.4.7原生不支持Hadoop 3.3.4,但通过文章配置可有效解决兼容性问题。
第2关:Mysql导入数据至HDFS上Sqoop数据导入
可以通过sqoop直接将数据导入到HDFS中,并指定分隔符为\t,然后再利用HBase中的importtsv进行导入数据到HBase。使用bulkload方式,先在指定目录中生成HFile文件,然后将HFile文件移动到HBase相关目录下。下面的脚本中,有使用put的方式进行导数据到hbase中的方式,还有bulkload的方式,注意区分。,那么可能是因为MySQL的数据同步到Hive的时候,H
Sqoop环境搭建前提,已经安装Jdk,mysql,Hadoop,Hive,Zookeeper,HBase。sqoop-1.4.6-cdh5.14.2.tar.gz下载链接:https://pan.baidu.com/s/12ycO9ekiFAZji7yL1Jou5A提取码:laj8mysql 5.1.38驱动包下载链接:https://pan.baidu.com/s/1fSkQYaqUmBSBC
1)使用连接池连接池可以减少每次连接 MySQL 数据库的开销,提高连接复用率,从而提高系统的并发处理能力。常见的连接池有 C3P0、Druid 等。2)使用批量插入批量插入可以减少每次插入的开销,提高插入效率。可以通过 JDBC 的 addBatch() 和 executeBatch() 方法实现批量插入。3)使用事务事务可以保证多个操作的原子性,避免数据不一致的情况。可以通过 JDBC 的 s
如果导入时没有指定–hbase-create-table,则需要在运行前在hbase中创建该表和对应列族,不然在进行导入时会失败。如果指定了–hbase-create-table,则在检测到没有该表时,sqoop会自动创建目标表和列族。因为我之前讲customer表导入到hdfs过,所以报错customer已存在,只需要将–hbase-table customer中的customer表改个名字重新
sqoop ERROR manager.CatalogQueryManager: Failed to list databases报这样的错可以试试关闭物理机的防火墙
sqoop工具将数据从Hive导出到mysql中文乱码问题常用从hive导出数据到mysql的sqoop执行语句:bin/sqoop export \--connect jdbc:mysql://bigdata01:3306/etl \--username root \--password 123456 \--table twobatchavgscore \--num-mappers 1 \--e
sqoop从mysql导数据到hdfs报错: SQLException in nextKeyValueCaused by: java.sql.SQLException: YEARCaused by: java.lang.IllegalArgumentException: YEAR
ubuntu伪分布式hdfs中用sqoop工具将hive仓库中的数据导出导入到mysql数据库里时出现的错误。尝试一下将~/tmp/sqoop-chen/compile/中生成的文件夹里面的.jar.java.calss文件复制到/usr/local/sqoop/lib/文件夹里面,然后再次运行导出导入命令上面的sqoop-chen目录是 sqoop-用户名导出导入命令:上面的解决办法:再次运行后
还是需要从hdfs下载到本地再用cat -A查看。结果发现分隔符是“^A” 因此参数应该是下面这样。参考博客,一开始也是使用了如下的错误方法,以为分隔符是“^I”。我一共尝试过以下三种参数,最后一条才好使。参考下面的博客成功爬坑!
我的hive的这个表的数据格式和mysql表里的多不上,导致出错。查找日志然而也并没有真正找得到解决的办法,经过调整hive的表的格式,然后就好了。这个困扰了我很久的问题终于找到了。后来我终于找到原因了。
但是在传数据到MySQL后,数据出现了乱序。由于已解决,问题不再 就无法截图了。今晚我在hive建表时已通过order by对数据进行了排序。在MySQL表中设置主键即可解决该问题。
sqoop导入hive成功,hive查不到数据
sqoop数据同步工具的使用一文教你学会使用sqoop将mysql数据库中的十张表导入到大数据平台hive中
Sqoop导出数据报错:Illegal character in scheme name at index 0: [file:///usr/…/hive-hcatalog-core.jar]不积硅步,无以至千里。1、作业任务使用Sqoop导出hive的数据到SqlServer# 脚本sqoop export --connect 'jdbc:sqlserver://主机名:端口;database=库
在学习途中,欢迎指正和交流1.Sqoop job 工具,实现定时任务和任务保存:sqoop job工具:sqoop job工具可以用于创建保存经常使用的命令为一个任务,还可以用于实现定时调用任务,用于sqoop增量导入新数据。sqoop job 工具:sqoop job工具可以用于创建保存经常使用的命令为一个任务,还可以用于实现定时调用任务,用于sqoop增量导入新数据。...
ERROR tool.BaseSqoopTool: Error parsing arguments for import:21/07/19 16:13:56 ERROR tool.BaseSqoopTool: Unrecognized argument: --hive-imp要把ip从localhost改成ip或者IP映射的主机名
zakaban的使用azkaban任务文件的注意事项:文件后缀需要是job,文件格式为无bom的utf8;写完任务文件后需要压缩为zip文件上传到azkaban的web界面以执行;任务文件中任何相对路径的引用文件需要和任务文件一起压缩到zip中。简单任务定义一个单任务,名称为foo,内容如下:type=commandcommand=echo 'foo'任务流任务流就是任务之间存在依赖关系(通过de
你在启动mysql的时候mysql -u root -p后面没有输入密码所以你在传的时候也不需要输入密码sqoop export --connect jdbc:mysql://localhost:3306/dbb --table small_user --username root-p --fields-terminated-by ‘,’ --export-dir /user/hive/wareh
最近在帮同事迁移数据的时候sqoop老是报错,错误也不明显,在网上搜了一圈也没找,然后自己根据错误一步一步进行了排查,最终找到了原因,看到数据、表字段类型以及迁移表名是才恍悟,在做数据同步时一定要心细一些,不然问题五花八门错误如下:[root@master ~]# sqoop export --connect “jdbc:mysql://172.23.20.142:3306/tds?useUn..
最近在进行用sqoop将业务表数据导入到hive,在导入的时候发现一直在报一个WARN,WARN TableDefWriter:Column height had to be cast to a less precise type in Hive. 具体日志贴图.看到报警以后,查看了hive表的数据,发现数据并没有丢失,又查看了hive表结构,发现很多字段的数据类型发生了改变.在进行表导入的时候.
Sqoop(发音:skup)是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql、postgresql...)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracle ,Postgres等)中的数据导进到Hadoop的HDFS中,也可以将HDFS的数据导进到关系型数据库中。Sqoop项目开始于2009年,最早是作为Hadoop的一个第三方模块存在,后
最近项目要用Hadoop来做数据分析,所以让我先熟悉一下相关的知识,第一次接触,公司也没有人有这方面的经验,只好自己摸着石头过河,理论知识只能在之后的使用过程中慢慢积累和深入学习,现在只能先想办法把项目跑起来。环境的搭建是运维给搞好的,Hadoop是2.6.0版本,这里需要注意的是,相关端口需要运维提前给好相关权限,我用了半天时间找一个问题,最后发现是一个端口没有权限造成的,白白浪费了时间。
sqoop mysql导入hive parquet表timestamp,decimal
今天,我使用sqoop导入数据的时候遇到一个很奇怪的问题,我将mysql一张名为warehouse的表导入到hive的时候,出现如下报错提示我没有hdfs改路径的写入权限?但是正常情况我写入hdfs的路径不应该是这个路径啊,难道是日志打错了?于是我重试了几次,发现还是不行;难道是sqoop出了问题?但是我导其他表也没有问题啊;那只能是这个表有问题了,表名为warehouse,我们hive的库也叫w
Sqoop数据迁移一、Sqoop概述二、Sqoop数据迁移1.从RDB(Relational Database)导入数据到HDFS1.1标准方式全部导入表(customers)1.2通过Where语句过滤导入表(orders)1.3通过COLUMNS过滤导入表1.4使用query方式导入数据1.5使用Sqoop增量导入数据2.导入数据到hive3.导入数据到HBase4.hdfs导出到MySQL三
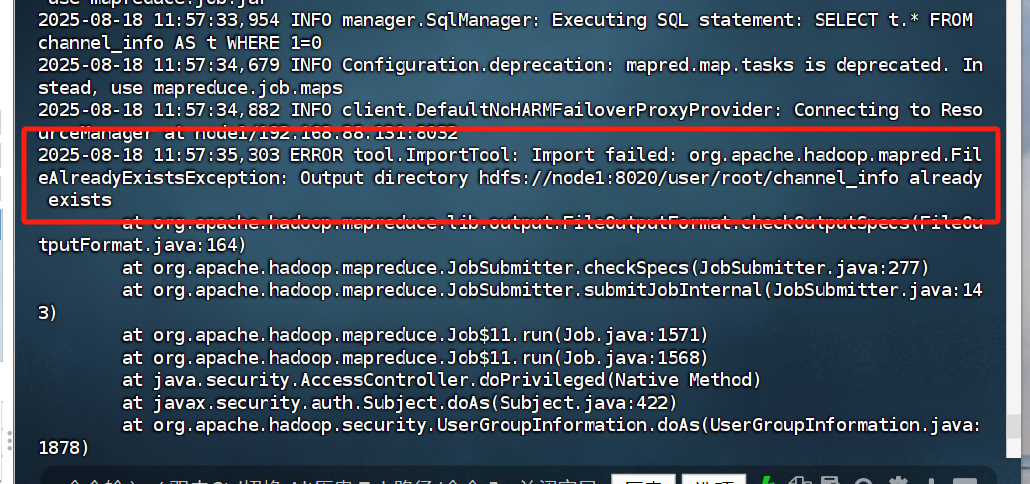
2.把文件删掉即可hdfs dfs -rm -r -f /user/root/channel_info。3.重新执行语句成功运行。
sqoop同步oracle数据进hive分区表问题
1、export 的参数2、数据同步案例sqoop export \--connect jdbc:oracle:thin:@ip:1521/服务名--username 用户名 --password 密码\--table F_L_C_EUTRANCELLTDD_H \--columns \START_TIME,END_TIME,TIME_STAMP,DN,EUTRANCELLTDD_UK,EUTRA
编写sqoop的自动shell脚本完成对hive中ods层的增量数据导入
org.apache.hadoop.hbase.HTableDescriptor.addFamily(Lorg/apache/hadoop/hbase/HColumnDescriptor;)V当我们从sqoop导入数据到hbase时遇到这个错hbase中没有建表 在hbase中根据你指定的格式建表重新导入就好了
说明:在使用sqoop工具从mysql将数据导入hive中出现以下错误:21/05/13 17:39:19 ERROR hive.HiveConfig: Could not load org.apache.hadoop.hive.conf.HiveConf. Make sure HIVE_CONF_DIR is set correctly.21/05/13 17:39:19 ERROR tool.
1.oracle导入到hive脚本/home/sqoop/sqoop-1.4.7.bin__hadoop-2.6.0/bin/sqoop import--username admin--password '123456'--connect jdbc:oracle:thin:@192.168.127.1:1521/数据库名--fields-terminated-by '\001'--null-non
一、前言虚拟机相关环境:mysql 5.7hadoop 2.60 -cdh 5.140sqoop 1.46 -cdh 5.140二、Q&A【问题-1】sqoop语句执行报:“ Ensure that you have called .close() on any active streaming result sets before attempting more queries.”【思路
使用场景:公司大数据平台ETL操作中,在使用sqoop将mysql中的数据抽取到hive中时,由于mysql库中默写字段中会有换行符,导致数据存入hive后,条数增多(每个换行符会多出带有null值得一条数据),导致统计数据不准确。解决办法:利用一下两个参数可以实现对换行等特殊字符的替换或者删除--hive-delims-replacement--hive-drop-import-delims参考
Required table missing : "DBS" in Catalog "" Schema "". DataNucleus requires this table to perform its persistence operations. Either your MetaData is incorrect, or you need to enable "datanucleus.sch
上一篇博客 同样的问题 https://blog.csdn.net/weixin_41956627/article/details/108238467今天发现mysql密码比较复杂,有个 & 符合,要用单引号括起来才行不处理的时候密码被拆了,两个报错如下:1、未找到命令,2、把mysql指到本地地址了其中192.168.x.x是远程mysql的地址,172.xxx是sqoop本地地址[ro
注意两个地方:1.时间转换问题:timestamp、date,time以上时间类型会被sqoop转成int,long型,无法直接转成时间类型如果要转的有两个办法:1)转成long型,再用from_unixtime转回来,才能看时间(太麻烦)-----parquet表的类型对应为bigintselect *, from_unixtime(cast(SOURCE_LOAD_DATE as ...
搭建hadoop环境遇到一个大坑:hadoop技术栈版本不匹配问题。搭建完hive后,和hdfs之间单独运行测试没有问题。搭建完sqoop后,sqoop和hdfs配合使用也没问题。三者共同使用,执行以下命令,将mysql中的表导入到hive中:sqoop import --connect 'jdbc:mysql://192.168.174.131:3306/ecp?useUnicode=true&
Hadoop、hive、sqoop入门及小例子
问题1:java.lang.ClassNotFoundException: Class widgets not found执行的命令:sqoop import --connect jdbc:mysql://localhost:3306/hadoopguide --username root --password root --table widgets//其中,hadoopguide是数据库名称
1、在执行Sqoop从oracle和mysql导数到hive中时,出现hive数据错位,并产生很多null值:原因是源数据中包含许多'\n'、'\r'、'\01'等字符,表在分割字段和行过程中出现错位;解决方式:在Sqoop执行中增加属性–hive-drop-import-delims,在导入数据到hive中时,去掉数据中\n,\r和\01这样的字符;--hive-drop-imp
【代码】Sqoop将mysql导入hive时split-by为文本解决。
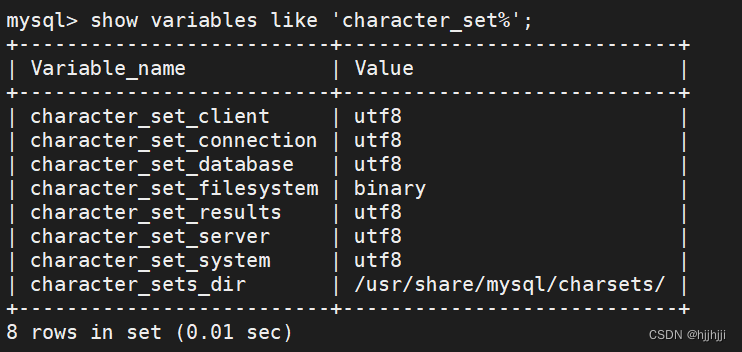
如果不是图1-1这样就需要改,或者在每次导出导入的时候添加?两个库的编码保持一直,如hive这边的编码是utf-8,mysql也要为utf-8,($代表命令)直接修改,就可以不用每次都添加?最后看一下是否为图1-1一样,否则没有修改成功。1.1检查mysql的编码。在[mysqld]下面添加。保存退出,重启mysql。
问题执行sqoop job要将mysql中数据导入hive表,执行到连接hiveserver2时就卡住不动单独执行连接hiveserver2可以正常连接Import options:sqoop import --connect jdbc:mysql://xxx:3306/test --username xxxxx --password xxxxxx--table t_user--fields-te
文章目录一.表结构二.业务处理流程三.生产数据源头四.导入/导出 框架要使用1.Sqoop简介2.sqoop 部署3.sqoop 导入4.sqoop导出一.表结构分类:树形结构id + pid1xxx02yyy1商品:归属于某个分类id name catagory_id订单表:谁 什么时间 买了什么东西订单编号会员编号总额...订单条目:商品数量单价 订单编号14天今天-14天select day
mysql中的数据,表中列出了数据导入过程中的“脏”数据\t,\n,\r,Null,下面列出了解决思路id=2 这里的des 里面有1个换行符实际为1234567id=3 desc有一个\t 实际为1234 567id=4 desc is null如果直接通过一般的sqoop导入语句bin/sqoop import \--co...
hive数据仓库构建ods层模型案例。
sqoop
——sqoop
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区

 乐奇 Rokid 开放社区







 天工造物局