登录社区云,与社区用户共同成长
邀请您加入社区
本调研对比国产AI芯片栈在C++ CUDA + TensorRT场景下的推理引擎兼容性,核心结论:除海光DCU(HIP)可实现源码级迁移外,其余平台均需重写或重构。自定义Plugin、CUDA Kernel及.plan序列化机制在多数国产栈中无等价物,昇腾CANN依赖ATC离线编译,无运行时上下文支持;寒武纪、壁仞等需底层IR重写。社区内容污染严重,多篇“实战”文章含事实错误,引用须严审。关键细节
深度学习模型的实时推理高度依赖GPU加速,PyTorch作为主流AI框架,其GPU版本的配置往往决定数字人交互系统的实际性能。理解NVIDIA驱动、CUDA与PyTorch三者的关系,是避免环境冲突的关键。确保torch.cuda.is_available()正常返回True,才能让语音驱动、口型生成等模型真正跑在GPU上,从而支撑WebRTC端的低延迟音视频交互。从版本确认、虚拟环境搭建,到官方
本文详细解析了C#中Halcon深度学习环境GPU调用异常的排查方法,重点介绍了thirdparty目录配置的关键步骤。通过分析HOperatorSet调用失败的原因,提供了完整的解决方案,包括thirdparty目录的部署、验证方法及常见问题排查技巧,帮助开发者快速解决Halcon在C#环境中GPU加速功能无法使用的问题。
本文是一份详尽的Google Colab免费GPU实战指南,旨在帮助用户从零开始高效搭建深度学习环境。文章深入解析了Colab的GPU资源配额与运行时管理规则,并提供了构建可复现环境、数据持久化存储、GPU性能优化及应对会话中断的实用技巧与避坑指南,让用户能稳定利用云端算力进行模型训练。
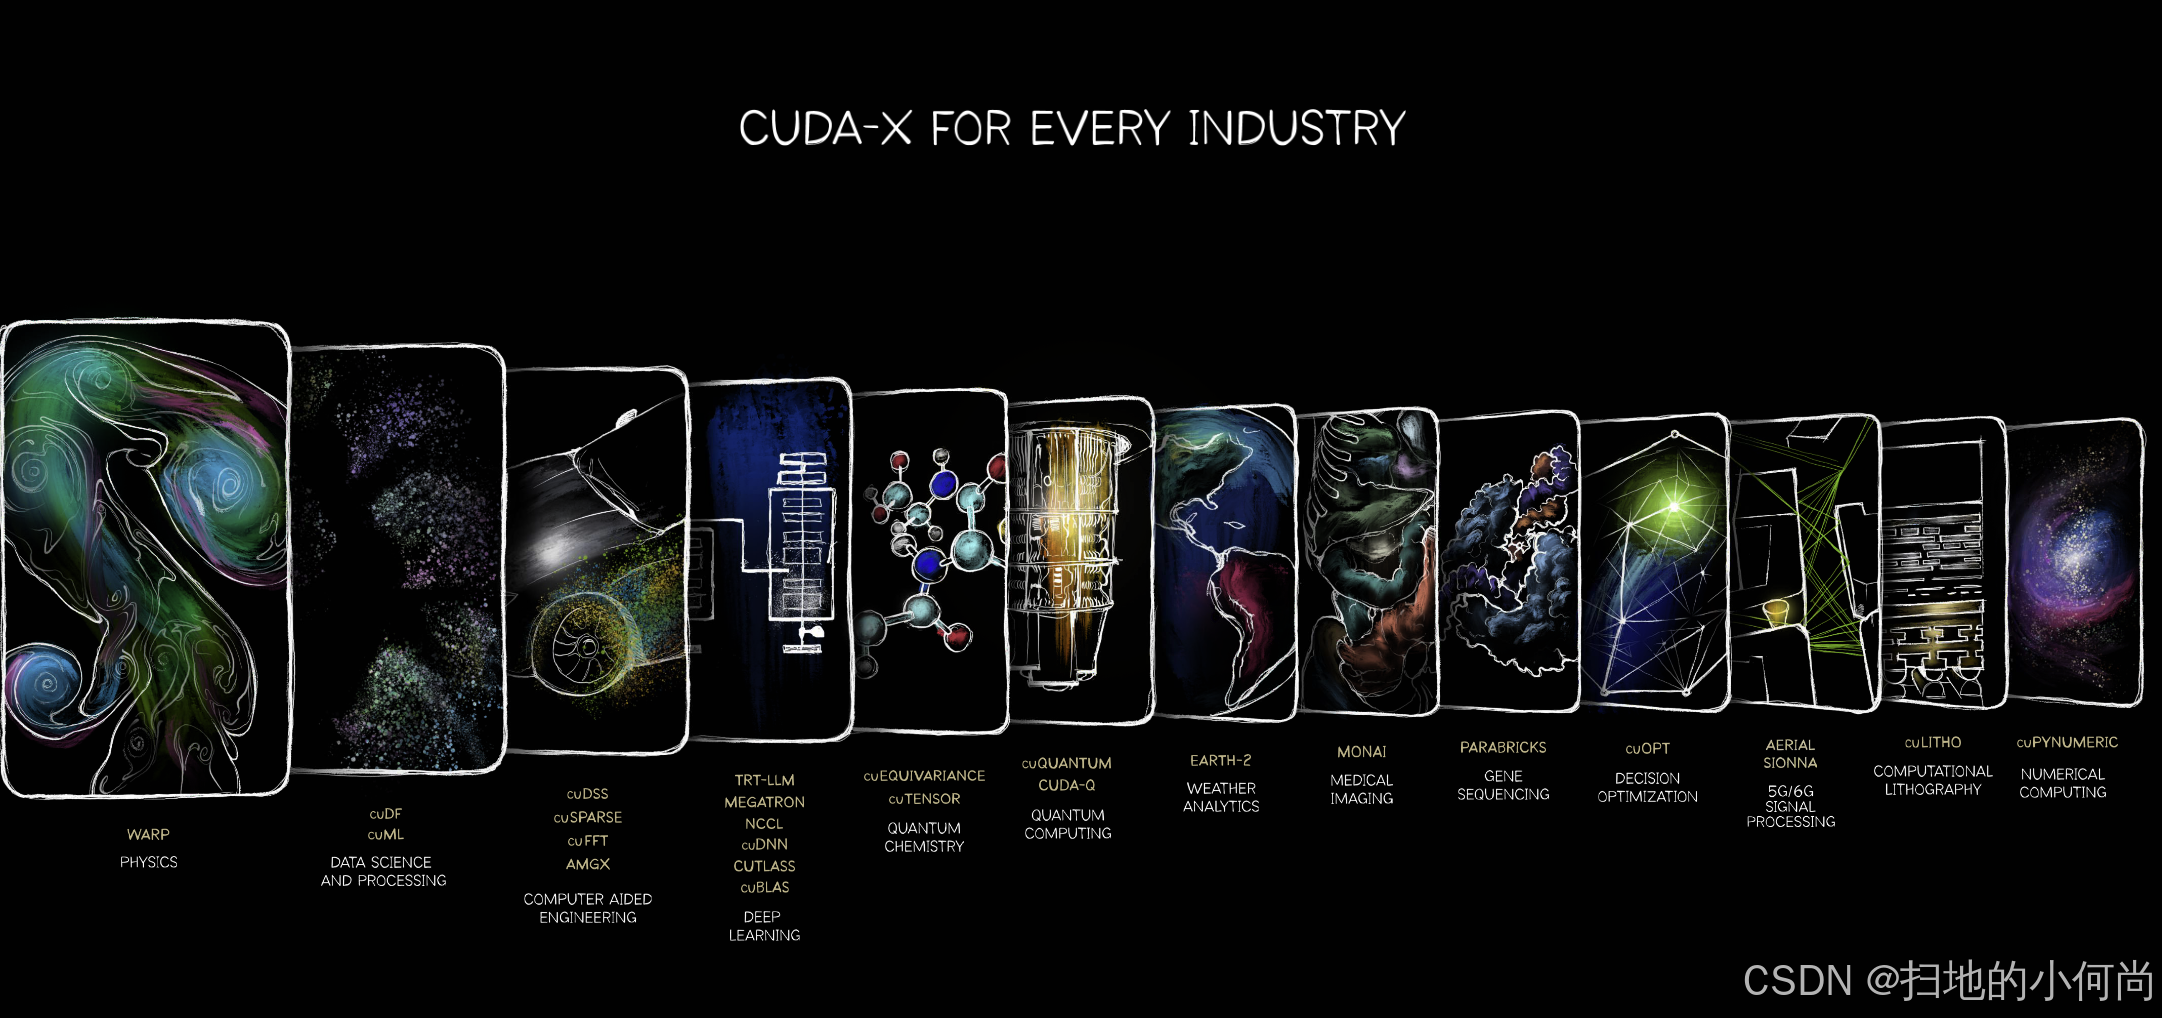
GTC 2025 老黄PPT上的26个工具(附官网链接和开发文档)
本文详细介绍了如何利用华为云ModelArts的免费GPU资源运行深度学习代码,包括环境准备、数据上传到OBS的避坑指南、JupyterLab环境配置及代码迁移技巧。通过实战步骤和优化建议,帮助开发者高效利用云端资源,降低计算成本,特别适合资源有限的学生和开发者。
以下是从NVIDIA官网转过来的链接,方便需要下载各种版本CUDA的同学。CUDA Toolkit 10.2 (Nov 2019),Versioned Online DocumentationCUDA Toolkit 10.1 update2(Aug 2019),Versioned Online DocumentationCUDA Toolkit 10.1 update1(Ma...
引言最近容器比较火,容器支持对CPU和内存的资源限制,但是GPU还不是很明朗,多个容器能不能共享一个GPU呢?如果共享的话,是并行的方式还是并发的方式呢?又如何确保GPU的资源能够被高效利用呢?本文,通过查阅大量官方文档,并通过实验验证,想一探究竟~问题描述GPU是深度学习的利器,相比于CPU,并行化的执行方式能够实现更高的时间效率。同时,它的价格也比较昂贵,此次想要做实验的NVIDI...
大模型本地部署正从极客玩具变为开发者日常需求,推理性能却常因硬件协同不当而大打折扣。理解GPU与CPU在分层推理中的分工逻辑,是性能优化的基础——显存容量决定模型能否装入,而算力与内存带宽决定生成速度快慢。KV Cache作为显存中的隐形消耗者,其大小与上下文窗口、并发请求数直接相关,通过Flash Attention和量化技术可显著降低显存占用。模型量化用微小精度损失换取大幅度资源释放,Q4_K
近日,全球知名的高性能数据可视化组件厂商发布了 LightningChart .NET 最新版本 v12.5.1。此次版本在延续一贯“极致性能”的基础上,进一步强化了图表交互能力、数据分析体验以及开发灵活性,为工业制造、金融分析、科研仿真等高复杂度应用场景带来更强支撑。
本文详细介绍了如何在百度飞桨AI Studio平台上利用后台任务功能,高效利用免费GPU资源完成遥感图像分割任务。通过告别Notebook的断线焦虑,指导用户从数据准备、模型选择、训练脚本编写到后台任务提交与监控的全流程,并分享确保长时间训练稳定性的实用技巧,帮助用户真正释放云端GPU算力。
阿里通义万相Wan2.1模型登顶Vbench榜首第一,超越Sora、HunyuanVideo、Minimax、Luma、Gen3、Pika等国内外视频生成模型。而在今天,万相Wan2.1视频生成大模型正式开源!【DiffSynth-Studio】 模型已经在趋动云『社区项目』上线,无需自己创建环境、下载模型,一键即可快速部署,快来体验【DiffSynth-Studio】带来的精彩体验吧!
在跑GPU的时候,出现错误:ImportError: libcudnn.so.7: cannot open shared object file: No such file or directory原因:默认软链的cudnn中没有相应的 libcudnn.so文件。一探究竟:(1)执行命令ll /usr/local,查看该路径下的cuda:,显示有2个版本,cuda-10.0和cuda-...
python.C语言文件IO读取树莓派CPU,GPU温度
本文介绍 NVIDIA 机密计算如何在私有生产级 AI 推理中保护敏感数据,并比较机密计算开启与关闭时的吞吐和延迟,分析数据传输、内核调优及多 GPU 通信的性能开销。
在大模型和并行计算技术快速演进的今天,GPU早已不只是图形渲染的专属硬件,更是支撑人工智能训练与推理的核心算力底座。当一台由多张消费级或中端计算卡组成的中配AI集群,因显存容量有限而难以流畅运行超大参数规模的LLM时,是否就意味着它失去了价值?答案并非如此。GPU的本质是通用并行计算芯片,通过CUDA与硬件编解码单元(如NVENC/NVDEC),它能够在视频转码、图像处理、批量渲染等场景中释放强大
在构建实时音视频应用时,WebRTC负责传输音视频流,而AI互动数字人的智能交互依赖于服务端的深度学习模型。PyTorch作为当前主流的深度学习框架,是语音识别、语音合成、数字人驱动等模型训练和推理的重要基础。GPU通过CUDA实现并行计算,能显著降低模型推理延迟,保证数字人对话的流畅性和口型同步。安装GPU版PyTorch需注意显卡驱动版本与CUDA Runtime的匹配,并通过官方源获取编译好
以 AMD Ryzen 9 7950X 和 NVIDIA H100 SXM 为例,从封装、缓存边界、Zen 4 核心与 SM 执行组织,解释 CPU 和 GPU 怎样处理指令与数据。结合一次可复算的矩阵乘法,说明并行、数据复用与存储层次如何影响深度学习,并区分训练、预填充和解码的性能瓶颈。
一、PhyRenderDoc是什么 PhyRenderDoc 是飞腾OpenHarmony开发团队基于 RenderDoc 开源框架面向 Phytium 平台深度定制的 GPU 图形调试工具。本工具集成了帧捕获、着色器调试、像素历史追溯和管线状态分析等核心功能,支持开发人员在 OpenHarmony(OHOS)设备上通过 EGLHook 劫持截取 GPU 应用,能够有效简化图形应用开发调试流程、提
在Jetson tx1 上安装了ubuntu16.04系统,然后安装QtCreator时出现undefined reference to `drmCloseOnce`,/usr/lib/aarch64-linux-gnnu/libGL.so的错误。 解决方法,把链接重新指向:$cd /usr/lib/aarch64-linux-gnu$sudo rm libGL.so$sud
1、GPU作用:负责整个渲染流水线。它会从处理CPU传递过来的模型数据开始,进行Vertex Shader、Fragment Shader等一系列工作,最后输出屏幕上的每个像素。因此它的性能瓶颈包括顶点、像素、显存等因素有关。2、顶点优化 1)优化几何体 unity-game视图-stats页签可观察三角形数目和顶点数目。 方案:尽可能减少模型中三角形的
本文详细介绍了如何使用gpu-burn工具进行GPU压力测试,快速定位故障卡。通过全卡压力测试、系统日志分析和隔离测试等步骤,帮助运维人员精准识别GPU硬件问题,提高故障排查效率。文章还提供了高级排查技巧和常见故障模式对照表,适用于多卡服务器环境。
最近新做了一个GPU项目,采用飞腾D3000+MR100组成GPU模块进行运算,MR100就是天数智芯智铠100的产品子卡。这里采用FFT运算对MR100芯片进行测试。
模型压缩技术正经历从孤立优化到协同作战剪枝为量化扫平结构障碍1bit量化突破存储边界蒸馏训练实现知识高保真迁移开发者行动指南中小模型:首选LLM-Shearing剪枝(HuggingFace已集成)千亿模型:采用SparseGPT+OneBit组合边缘设备:部署TensorRT优化后的1bit引擎当70B模型能在手机端流畅运行,当AI推理成本降至百分之一——模型压缩不仅是技术,更是普惠AI的基石。
本文主要介绍国产DCU加速处理器与其它品牌GPU加速卡实测性能对比
CUDA__global__ 函数中:执行sizeof( class ) 的结果与 __host__中结果不一致,经分析,是由于类是继承于一个基类,且他的一个成员也是继承于同一基类:如下:class A0{}class A1{}class B0: public A0{double v;}class B1: public A0{B0 v;}B1 的size就是 sizeof(B0)+8=16clas
在人工智能模型推理领域,GPU算力已成为核心基础设施。其原理在于通过并行计算架构加速矩阵运算,显著提升模型前向传播速度。这一技术价值在于,它使得个人开发者和小型团队能够以可负担的成本,访问原本昂贵的高性能计算资源,从而专注于模型创新与应用开发。应用场景广泛覆盖大语言模型(LLM)文本生成、视觉模型推理以及多模态AI Agent等复杂任务。面对下一代高性能GPU(如RTX 5090)的普及,算力租赁
数据并行 Data Parallelism每块GPU上都有完整的模型(每个GPU上的模型参数是一样的)。将原来的训练数据切分为多份,分别投喂到每个GPU上的模型。每个GPU并行运行,随后进行模型的梯度汇总更新以及不同GPU的通信/状态同步。模型并行 Model Parallelism模型并行就是:我们把模型切分,分布在不同的GPU上,随后将完整的数据送到这些切分后的不同模块中进行运算,最后将运算结
摘要:在高性能计算、娱乐和科学计算市场,opencl的采用在持续增长。opencl的灵活性和便携性使之成为了一个开发图像处理应用的优秀平台。然而,opencl尚未应用到硬拷贝打印机和多功能打印机(mfp)市场。传统上,打印机/mfp市场使用全定制系统级芯片(soc或asic)、专用集成电路进行图像处理。在本文中,我们探讨了配合alterasoc fpga(现场可编程门阵列)的opencl在核心mf
UWA AI、社区双助力,解难题更高效
本文详细解析了Ollama多GPU配置中最常见的5个问题及解决方案,包括GPU设备识别不全、环境变量失效、显存分配不均、通信瓶颈和模型并行度限制。通过实战案例和具体命令,帮助开发者高效解决多GPU配置中的难题,提升AI模型训练效率。
在租用实例后发现系统自带libjpeg-turbo8-dev,libjpeg-turbo8因此选择则安装tightvncserver。###Would you like to enter a view-only password选择no。miniconda3+ubantu(20.04)+python3.8+cuda11.8,启用无卡模式。若连接不上,执行下面命令再重新启动连接。#告诉VNC启动什么
本文为服务器性能测试人员提供了快速验证CUDA环境配置正确性的完整指南。通过从硬件识别、驱动兼容性检查到运行官方示例和压力测试的步骤,确保GPU服务器环境稳定就绪,从而获得真实可靠的性能测试数据。
FluxGym 是一款用于简化 Flux LoRA 模型训练的工具,特别适用于低显存环境(如12GB、16GB或20GB VRAM)。LoRA 模型是一种低秩适应技术,允许在较小的数据集上微调大型模型,而无需大量计算资源。FluxGym 为用户提供了一个图形界面,使得即使没有深厚编程背景的用户也可以轻松上手训练 Flux LoRA 模型。
rocm-smi command not found
至此, vulkan 的跨平台能力已经得到了充分验证: GNU/Linux (wayland), Android (手机), Windows (PC) 等操作系统 (平台), 都实现了 vulkan 初始化和绘制三角形. 本文相关的完整源代码请见:vulkan 部分, 底层基于 vulkano 库, 已经封装好了, 属于平台无关代码, 各平台都一样. 窗口系统部分, 每个平台都不一样. 这里我们没
一块GPU中往往分为不同的组件,通常是Cuda Core, Ray Tracing Core,MMU,GPU任务调度器Q等等,这些组件的上电一般是有一个严格的顺序的,你需要在KMD中的合适位置依次配置这些模块的时钟频率“和上电信号,至此,可以算是GPU刚刚启动了。GPU用电这件事情说来简单,实际很复杂,比如GPU在不同负载的工作场景下,所需要的电压可能是不一样的这需要KMD这里做出判断和对GPU的
前言我发现CUDA版本装9.2真心不是一个好主意,不仅TensorFlow没有官方的CUDA9.2支持(Github上有别人编译好了的,可以找一下如果需要),现在PyTorch更新stable版的1.0了,也暂时只有CUDA 8.0, 9.0, 10.0的支持,除非从源码编译,而且考虑到之后装keras、TFLearn、tensorlayer等怕出问题,就准备把我的CUDA降级成9.0.卸载C..
Ubuntu18.04下安装Caffe-GPU时执行以下语句:for req in $(cat requirements.txt); do pip install $req; done出现了以下错误:pandas 0.22.0 has requirement python-dateutil>=2, but you'll have python-dateutil 1.5
在Chromium中,由于GPU进程的存在,WebGL端、Render端和Browser端的GPU命令是代理给GPU进程执行的。Chromium将它们要执行的GPU命令进行编码,然后写入到一个命令缓冲区中,最后传递给GPU进程。GPU进程从这个命令缓冲区读出GPU命令之后,就进行解码,然后调用对应的OpenGL函数。本文就详细分析WebGL端、Render端和Browser端执行GPU命令的过程。
硬件 PCI 识别校验驱动与容器运行时校验。lspci命令用于确认服务器 BIOS、系统底层识别到算力硬件,仅代表物理设备可被系统发现;smi/gmi系列工具验证内核驱动与固件加载正常;容器运行时检测,用于确认容器环境可透传算力设备,是容器化 AI 业务上线前必做检查。本文汇总 NVIDIA、AMD、昇腾、海光 DCU、沐曦、摩尔线程、天数智芯、寒武纪、平头哥主流算力芯片的 PCI 厂商 ID、设
本文详细介绍了如何利用Mac的M1/M2芯片GPU加速YOLOv8训练,通过Metal Performance Shaders(MPS)技术实现效率提升3倍以上。从环境配置到实战优化,提供全面的加速指南,帮助开发者充分释放Apple Silicon的潜力。
本项目基于单片机和RA8889/RA6809图形处理芯片的TFT触摸屏滑动条控件。该控件支持水平和垂直滑动条,可自定义外观和行为,并支持回调函数进行值变化通知。
目的 :1. 使用比较好的高端游戏平台(不很贵),测试在Matlab平台下Nvidia显卡和Intel I7 CPU的做并行计算性能 2.解决如下问题(1) 性能是1-2倍差距,还是5-20倍差距,还是50-100倍差距?(2)要考虑并行计算的话 ,需不需要在有限预算下配高端游戏显卡,还是以配更好的CPU为主?(3)信号处理的算法(非信息处理)的应用背景下,程序的编写简便和运行
一只399美元的开源双足机器鸭Microduck,凭借强化学习与开源生态引爆社区。24小时订单超260万美元,社区已开发跑步、跳跃、单腿平衡等数十种动作策略,真实硬件验证成功。无需显卡,通过云端GPU(如UCloud V100S)按小时付费即可训练自定义行为,从仿真到发布仅需数步。代码全开源,人人可参与,让具身智能训练从“围观”变为“亲手上手”。
GPU
——GPU
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 人工智能6S服务平台

 火山引擎视频云技术社区

 乐奇 Rokid 开放社区





 NVIDIA AI 技术专区


 亚马逊云科技技术品牌专区

 Laval社区


 天工造物局




 DAMO开发者矩阵