登录社区云,与社区用户共同成长
邀请您加入社区
torch/# 存放大家熟悉的python模块csrc# 用C++实现的pytorch前端的功能,包括python和C++的binding,autograd和JITaten# "A Tensor Library"的缩写src/ATen# 用C++实现的tensor基本操作c10# Caffe2和 A Tensor的双关语,包含pytorch的核心抽象,以及tensor和存储数据结构的实际实现。
CANN全面开源开放,正成为智能交通统一高效的算力使能平台。为促进交通行业开发者交流、共建CANN交通生态,CANN开源社区正式发起「智能交通SIG首次技术沙龙」暨"AI+公路"蓝皮书发布会,10月17日相约南京建邺。📅 活动基础信息:CANN 开源社区智能交通 SIG 首次技术沙龙暨 “AI + 公路” 蓝皮书发布会:2026年10月17日(周六)09:00-17:30:江苏省南京市建邺区楠溪
B站预约链接:点击预约
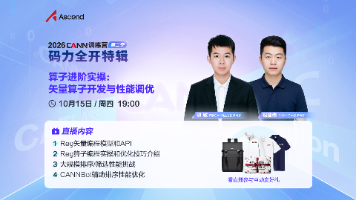
📎2026年CANN训练营第二季报名页链接:https://www.hiascend.com/developer/activities/cann20262#cann-camp-2602-intro。👉 issue链接:https://gitcode.com/org/cann/discussions/292。📲 关注【昇腾CANN】视频号,锁定最新直播信息,干货福利不错过!🎥 视频号、B站、
随着大模型、AI感知技术加速落地,智慧公路、车路协同、交通巡检等场景迎来爆发期。但行业依然面临算子适配难、模型迁移成本高、软硬协同落地复杂等现实问题。为打通产学研交流链路,搭建CANN开源社区在交通行业的开发者交流阵地,正式启动报名!本次活动落地南京建邺,汇聚行业专家、科研学者、一线工程实践者,围绕交通大模型、网联载具、智慧公路建设、无人机巡检等议题做深度分享,现场重磅发布行业蓝皮书,与开发者一起
围绕DeepSeek V4.1,昇腾950端到端训推参考实践分享。
高性能计算与AI基础设施的演进中,算子编译与分布式通信一直是决定大模型训练效率的关键。面对国产芯片生态,开发者常需在底层指令与现成算子库之间艰难权衡。TileLang作为面向昇腾平台的高级语言编译工具,通过接近Python的语法描述调度逻辑,自动完成tile切分、循环优化与内存搬移,大幅降低自研算子门槛。配套的高性能计算库则对卷积、Attention等高频算子做了系统性调优,并贴近主流API设计以
边缘AI推理依赖于专用NPU硬件与配套软件栈的协同工作,其核心原理是通过模型转换工具将训练框架模型编译为NPU可执行的离线模型,从而在低功耗条件下实现高效推理。这一技术路径的价值在于将AI能力下沉到终端侧,广泛应用于智能安防、工业质检和自动驾驶等场景。在昇腾生态中,CANN工具链和ATC模型转换是连接PyTorch/ONNX模型与昇腾310B NPU的关键环节,而Atlas 200I DK A2开
在深度学习模型部署中,NPU(神经网络处理器)正成为推理加速的重要选择。与GPU不同,NPU采用专用架构,针对矩阵运算优化,能在低功耗下实现高效AI推理。昇腾(Ascend)作为国产AI计算平台,提供从模型转换到推理的完整工具链,其核心流程是将PyTorch等框架训练好的模型导出为ONNX格式,再通过ATC工具转换为昇腾NPU可执行的OM模型。这一链路使得YOLO等目标检测模型能够在Atlas 3
大模型本地部署是指在边缘设备上直接运行模型推理,减少云端依赖,提升隐私与实时性。其原理基于异构计算架构,通过专用AI加速单元(如NPU)与模型量化、格式转换等技术,实现高效能低功耗推理。技术价值在于打破算力瓶颈,让大模型在资源受限设备上落地。典型应用场景包括离线文档问答、代码补全、工业巡检助手等。香橙派AIpro搭载昇腾310B处理器,结合CANN工具链与MindSpore Lite推理引擎,通过
在人工智能推理加速领域,NPU(神经网络处理器)正成为边缘计算与视频分析场景的重要选择。与GPU通用计算架构不同,NPU基于专用算子库和脉动阵列设计,需要配套的工具链才能发挥性能。华为昇腾CANN作为NPU的软件开发栈,承担着算子映射、图编译与运行时调度的关键作用。对于目标检测任务,YOLO系列模型凭借高效的单阶段结构,成为工业落地最广泛的算法之一。然而,将YOLOv5/YOLOv8部署到昇腾At
本文深入探讨了ONNX模型在昇腾芯片上的跨平台部署挑战,重点分析了OPset版本兼容性问题及其解决方案。通过版本降级、ATC工具适配和模型优化等策略,实现高效部署。文章还提供了昇腾生态下的最佳实践和未来趋势展望,助力开发者解决模型部署中的版本博弈问题。
本文详细解析了在昇腾平台上进行PyTorch模型迁移的全流程,包括环境配置、性能优化和精度达标等关键步骤。通过实战案例和避坑指南,帮助开发者高效完成从GPU到NPU的迁移,提升模型推理性能。特别针对昇腾NPU的硬件特性,提供了混合精度配置、算子融合等优化技巧,确保迁移后的模型在功能、精度和性能上达到最佳状态。
本文详细介绍了如何利用昇腾CANN开发高性能AI算子,通过对比CUDA与Ascend C的编程范式,揭示如何充分利用Cube/Vector单元特性实现计算密度最大化。文章包含实战案例和避坑指南,帮助开发者在昇腾平台上优化AI算子性能,提升吞吐量和能效。
本文深入探讨了昇腾CANN Tiling优化技术,从内存对齐到多核负载均衡的实战技巧。通过详细示例和性能数据,展示了如何通过智能数据分块和动态任务分配提升AI芯片计算效率,特别适用于大规模矩阵运算和复杂模型优化场景。
本文全面解析了DeepSeek-R1蒸馏70B模型在昇腾Atlas 900A2硬件平台上的性能优化策略,涵盖硬件资源分配、容器参数调优、模型量化、服务化部署等关键环节。通过详细的配置示例和性能对比数据,展示了如何最大化利用昇腾AI处理器的计算能力,为大型语言模型的高效部署提供实践指导。
本文详细解析了在昇腾A2平台上通过Docker部署MindIE-Service时常见的七大问题及解决方案,涵盖NPU设备映射、内存配置、服务参数调优等关键环节。针对深度学习推理服务的容器化部署,提供了从驱动版本管理到性能调优的实战经验,帮助开发者高效避坑并提升部署成功率。
本文详细解析了在昇腾硬件上使用vLLM运行Qwen3-Next模型时遇到的GPU显存泄漏问题,提供了从根源分析到解决方案的完整实操指南。通过环境配置检查、显存回收方案、生产部署策略和性能监控体系,帮助开发者实现稳定高效的长期推理服务。
本文详细介绍了在昇腾NPU加速卡上使用Docker部署MindIE-Service推理服务的完整实战流程。内容涵盖环境检查、镜像获取、Docker命令编排、容器内配置及深度故障排查,重点解析了多卡部署、内存配置等关键参数,旨在帮助工程师高效避坑,快速构建稳定的AI推理服务环境。
本文详细解析了在昇腾NPU上部署Llama大模型并进行性能调优的全流程。内容涵盖从环境搭建、模型获取与转换,到性能瓶颈分析与实战调优技巧,包括动态Shape处理、数据搬运优化及显存管理等关键环节,并提供了构建非结构化数据ETL管道的实战案例,旨在帮助开发者高效利用昇腾硬件部署和优化大模型应用。
本文详细介绍了在昇腾Atlas NPU上,使用MindSpeed LLM套件对Qwen2.5-7B大语言模型进行从零开始的预训练与指令微调全流程实战。内容涵盖环境配置、模型权重获取与格式转换、数据预处理、分布式训练脚本配置以及关键的避坑指南,旨在帮助开发者高效利用国产AI硬件完成大模型训练任务。
本文是一份昇腾CANN实战指南,手把手教你使用Ascend C开发高性能AI算子。文章从理解昇腾AI处理器架构与Ascend C编程范式入手,通过向量加法实例详解开发流程,并以LayerNorm融合算子为例深入探讨性能调优技巧与内存访问优化。最后,提供了关键的避坑指南与高级调试方法,旨在帮助开发者突破大模型训练中的算子性能瓶颈。
本文详细介绍了在昇腾平台上从零搭建PyTorch-NPU大语言模型(LLM)推理环境的完整流程。内容涵盖硬件检查、驱动与CANN安装、PyTorch及torch-npu插件的版本匹配与安装、环境验证,并以部署ChatGLM3-6B为例进行实战演示。文章重点解析了版本兼容性等常见问题,旨在帮助开发者高效配置LLM推理环境。
本文深度解析华为昇腾MindIE技术栈的三大核心组件:MindIE-RT、MindIE-Torch和MindIE-Service。文章提供了从模型转换、优化到服务化部署的完整实战指南,重点阐述了如何利用该全栈方案高效构建企业级AI推理服务,特别是针对大模型推理场景的性能优化与部署实践。
本文深入探讨了如何利用昇腾CANN架构中的DVPP硬件加速技术,构建高效的多路视频流实时处理框架。通过生产者-消费者模型与异步流水线设计,结合CANN Stream机制,实现了视频解码、图像预处理与AI推理的全流程硬件加速,显著提升了处理吞吐量并降低了端到端延迟,为安防监控等实时视频分析场景提供了高性能解决方案。
本文详细介绍了如何利用昇腾NPU与vLLM协同优化大模型推理性能。从环境搭建、Docker部署到核心调优策略,深入探讨了如何通过PagedAttention、Continuous Batching以及昇腾特有的NPU图编译、算子优化等技术,实现高吞吐、低延迟的推理服务,并提供了应对高并发与保障生产稳定性的实战指南。
本文是一份针对昇腾MindSpeed MM多模态模型微调的实战避坑指南。文章详细解析了从环境搭建、数据准备到训练调参、评估部署的全流程,重点分享了如何高效利用MindSpeed MM套件在昇腾NPU上完成多模态模型微调,并整合了关键的微调技巧与常见问题解决方案,帮助开发者顺利上手。
本文详细介绍了将NVIDIA Megatron-LM框架迁移到华为昇腾NPU平台的完整流程,包括:迁移背景概述、环境准备、模型迁移、验证与问题排查。该方案充分利用昇腾NPU的硬件优势,在保证模型精度的同时提高训练效率,为自主算力平台的大模型训练提供了可行路径。
使用 GPUStack 在昇腾 Ascend 910B 上运行 Qwen2.5 全系列的推理性能表现
之所以安装飞桨,是因为想在启智社区的启智大脑调试环境使用最新的PaddleNLP,结果报错:No module named 'paddle.nn.layer.layers',提issue。仔细看飞桨提供的npu版本,原来是amd64架构的,而启智社区是aarch64架构,所以最终使用安装包失败。以前在启智社区都是编译安装飞桨,这回看到飞桨提供了npu安装包,兴冲冲的以为安装很简单。安装好之后,再创
围绕DeepSeek V4.1,昇腾950端到端训推参考实践分享系列。
📎2026年CANN训练营第二季报名页链接:https://www.hiascend.com/developer/activities/cann20262#cann-camp-2602-calendar。👉 issue链接:https://gitcode.com/org/cann/discussions/292。📲 关注【昇腾CANN】视频号,锁定最新直播信息,干货福利不错过!🎥 视频号、
围绕DeepSeek V4.1,昇腾950端到端训推参考实践分享。
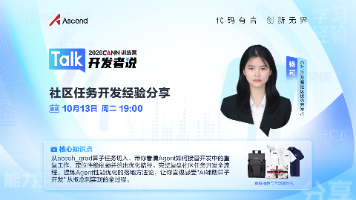
我们诚挚邀请高校和社区开发者共同参与:补充有依据的技术知识,贡献经过验证的排错经验,反馈缺失或过时的内容。让每一份贡献,融入生态的持续发展。这些知识卡由知识库统一维护,可供不同Skill在执行任务时按需查阅,让Skill专注于任务流程,减少技术资料的重复收录与多处更新。文档、源码、开发记录中的技术知识,被统一提炼为可检索、可核验、可更新的知识卡,为设计、实现、调试与优化提供统一的知识入口。知识:先
随着人工智能技术在电力行业的深入应用,行业智能化对 AI 计算性能、效率以及算力适配能力提出了更高要求。为推动 AI 技术与电力行业应用深度融合,本次大赛基于电力行业典型场景的实际需求设计赛题,组织开展昇腾行业算子开发与性能优化实践,探索高效、高质量的行业算力优化方案。赛事将联合产业伙伴,共同推动优秀成果开源、共享、应用,不断产生并积累实用算子、实际开发经验、优秀开发者,基于CANN开源社区电力S
昇腾
——昇腾
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区


 CANN开发者社区

 人工智能6S服务平台