登录社区云,与社区用户共同成长
邀请您加入社区
二自由度机械臂正逆运动学仿真simulink最近我在研究二自由度机械臂的正逆运动学仿真,使用的工具是Simulink和MATLAB Simscape Multibody,感觉还挺有意思的,今天就来跟大家分享一下。
本文介绍了一款六轴协作机械臂的完整技术方案,包含硬件参数、控制源码和调试参数。该机械臂具有820mm臂展、5kg负载能力和±0.02mm定位精度,支持Modbus和以太网通讯。提供了Python主控源码,包括串口通信、角度转换、归位复位和抓取控制等功能,以及C语言驱动片段。系统采用S型平滑插补算法,内置伺服驱动参数和多种补偿机制(原点偏移、温漂等),防护等级达IP65,适用于工业自动化场景。调试参
本文公开GR3六轴机械臂底层开发核心源码,包含:1)主控C语言裸机驱动(寄存器直写、轴控制、力矩校准);2)运动学正逆解浮点运算实现;3)以太网TCP透传协议;4)伺服EEPROM烧录汇编代码;5)电流采样闭环控制;6)硬件映射参数表(脉冲当量0.000872mm、编码器分辨率131072等);7)故障代码表。所有代码均为原生未封装版本,涉及内存地址需根据硬件版本调整,可直接用于底层数据解析与设备
本文档详细披露了GR3六轴机械臂的核心底层技术,包含13项关键模块的源码与参数配置。主要内容包括:弱磁扩速算法实现1800rpm以上调速、带HAL延时的转子初始对准校准、多谐波电流注入抑制方案、柔性力控的刚度/阻尼调节逻辑、绝对式编码器32bit数据解析协议、72MHz时钟树配置、梯形加减速离散算法、21.5V备用电源切换阈值、48字节/帧的轨迹存储格式、电磁刹车驱动时序控制、42℃温控风扇策略、
本文档披露了GR3六轴协作机械臂的底层核心参数,包含六大关节的伺服控制参数(位置/速度环P/I增益、阻尼前馈、扭矩阈值)、各连杆质量与质心坐标等动力学数据、总线通讯协议帧结构(帧头/功能码/刷新周期)、机械限位范围(关节1硬限位±175°)、故障寄存器地址映射(过流0x0101/过压0x0102)、以及插补算法精度(直线插补0.001mm)等工业级原始数据。特别标注了不同批次固件可能存在±0x03
本文深入探讨HNSW算法在向量检索中的优化与性能调优,结合faiss和hnswlib的实战经验,详细解析核心参数配置与高并发场景下的优化策略。通过对比测试,展示HNSW在电商推荐、内容匹配等场景中的高效表现,帮助开发者快速掌握ANN技术应用。
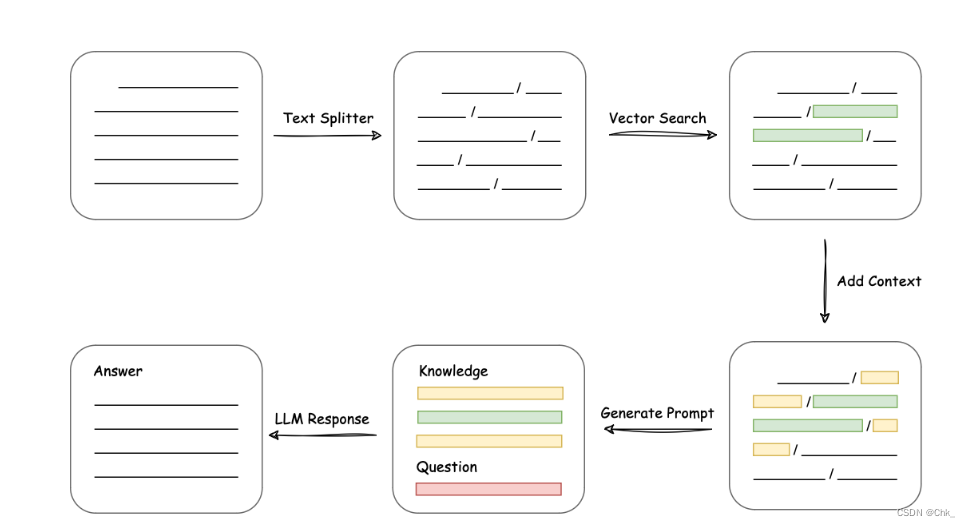
该项目基于FastAPI构建后端,集成LangChain实现多格式文档(TXT/PDF/Word)处理,通过文本分块、向量化(Ollama的bge-m3模型)和FAISS索引实现语义检索。结合DeepSeek API进行检索增强生成(RAG),流式返回问答结果。支持知识库元数据管理(MySQL)、文件上传(UUID重命名存储)和跨域访问。核心流程:用户上传文档→向量化存储→提问时检索相关片段→构造
作为一名从事向量搜索和推荐系统开发的工程师,我经常被Faiss中L2距离和余弦相似度的选择问题所困扰。本文将深入剖析这两种距离度量方式在Faiss中的实现原理、本质区别以及各自适用的应用场景,帮助你做出更合适的技术选型。
(Facebook AI Similarity Search)是一个由 Facebook 开发的开源库,用于高效地进行大规模相似性搜索和稠密向量(dense vector)聚类。它主要用于处理机器学习中常见的高维向量,并且可以在大规模数据集中快速找到相似向量。
Faiss 是一个用于高效相似性搜索和聚类的库,特别适用于大规模数据集。它提供了一系列的算法和数据结构,能够在高维度空间中快速搜索最相似的向量。下面是 Faiss 的基本使用指南:
另一种方法是构建多个模态的独立索引,查询时分别计算查询向量与各模态数据的相似度,通过加权融合或其他策略综合决策。假设我们拥有一个包含数万张图像的数据库,目标是构建一个图像检索系统,用户上传一张图片,系统返回与之最相似的若干张图片。本案例将利用Faiss强大的向量相似度搜索能力,结合深度学习模型进行图像特征提取,实现高效准确的图像检索。查询时,将查询向量广播到各服务器,分别搜索子索引,然后汇总结果。
【代码】Elasticsearch 向量搜索:基于 FAISS 的相似性推荐系统实现。
FAISS 只存向量和下标,不存原文。检索时还要用下标找回chunks[i]sources[i]文件内容向量索引(二进制)chunks、sources,以及当时的 chunk_size / chunk_overlap注意:meta 里记下切块参数,是为了防止「向量和下标对不上新切块」。你改了 .env 里的chunk_size后,旧索引会失效,load_index返回None,强制重建。索引持久化
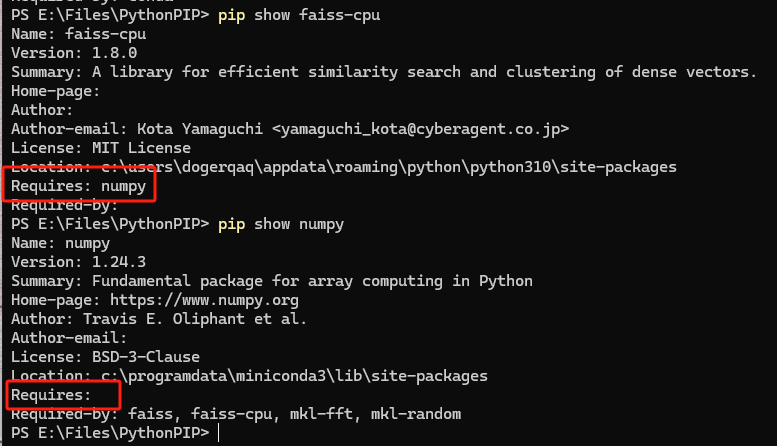
faiss-gpu安装mkl报错
本文深入剖析了一个基于 Faiss + MongoDB + Tornado 构建的百万级人脸特征向量检索系统,涵盖特征归一化、余弦相似度近似计算、分段分数映射、HNSW 分片索引、索引持久化与增量恢复、Canopy 在线聚类归档等核心技术细节。同时从 Faiss 单机内存库的局限性出发,对比了 Milvus、Pinecone、Weaviate、Qdrant 等现代向量数据库,给出了生产环境下的选型
Langchain中向量数据库FAISS的使用
HNSW的主要idea是构建一个图,使得两个点之间只需要很短的几跳究竟能到达(这也是大部分graph-based算法所关注到的)根据现实世界的六度握手原理:世界上所有的人都能够在六次联系内联系到另一个人在介绍HNSW的工作流程前,先介绍一下跳表(skip lists)和可导航小世界(navigable small world)。这是一个概率数据结构,可在排序列表中插入和搜索元素,平均耗时为Olog
windows11使用pip install faiss-gpu安装FAISS向量数据库失败。
用GPU的话根据cuda版本安装对应的包。
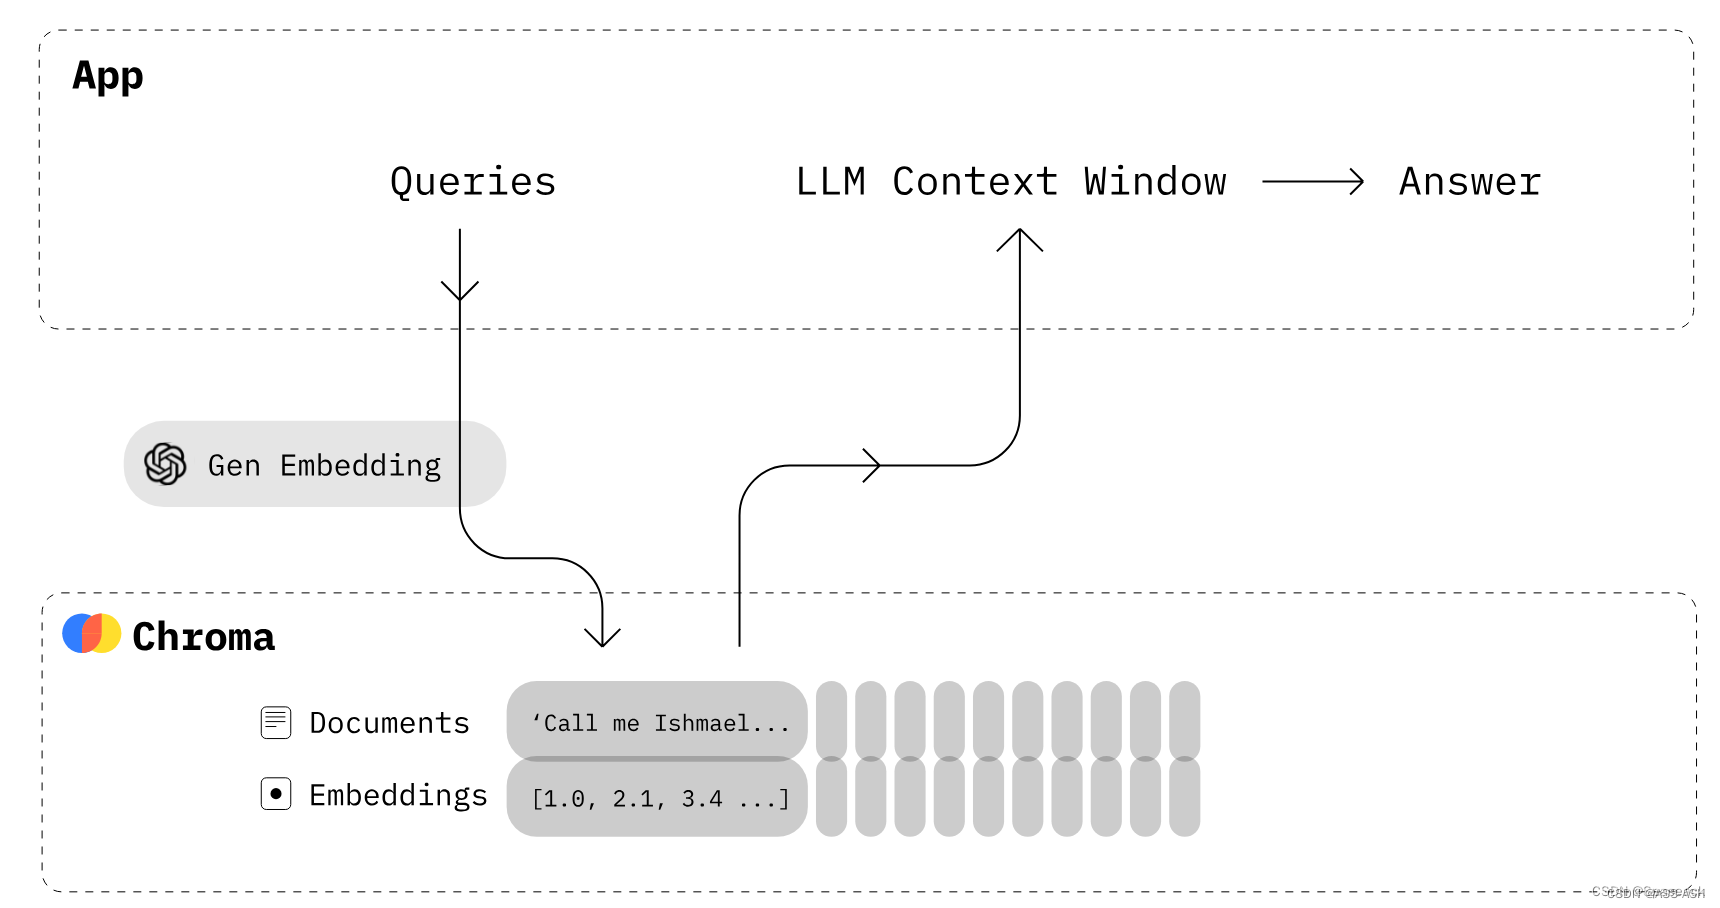
Embedding是将高维数据转换为低维向量的技术,可保留语义信息并计算相似度。典型应用包括:1)推荐系统,通过向量相似度推荐相关内容;2)语义搜索,使用预训练模型生成句子向量进行智能检索;3)异常检测,通过向量距离发现异常数据;4)图像检索,利用深度学习模型提取特征向量进行相似图片搜索。这些场景都依赖向量数据库存储和高效查询嵌入向量,实现了从关键词匹配到语义理解的跨越。
本文介绍了如何从零搭建一个简易的RAG问答系统,采用Python技术栈(FastAPI后端+Streamlit前端)。系统包含完整的RAG流程:文档预处理(PDF加载/切分)、向量化(使用OllamaEmbeddings和FAISS)、检索增强生成(基于qwen3:14b模型)。项目采用模块化结构,包含data、indexs、config等标准目录。作者通过代码示例演示了核心实现,并指出当前系统的
向量数据库(VectorDatabase)是一种专门用于存储、管理和检索高维向量数据的数据库系统,主要用于实现相似度搜索(SimilaritySearch)。向量是机器学习和人工智能中表示数据的数学结构,如图片、文本、用户兴趣等都可以通过神经网络模型转换为嵌入向量(embedding)。传统数据库不适合处理向量的相似性检索,而向量数据库则能高效支持语义搜索、推荐系统、图像识别等需求。其特点包括支持
引言本文将介绍如何利用谷歌的Agent Development Kit(ADK)框架,结合本地化运行的大语言模型(如通过Ollama部署的Gemma3或Llama3.2),通过Model Context Protocol(MCP)协议调用外部工具实现实时搜索功能。我们将基于ADK框架开发一个YouTube视频搜索智能体。该智能体将使用Gemma 3模型进行推理与响应生成,并通过MCP协议动态调用工
在搭建RAG系统时,选择合适的向量数据库是至关重要的。向量数据库能够 高效地 存储和检索大规模的 向量数据,为RAG系统提供快速、准确的检索支持。今天针对当下主流的 Milvus、Qdrant、Weaviate、FAISS、RediSearch 等主流向量数据库,他们也都是 开源 的向量数据库,给大家简单介绍下,供您参考。Milvus支持多种高效的索引结构,如IVF、HNSW等,能够在 毫秒级响应
通过以上步骤,你可以使用 OpenAI 的模型和 FAISS 库构建一个高效的向量数据库。这个数据库可以用于多种自然语言处理任务,如语义搜索、文档检索等。你可以根据具体需求调整代码中的参数和功能。
FAISS结合LangChain为大规模相似度搜索提供了高效、灵活的解决方案。FAISS官方文档LangChain社区教程。
使用 Langchain 和 FAISS 来一步一步构建一个(相对)高效的知识库系统
在现代数据驱动的应用中,向量相似性搜索变得越来越重要,尤其是在推荐系统、图像搜索、自然语言处理等领域。Faiss(Facebook AI Similarity Search)作为一个强大的库,专门用于高效相似性搜索和稠密向量聚类,支持在大规模向量数据上进行快速搜索和处理。本文将详细介绍Faiss的搭建与使用,帮助您快速上手这一工具。
向量数据是一种数据类型,通常用于数学、物理学、计算机科学和数据分析等领域。数学向量在数学中,向量是一个具有大小和方向的量,可以在平面上或空间中表示为箭头。数学向量可以是一维的(比如数轴上的点),也可以是高维的,但通常至少是二维或三维的,以便能够表示方向。例如,在二维空间中,向量 ( \vec{V} = (x, y) ) 有两个分量,分别表示在x轴和y轴上的分量。数据向量在数据科学和机器学习中,向量
Faiss(Facebook AI Similarity Search)是一个高效的向量相似性搜索库,专为高维向量数据的搜索和聚类设计。以下是如何搭建和使用Faiss的详细步骤。
基于图索引的方式,包括 regular graph(图中每个顶点具有相同数目的邻居)、random graph(图中每个顶点的邻居数是随机的)和 small world graph(介于 regular 与 random 之间)。Faiss 是 Facebook AI 研究院开发的一种高效的相似性搜索和聚类库,能够快速处理大规模数据,并支持在高维空间中进行相似性搜索。首先,需要在系统上安装 Fai
Faiss是由Facebook AI Research团队开发的一个开源库,专门用于高效地进行大规模向量的相似性搜索和聚类。它支持对十亿级别的向量进行搜索,是目前较为成熟的近似近邻搜索库之一。Faiss用C++编写,并提供了与Numpy紧密结合的Python接口,不仅支持CPU计算,对一些核心算法还支持GPU计算。海光DCU(Data Center Unit)是一款高效通用的GPGPU加速卡,专为
在大数据与 AI 的时代,向量数据库在高效搜索与相似度检索场景中扮演了至关重要的角色。Faiss(Facebook AI Similarity Search)作为一款强大的开源向量数据库,以其优越的性能和灵活的配置选项,成为处理高维向量检索的理想选择。本文将探讨 Faiss 的基本特点与核心技术原理、基础维护,以及基本使用,从而帮助用户搭建出高效的向量数据库解决方案。
Faiss是一个专门针对向量和高维数据设计的数据库系统,它支持向量之间的相似性搜索,使得在大规模数据集中寻找最相似的项变得非常高效。从图1-50中可以看出,输出的distances矩阵包含了查询向量和其最近邻向量之间的距离。在这个例子中,distances是一个5x4的矩阵,因为对5个查询向量执行了搜索,并请求了每个查询向量的4个最近邻。distances和indices分别是距离和索引的数组,其
需要使用相同的文本嵌入模型,然后加载本地向量数据,给他创建索引器,通过提示词,让大模型去查找出对于的知识库信息。运行成功会再磁盘生成faiss文件。
知识库是区别于大模型之外。很多资料并没有进入通用大模型里面。比如保留在自己本地的知识记录,文档。每个公司还都有自己的一些知识文档等。这些都是知识库的来源。知识库通过把这些资料收集并学习,形成了一个有别于大模型之外的私有模型。知识库的导入类型分为本地文档,在线数据,Notion, 飞书,自定义。本地文档包含三种1 文本格式:word,pdf,txt2 表格格式:excel,csv3 照片类型1本地文
在现代人工智能应用中,向量数据库(Vector Store)已经成为处理大规模文本数据的核心工具之一。本文将介绍如何使用Faiss构建一个向量数据库,并演示如何进行文档查询。文中的示例代码将通过中专API地址调用OpenAI的大模型,以确保代码在中国境内的可用性。
向量化计划通过Faiss向量数据库实现.文本嵌入后,考虑对嵌入的向量归入Faiss库。
es的一个概念就是去中心化,字面上理解就是无中心节点,这是对于集群外部来说的,因为从外部来看es集群,在逻辑上是个整体,你与任何一个节点的通信和与整个es。它是以插件方式存在的一个es服务,通过读取river中的数据并把它索引到es中,官方的river有couchDB的,RabbitMQ的,代表索引分片,es可以把一个完整的索引分成多个分片,这样的好处是可以把一个大的索引拆分成多个,分布到不同的节
在构建大模型知识库,即检索增强生成 (RAG) 服务时,中间存在一个核心环节就是向量化搜索,如果不希望引入第三方的向量数据库,那么开源的 Faiss 就是一个不错的选择。Faiss 是 FaceBook 提供的开源向量库搜索库,在Github上已经有 28.1k star,相对成熟而且使用方便。之前构建的 RAG 服务使用的就是 Faiss 提供的向量化搜索服务,Faiss 功能强大,上手简单。但
离线安装python相关依赖
faiss
——faiss
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区


 北京朝阳AI社区


 乐奇 Rokid 开放社区





 2048 AI社区

 天工造物局

 DAMO开发者矩阵