登录社区云,与社区用户共同成长
邀请您加入社区
"这只是核心逻辑,"我说,"完整版会用 OOP 封装:一个类管数据加载(解析时间戳、坐标列),一个类管数据清洗(去重、插值、滤波),一个类管速度计算(位移/时间 + 移动平均平滑),一个类管突变检测(加速度阈值 + 滑动窗口),一个类管可视化(3D 轨迹图 + 速度剖面 + 突变点标记)。"明白了,"我打开 VS Code,"你需要一个程序:读取机器人轨迹采样数据,用相邻两点间的距离除以时间间隔算
你需要在部署前,用 Python 把点位数据集拉进来,跟现场实际的安全工作区间做一遍比对,筛出超限点,数清楚有多少个,具体是哪些。"这只是核心逻辑,"我说,"完整版会用 OOP 封装:一个类管点位数据加载,一个类管安全工作区间定义和校验,一个类管异常筛选和统计,一个类管可视化——把异常点在 3D 散点图上标红。"我不是没有检查,"小周说,"离线软件里仿真过了,轨迹是通的。"你需要的是部署前的最后一
"哥们,我们车间炸锅了。"你看,"阿强指着监控屏幕上的拓扑图,"冲压机A过热,它连着传送带B,传送带B停了,焊接机器人C检测不到来料就报警停机,装配工位D等不到零件也停了。"你看,"我指着图,"故障从液压泵出发,沿着'液压泵→冲压机→传送带→焊接机器人→装配工位'这条路径传播,用了67秒瘫痪整条线。"阿强说,"问题是,报警灯亮了,你去看,十台设备有八台亮红灯。* 根因追溯算法:从所有故障节点出发,
"阿杰说,"机器人粗磨完了,零件还在夹具上,得有人取下来放到精磨台上。反过来也一样——工人精磨完了,等着机器人出下一个粗磨件,机器人还在磨呢,工人也只能干等。"你看,"我指着图,"当前方案的问题在于'装夹'这个动作没人负责——机器人干完粗磨,得等工人来取。"我说,"机器人干粗磨是合适的,但装夹这个动作,你让它等人工来取,就成了瓶颈。反过来,有时候机器人还在粗磨,工人已经精磨完上一个,只能干等机器人
本文为实用NumPy代数指南,涵盖数组代数、广播、矩阵乘法、张量操作、多项式计算、最小二乘与特征值分析。强调区分逐元素运算与矩阵代数,明确shape、axis、dtype语义,善用broadcasting与einsum实现高效向量化计算。通过残差、恒等式与数值稳定性验证结果,推荐使用np.allclose进行浮点比较,确保代数逻辑正确性。代码示例可直接运行,适用于科学计算与工程建模。
"我们车间有句行话:'全网拓扑是给网管看的,产线拓扑是给工程师用的。核心矛盾:"网络管理需要清晰的单产线拓扑以实施隔离和排障"与"全车间拓扑数据混杂,缺乏按产线属性提取子图的能力"之间的冲突。ax.set_title(f"{target_line} 网络拓扑({G.number_of_nodes()} 节点, {G.number_of_edges()} 条边)",。"小陈指着图的一角,"这条线有1
本实训报告聚焦具身智能在工业视觉中的应用,涵盖工具软件安装、工业视觉环境构建及昇腾终端部署。基于Python与EasyOCR实现跨平台文字识别,适配Windows CPU与昇腾Atlas200I DK A2板卡(aarch64欧拉系统),通过虚拟环境配置、USB海康相机接入与PaddleOCR引擎调用,完成中文文本识别、人脸与人体检测的实时分析。代码支持中文字体渲染与置信度显示,具备良好可移植性与
下载完pytorch之后想验证一下cuda好不好使,在测试的时候发现一个warning。降级后再进到python验证cuda就没有warning和报错了,顺利的运行了。我下载的pytorch版本比较低,numpy太高,所以需要手动给numpy降级。python中报错如下。
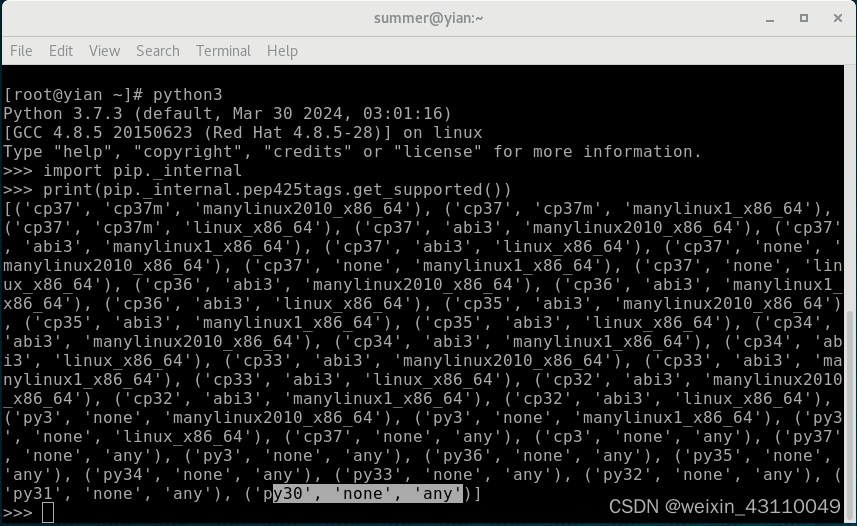
2、下载上面支持的安装包(cp37 -> 支持python3.7;4、执行命令python3,确认库安装成功。执行命令python3。
ps : 我的 pandas 的 version 是 0.23.4。出现的错误:(标题打不下了,,,)
Python内部实现数组与标量相加时,使用“广播机制”先将标量5转换成元素值为5的5 x 7二维数组,再将scores和新生成的数组按位相加,等价于以下代码。例题[2-9] 生成均值为0、方差为1服从正态分布的4 x 5二维数组。生成5x6的二维随机整数,随机数的数值是0或1.数组的元素值随机生成,范围内的整数数组,数组的大小由参数。范围内各整数出现的概率相等。
TypeError: 'numpy.float64' object cannot be interpreted as an integer错误
一、数学运算函数名description说明[add(x1, x2, /, out, where, casting, order, …])Add arguments element-wise.按元素添加参数。[subtract(x1, x2, /, out, where, casting, …])Subtract arguments,element-wise.从元素角度减去参数。[multiply
下面是。
print('NumPy版本:', numpy.__version__);print('scikit-image版本:', skimage.__version__);print('导入成功,无兼容性冲突')"新版本的 NumPy 已经移除了这些直接导入的别名,导致。应当是当前numpy版本没有这个功能。#安装1.23.5版本的numpy。我在运行代码时碰到了这样的问题。我查看了一下当前的numpy
carla win11 使用相关问题
通过直接使用这些底层的库(OpenPyXL和xlrd),你可以避免Pandas在处理大量数据时可能带来的性能开销,因为Pandas在读取Excel文件时,会先将整个文件加载到内存中,形成一个DataFrame对象,这个过程可能会比较耗时。通过并行化OpenPyXL的使用,你可以绕过Pandas库(Pandas通常用于数据处理,但会先将数据加载到DataFrame中,这可能会成为性能瓶颈),直接从E
问题的核心是 NumPy 2.x 与部分库的兼容性问题。通过降级 NumPy 到 1.x 或升级相关依赖,可以解决这种版本冲突。如果问题仍然存在,建议使用虚拟环境彻底隔离依赖冲突。
Numpy兼容报错:A module that was compiled using NumPy 1.x cannot be run inNumPy 2.0.0 as it may crash-CSDN博客。
但是numpy已经1.21.6了。比1.17.3高,为什么还报错。
解决安装torch_geometric后,import torch出现A module that was compiled using NumPy 1.x cannot be run in NumPy 2.0.2 as it may crash.(记录)
当然name也可以用true或false,当用ture的情况下河name:1效果一样,如果用false就是排除name,显示name以外的列信息。也是可以的,当你用db.users.find()查询的时候,显示多条数据而无法一页显示的情况下,可以用it查看下一页的信息;上面介绍过forEach需要传递一个函数,函数会接受一个参数,就是当前循环的对象,然后在函数体重处理传入的参数。默认每页显示20条
线性表:是具有相同数据类型的nn0n(n>=0)nn>=0个元素的有限序列,其中n为表长,当n0n=0n0时线性表是一个空表。若用L命名线性表,则其一般表示为La1a2aiai1anLa1a2...aiai1...an相同的数据类型意味着每个元素所占的空间一样大aia_iaiana_nan是表尾元素除第一个元素外,每个元素有且仅有一个直接前驱;
Unbuntu20.04 install apollo v8.0.0 and carla0.9.14 linux build install and apollo_carla_bridge
(认真看)(总结踩坑的)前言: 本人亲身经历了十分煎熬的安装opencv教程 ,相信和不少人一样,大家都是满网搜教程,报了错继续搜教程。2后来采用pip安装,从换源(换源的版本也很重要,本人就是bullseye版本,一开始换了其他版的源,也没用),后来,自己安的时候,感觉甚至不用换源!PS:好多教程不推荐用python3.9,本人就很麻烦的换python版本,结果,本人最后还是用树莓派自带的pyt
【代码】python使用websockets库。
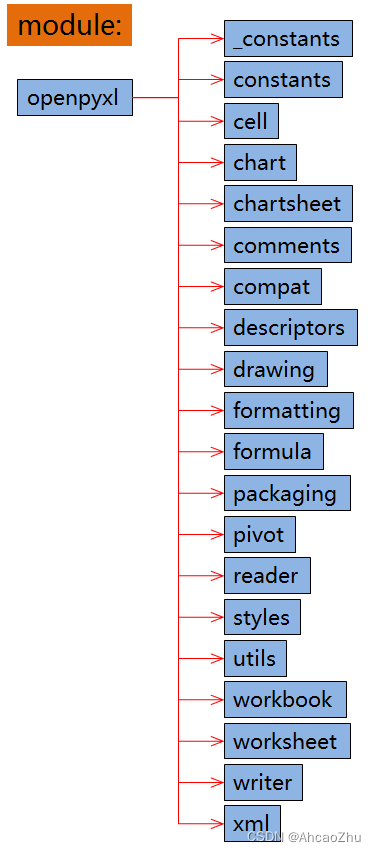
一图看懂 openpyxl 资料整理+笔记(大全)全文介绍 openpyxl的模块、函数、类及类的方法和属性。它通过代码抓取并经AI智能翻译和人工校对。是一部不可多得的权威字典类工具书。它是续集的一部分。后续陆续发布、敬请关注。【原创:AhcaoZhu大侠】https://blog.csdn.net/Ahcao2008/
NumPy 位运算
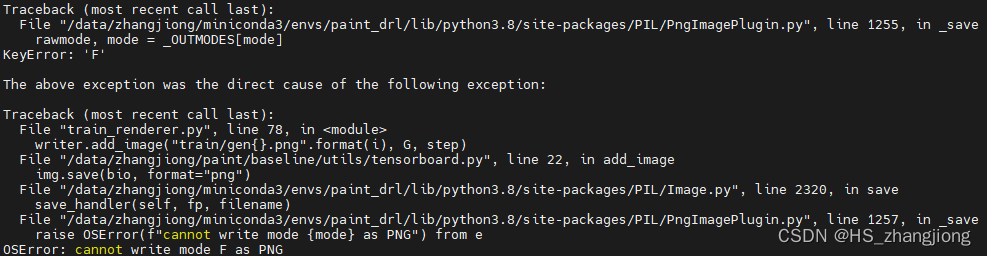
OSError: cannot write mode F as PNG
一、Series 简介。二、Series 创建方式。三、Series 属性与方法。四、DataFrame 简介。五、DataFrame 创建方式。六、DataFrame 属性与方法。
Excel文件转换为csv文件后,编码格式为ANSI,jupyternotebook/python无法读取,怎么办?
python的pandas模块学习
pandasPandas 是 Python 语言的一个扩展程序库,用于数据分析。Pandas 是一个开放源码、BSD 许可的库,提供高性能、易于使用的数据结构和数据分析工具。Pandas 名字衍生自术语 “panel data”(面板数据)和 “Python data analysis”(Python 数据分析)。Pandas 一个强大的分析结构化数据的工具集,基础是 Numpy(提供高性能的矩阵
Topic【问题描述】对于一个字母矩阵,我们称矩阵中的一个三升序列是指在矩阵中找到三个字母,它们在同一行,同一列,或者在同一 45 度的斜线上,这三个字母从左向右看、或者从上向下看是递增的。例如,如下矩阵中YQPDBKEZAFYV有BKZ、BEZ、AFY、AFV、AKP、DEF 等 6 个三升序列。注意当三个字母是从左下到右上排列时,从左向右看和从上向下看是不同的顺序。对于下面的 30 行 50
Pandas初级50题练习文章目录Pandas初级50题练习1.模块导入2.查看pandas版本信息3.从列表创建Series序列4.从Ndarray创建Series5.从dict创建Series6.修改Series索引7.Series纵向拼接8.Series按指定索引删除元素9.Series修改指定索引的元素10.Series按指定索引查找元素11.Series的切片操作12.Series加法运
pycharm提示:TypeError: type numpy.ndarray doesn’t define round method文章目录pycharm提示:TypeError: type numpy.ndarray doesn't define __round__ method一、问题二、解决将round方法改为np.round即可!一、问题matrix = round(np.array([
import pandas as pdprint("*"*25+"数据合并操作"+"*"*25)#merge按行索引操作,join按列索引操作import numpy as npdf1=pd.DataFrame(np.ones((2,4)),index=["A","B"],columns=list("abcd"))df2=pd.DataFrame(np.zeros((3,3)),ind...
问题背景:用tensorflow训练自己的数据的时候,训练一段时间后,出现TypeError: 'numpy.float64' object cannot be interpreted as an integer错误。电脑安装有numpy,版本为1.18.1电脑安装有pycocotools库查阅资料后,发现是numpy版本的问题。两种解决方法:方法一: 将numpy换成低版本,p...
本人安装Python自动化办公库时,需要numpy、pandas、matplotlib库,但是cmd窗口下输入pip install 命令时安装工具包总是报错无法通过,具体错误如下。解决方法:在官网上下载安装包到电脑上,在使用下载好的库文件进行安装。python库的官网:https://www.lfd.uci.edu/~gohlke/pythonlibs/以上为本人针对...
数据可视化基础(七)区域填充、形状、美化样式、极坐标
在学习numpy和pandas中,大多数情况下axis=0:表示按列操作; axis=1:表示按行操作。但是在pandas中,使用dropna函数时好像不是这样,通过查阅资料看到这样的说法:axis=0:作用对象是index; axis=1:作用对象是columns知乎参考CSDN参考此文姑且就当做是对异常情况的记录吧目录正常情况异常情况正常情况numpy中:axis=0...
一、安装环境Windows7 64、python3.4所有库的下载地址:https://www.lfd.uci.edu/~gohlke/pythonlibs/二、Numpy下载1、下载Numpy:下载地址:https://www.lfd.uci.edu/~gohlke/pythonlibs/#numpycp34表示python3.4,因为我的python是amd64的,...
1、基础篇官网文献,或者更详细的资料numpy的主要目标是构造由同种元素组成的多维数组,也就是一张在的表格,因为python自带的array.array,只能创建一维数组,并且只有简单的功能。所有的元素都是同一数据类型,元素通过索引定位,索引为整数,用元组来表示。在numpy中每一个维度都被称为轴,而轴的数目就是多维数组的秩。例如:[1,2,3]是一个秩为1的数组,该轴的长度为3,可以表示三
1.从“http://www.lfd.uci.edu/~gohlke/pythonlibs/”上下载“numpy”和“scipy”的安装“.whl”文件。2.用下面命令分别进行“numpy”和“scipy”的安装“。pip install numpy-xxx.whlpip install scipy-xxx.whl
树莓派2 是一款很老的开发板了,但是它还能继续战斗。为了更好的编程体验,准备安装jupyterlab。
在树莓派armv7l平台下,通过whl文件安装numpy模块是一个相对直接且有效的方法。
pandas主要用于数据处理和分析,它提供了一系列数据结构和数据操作工具,使得处理数据更加便捷和快速。Pandas的应用场景主要在于数据清洗、数据处理、数据分析、数据挖掘等领域,如金融数据分析、统计分析、数据可视化等。此外,Pandas还集成了许多数据操作函数,如数据清洗、数据转换、数据聚合等。numpy擅长进行数值操作,如数组运算(矩阵乘法、元素wise运算等)、数学和统计函数(求和、求积、求均
numpy
——numpy
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 亚马逊云科技技术品牌专区

 人工智能6S服务平台

 乐奇 Rokid 开放社区











 天工造物局


