登录社区云,与社区用户共同成长
邀请您加入社区
本题为动态规划经典问题,机器人从网格左上角到右下角,只能向右或向下移动,且遇障碍物(值为1)不可通行。状态转移方程为:dp[i][j] = dp[i-1][j] + dp[i][j-1],若当前位置有障碍,则 dp[i][j] = 0。通过初始化 dp[0][1] = 1 简化边界处理,最终返回 dp[m][n] 即可。时间复杂度 O(mn),空间复杂度 O(mn)。
机器人从m×n网格左上角出发,每次只能向右或向下移动,求到达右下角的不同路径数。使用动态规划,状态转移方程为:dp[i][j] = dp[i-1][j] + dp[i][j-1]。初始化dp[0][1]=1,简化边界处理。第一行和第一列仅有一条路径(全向右或全向下)。时间复杂度O(mn),空间复杂度O(mn)。代码实现简洁高效,适用于m,n≤100。
对于kmp算法next数组和匹配过程的理解
首先就是创建next表,这个是kmp算法的关键,我就习惯用-1的表了,需要注意的是,在遍历模式串的时候,要先写while退回的,再写if前进的,不然到时候退回了,如果后面还有相等就没法加上,next就出错了。进入主代码,卡哥用大量的篇幅去证明一个事情,最大相等前后缀不包含的字串,如果是存在,并且是可以整除模式串的,那么这个模式串就是重复的子字符串。总结出来就是一句代码的事情,但是证明起来却需要理解
本文讲解机器人从 m×n 网格左上角到右下角的路径计数问题。核心思路:只能向右或向下移动,因此每个格子的路径数等于其上方与左方路径数之和,可用动态规划求解。方法一使用二维数组,空间复杂度 O(m×n);方法二通过滚动一维数组优化,仅保留上一行状态,将空间降至 O(n),时间复杂度仍为 O(m×n),实现高效求解。
在传递给函数之前,nums 在预先未知的某个下标 k(0 <= k < nums.length)上进行了 旋转 ,使数组变为 [nums[k], nums[k+1], …, nums[k-1]](下标 从 0 开始 计数)。例如, [0,1,2,4,4,4,5,6,6,7] 在下标 5 处经旋转后可能变为 [4,5,6,6,7,0,1,2,4,4]。输入:nums = [2,5,6,0,0,1,2
通过滑动窗口技术,结合频率数组和计数器的精准控制,该算法能够在 线性时间复杂度 内高效解决最小覆盖子串问题。频率数组的正负值设计:简化了冗余字符的处理。计数器的动态更新:避免全量检查字符频率。边界条件的鲁棒性:通过初始化 min_length 为 -1,明确标识无效状态。此问题不仅考察对滑动窗口的理解,还要求对字符频率管理和边界条件的细致处理,是算法设计中的经典范例。
通过按右端点排序和贪心遍历,我们以 O(n log n) 的时间复杂度高效解决了问题。代码简洁且覆盖所有边界条件,体现了贪心算法“局部最优即全局最优”的核心思想。理解排序策略与射箭位置更新的逻辑,是掌握此类区间覆盖问题的关键。
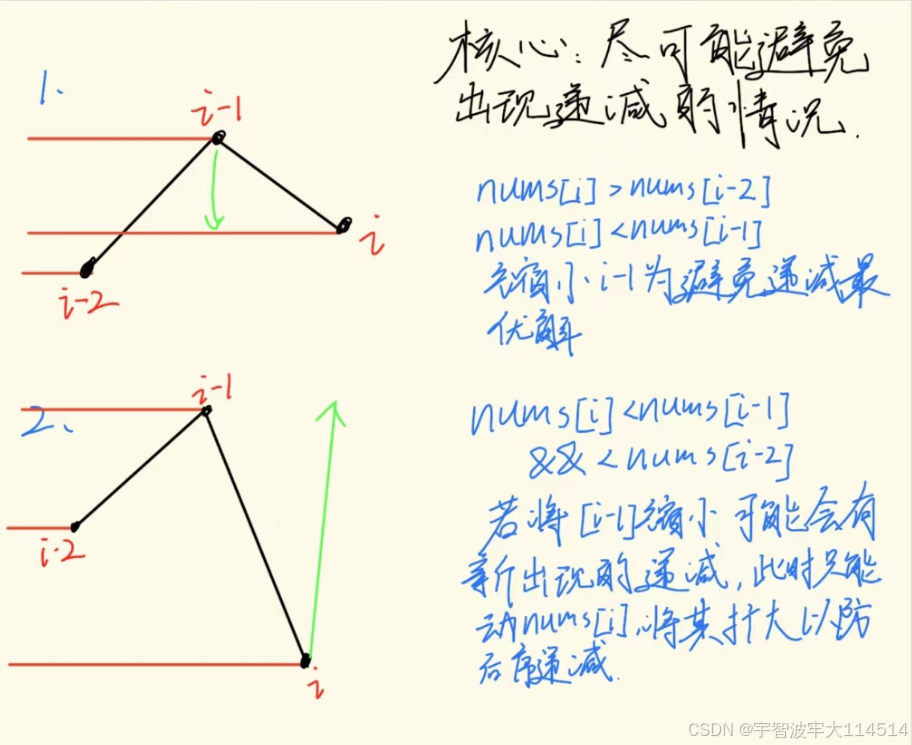
给定一个整数数组nums,最多允许修改1 个元素,判断是否能将其变为非递减数列。非递减数列的定义为:对于所有,满足。通过动态选择修改前一个或当前元素的策略,可以在单次遍历中高效解决问题。前序约束检查:利用nums[i-2]判断修改的安全性。贪心决策:每次修改以最小化对后续的影响。该算法的时间复杂度为O(n),空间复杂度为O(1),适用于大规模数据场景。理解策略选择的逻辑依据,是掌握此类问题的关键。
在非递减数列问题中,贪心算法的“局部”范围需包含三个元素(nums[i-2]nums[i-1]nums[i]),以确保每次修改不破坏前序递增性。依赖链分析:修改的影响可能传递到更早的元素。约束完整性:局部范围需覆盖所有关键约束条件。反例验证:通过测试案例验证范围的充分性。贪心算法的核心挑战在于如何定义“局部”。通过分析问题的依赖关系和约束传递性,可以合理划定局部范围,从而设计出高效的贪心策略。这一
我们通过巧妙的边界处理策略,在保证正确性的前提下,最大限度地利用了二分查找的效率优势。安全边界跳跃:利用nums[mid]与边界的比较结果,安全地排除不可能区域动态有序判断:根据中间值与边界的比较结果,动态选择搜索方向鲁棒性处理:兼容包含大量重复元素的极端情况信息最大化利用:即使无法确定整体有序性,仍通过局部信息指导搜索渐进式处理:通过逐步缩小问题规模应对复杂情况健壮性优先:在最坏情况下仍能保证正
Floyd判圈算法(又称龟兔赛跑算法)是解决链表环路检测问题的经典方法。它通过(一个快指针每次走两步,一个慢指针每次走一步)来判断链表是否存在环,并在存在环时找到环的起始点。
通过比较中间值与右边界,算法能高效定位旋转数组的最小值,同时处理重复元素。直接比较左边界会导致逻辑漏洞,尤其在完全升序或复杂旋转场景下失效。右边界比较策略凭借其天然的区间划分优势,成为解决此类问题的可靠方法。
条件重构:通过位运算将奇偶位置统一处理模式识别:利用有序性建立的成对规律深入理解数据特征(有序性、重复模式)对算法设计的影响掌握位运算在索引处理中的巧妙应用培养将特殊位置判断转换为统一逻辑的抽象能力这种类型的题目在面试中常见于考察候选人对二分查找变种应用的能力,理解其中的模式识别和索引处理技巧,可以帮助我们更好地应对类似的算法问题,拥有计算机的数学思维也尤其重要。位运算优势:充分利用CPU的硬件特
在一个非递减数组中,寻找目标值的起始和结束位置。若不存在,返回[-1, -1]。需在O(log n)时间内完成。
本题通过巧妙的排序策略和插入顺序选择,将原本复杂的问题转化为可高效解决的贪心算法问题。处理顺序决定算法可行性迭代器操作的正确使用掌握这种"先排序后插入"的解题范式,能够有效解决一大类需要满足位置约束的算法问题。
通过将双指针初始化为合理的范围,并动态调整指针位置,该算法将时间复杂度从O©优化至O(√c),完美解决超时问题。核心在于利用有序性减少不必要的计算。通过对比两种代码,相信读者也能对双指针拥有更进一步的理解。
在解决区间调度问题时,贪心算法是一种高效且直观的方法。下面笔者将详细介绍如何利用贪心算法解决“移除最少数量的区间以使剩余区间互不重叠”的问题,并逐步解析其技术实现细节。
本文系统讲解了LeetCode 42题"接雨水"的解题思路。核心思想是将总雨水量拆解为计算每一列上方能接的水量,其关键在于确定每列左右两侧的最高挡板高度。水位高度由两侧较矮的挡板决定(min(左最高,右最高)),减去当前柱子高度即为该列可接水量。文章详细阐述了如何通过预处理前后缀最大值数组来优化计算,将复杂度从O(n²)降至O(n),并提供了清晰的Java代码实现,帮助读者深入
本文介绍了如何使用栈结构高效求解逆波兰表达式(后缀表达式)。逆波兰表达式的特点是运算符在操作数之后,计算时只需从左到右扫描。栈的LIFO特性完美契合该需求:遇到数字入栈,遇到运算符则弹出栈顶两个数字计算后将结果重新入栈。关键点在于注意减法和除法中操作数的弹出顺序(第一个弹出的是右操作数)。文章提供了Java实现代码,并分析了O(N)的时间复杂度和空间复杂度。这道题展示了栈在处理顺序依赖运算中的核心
本文系统讲解了LeetCode 15. 三数之和的解题思路,从暴力枚举到双指针优化。暴力解法使用三层循环和HashSet去重,时间复杂度为O(n^3)。优化解法通过排序数组、双指针和剪枝将复杂度降至O(n^2)。关键点包括:排序固定顺序、双指针移动策略、i和左右指针的去重处理,以及边界控制。文章详细分析了去重的三种类型和剪枝原理,帮助读者深入理解这道经典题目。
本文解析了LeetCode 160题"相交链表"的解法。通过长度差对齐法,先计算两链表长度差,让较长链表的指针先走差值步,使两指针处于同一起跑线后再同步前进,最终找到交点或确认无交点。该方法时间复杂度O(N+M),空间复杂度O(1),避免了复杂边界条件,体现了预处理思想。关键点包括指针复位、节点对象比较而非值比较,以及无需特殊处理无交点情况。
本文介绍了Leetcode606题将二叉树转换为字符串的解法。关键在于前序遍历时合理处理括号:节点值直接输出,左右子树用括号包裹,但需遵循特定规则:左子树为空而右子树存在时必须保留空括号(),其他情况下空括号可省略以避免歧义。文章详细解析了三种情况处理规则,提供了递归实现代码,并通过示例验证正确性。时间复杂度O(n),空间复杂度O(h)。核心要点是正确处理"左空右不空"的特殊情
本文介绍了一种稳定分区链表的算法。给定单链表和目标值x,要求将小于x的节点排在前面且保持相对顺序。核心思路是使用四个指针维护两个区间(小于x和大于等于x),通过尾插法分别构建两个子链表,最后拼接并处理边界情况。关键点包括:1)尾插法保持稳定性;2)拼接后必须断开原链表的残留指针;3)处理全小或全大的边界情况。该算法时间复杂度O(n),空间复杂度O(1),适用于多种链表重排问题。建议在遍历时先断开当
本文探讨了高效查找字符串中第一个不重复字符的两种解法:数组映射法和HashMap计数法。两种方法都采用"空间换时间"策略,先统计字符频率再查找第一个唯一字符。数组法利用ASCII码作为索引,访问速度快但仅适用于有限字符集;HashMap法通用性强,可处理任意字符但效率稍低。文章对比了两者的时间复杂度、空间复杂度和适用场景,指出数组法在小写字母场景下性能最优,而HashMap更适
本文深入解析了LeetCode 560题"和为K的子数组"的解题思路。通过前缀和技巧,将子数组求和问题转化为前缀和差值的统计问题。核心思想是:对于每个右端点r,统计其左侧满足pre[l-1]=pre[r]-k的位置数量,这些位置即构成和为k的子数组。文章详细解释了为什么需要初始化hash.put(0,1),以及为何要先更新答案再更新哈希表这两个关键细节。最终给出时间复杂度O(n
本文介绍了判断平衡二叉树的两种解法:自顶向下(O(N²))和自底向上(O(N))。第一种解法通过递归计算每个节点的高度差,但存在重复计算问题。第二种解法采用后序遍历,利用"-1"作为错误信号,在计算高度的同时判断平衡性,避免重复遍历。通过公司职级比喻生动解释了"-1"的产生和传递机制。关键点在于将高度计算与平衡判断合并,通过返回值携带额外信息,实现最优时间复
本文通过对比LeetCode 438和567两道题,揭示它们本质都是固定长度滑动窗口问题,采用计数数组和count维护有效字符数的通用解法。重点阐明了count统计的是有效字符总数而非种类数,并详细解释了"进窗口先加后判,出窗口先判后减"的操作顺序原理。通过具体反例说明顺序错误会导致bug,最后给出适用于两题的万能口诀和438题的代码实现。全文帮助读者一次性掌握这类问题的核心思
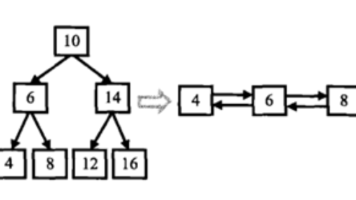
摘要:本文探讨了将二叉搜索树(BST)转换为有序双向链表的经典算法。核心思路是利用中序遍历的性质,通过递归修改节点指针实现原地转换,使用全局变量prev记录前驱节点。重点分析了代码中必须对空树单独判空的原因,防止后续查找头节点时的空指针异常。文章还比较了寻找链表头节点的不同策略,并总结了该问题考察的BST性质理解、指针操作技巧和边界条件处理能力。
本文分析了Leetcode105和106题中通过遍历序列还原二叉树的统一套路。前序+中序和后序+中序构造二叉树的核心思路是:前序/后序确定根节点,中序划分左右子树边界。关键区别在于遍历顺序:前序是"根左右",需先构建左子树;后序倒序是"根右左",必须优先构建右子树,否则会导致递归爆栈。文章通过代码示例和详细调用栈分析,解释了后序+中序情况下先构建右子树的原因
本文记录了作者在解决LeetCode 189题"轮转数组"时遇到的典型陷阱。作者最初错误地使用了ArrayList的初始化方式,误以为指定容量就能直接通过索引赋值,导致IndexOutOfBoundsException。通过分析ArrayList的容量(Capacity)与实际大小(Size)的区别,作者认识到应该改用数组实现。最终采用辅助数组法,利用(i + k) % n的取
本文讨论了在非空整数数组中找出唯一出现一次数字的两种解法。异或解法(XOR)通过位运算特性,利用a^a=0和a^0=a的性质,将所有数字异或后得到唯一数,满足O(n)时间和O(1)空间的严格条件,是最优解。HashMap解法通过统计数字出现次数也能得到结果,但需要O(n)额外空间,不满足题目要求。两种方法对比显示:异或解法更高效简洁,专为"成对抵消"场景设计;HashMap解法
本文介绍了使用HashMap实现随机链表深拷贝的标准解法。关键在于建立原节点到新节点的映射关系,通过两趟遍历:第一趟创建所有新节点并存入HashMap,第二趟根据原链表结构设置新节点的next和random指针。这种方法保证了新链表完全独立于原链表,满足深拷贝要求。时间复杂度O(n),空间复杂度O(n)。文章还指出了常见错误,并提到存在更节省空间的解法,但HashMap方案更直观可靠。该解法适用于
文章摘要 LeetCode 49题要求将字母异位词分组,关键在于为异位词构造统一标识。通过排序字符串,互为异位词的字符串会得到相同的排序结果,从而可作为哈希表的key。使用HashMap<String, List<String>>存储,key为排序后的字符串,value为对应的原字符串列表。该方法时间复杂度为O(N*KlogK),其中N是字符串数量,K是字符串平均长度。核心
摘要 本文介绍了解决旧键盘坏键识别问题的算法思路。题目要求通过比较期望输入串和实际输入串,找出所有坏键并按特定规则输出。核心解决策略包括:1) 统一转为大写字母处理;2) 使用HashSet快速判断字符是否存在;3) 通过遍历期望串顺序输出首次出现的坏键。算法时间复杂度为O(n+m),空间复杂度为O(1)。文中还分析了代码优化点,如避免重复创建Scanner对象等。该方案通过合理使用集合和遍历顺序
Boyer-Moore投票算法是解决多数元素问题的经典方法。该算法通过"成对抵消"思想,在线性时间和常数空间内找出出现次数超过n/2的元素。维护候选人和计数变量,遍历数组时进行票数增减操作。由于多数元素票数过半,最终剩下的候选人即为所求。该算法时间复杂度O(n),空间复杂度O(1),是算法面试中的必备技巧。
循环队列设计中,为避免"队列空"和"队列满"混淆,通常采用数组长度设为k+1的策略。然而,在实现Rear()方法时容易忽略一个关键问题:当队列逻辑上为空时,数组中仍可能存在物理残留的旧数据。本文通过LeetCode 622题案例指出,若未在Rear()方法中先检查队列是否为空,直接读取rear-1位置的数据,可能返回已被逻辑删除的"幽灵数据&quo
本文对比了两种堆解法求最小K个数的性能差异。代码1使用小根堆存储所有元素后弹出K次,时间复杂度O(n log n),空间O(n)。代码2维护大小为K的大根堆,仅保留候选最小K个数,时间O(n log k),空间O(k)。当K远小于N时,代码2显著更优。代码1实现简单适合K接近N的情况,代码2则是面试推荐的标准解法,通过大根堆作为"门槛"优化了复杂度。文章还讨论了边界处理、常数优
本文解析了LeetCode 236题"二叉树的最近公共祖先"的递归解法。核心思路采用后序遍历自底向上搜索:每个节点先检查是否为p/q或空节点(终止条件),然后递归搜索左右子树。根据左右子树的搜索结果判断:若两边均非空则当前节点为LCA;若仅一边非空则结果在该子树中。该方法巧妙涵盖了"一个节点是另一个祖先"的特殊情况,通过简洁的递归逻辑高效解决问题,时间复杂度
本文介绍了如何用递归判断二叉树是否对称。核心思路是将问题转化为比较左子树和右子树是否互为镜像,通过辅助函数递归比对左右子树的外侧和内侧节点。文章详细拆解了代码的终止条件(判空与判值)和递归逻辑(镜像法则),并用图解说明"外侧"和"内侧"的比对方式。该方法的时间复杂度为O(N),空间复杂度为O(H)。解题关键在于"左对右,右对左,值相等,空对空&qu
LeetCode 572题要求判断一棵树是否是另一棵树的子树。解题思路采用递归嵌套:外层递归遍历大树的每个节点,内层递归判断两棵树是否完全相同。核心函数isSameTree比较两棵树的结构和值,而isSubtree则在大树中寻找匹配的子树。该方法时间复杂度为O(N×M),空间复杂度为O(max(N,M))。这道题展示了二叉树问题的核心思想:将问题拆解为当前节点判断和左右子树递归处理。
摘要: 本文对比了两种解决「宝石与石头」问题的方法。题目要求统计 stones 中属于 jewels 的字符数量。 HashSet 解法(推荐): 时间复杂度:O(|jewels| + |stones|) 利用 HashSet.contains() 的 O(1) 成员判断特性,高效计数。 List 解法(不推荐): 时间复杂度:O(|stones| * |jewels|) ArrayList.co
本文介绍了解决多数元素问题的Boyer-Moore投票算法。该算法通过成对抵消思想,在O(n)时间复杂度和O(1)空间复杂度内找出出现次数超过n/2的元素。核心步骤是维护候选人和票数变量,遍历数组时进行票数增减操作。特别强调初学者易犯的错误:当count归零时,必须将新候选人的count设为1而非0,否则算法失效。该算法可靠的原因是多数元素票数始终无法被完全抵消,最终必会保留为候选人。掌握这一算法
本文介绍了用栈实现二叉树前序、中序和后序遍历的非递归方法。核心思路是用显式栈模拟递归调用栈,通过控制访问时机实现不同遍历顺序: 中序遍历(左-根-右):左链压栈到底后弹栈访问,再转向右子树 后序遍历(左-右-根):需要prev指针标记已处理节点,确保左右子树都完成才访问根 前序遍历(根-左-右):在压栈时就访问节点,保证根最先被处理 三种遍历的区别仅在于访问节点的时机:前序在第一次遇到时访问,中序
通过二分查找在较短的数组nums1上寻找分割点i,并根据i计算nums2的分割点j(使得左右两边元素个数满足要求)。利用四个关键值()判断分割是否合理。根据总元素个数奇偶性计算中位数。为什么必须确保nums1是较小的数组?保证二分查找时i的范围是0到m,同时能使得计算出的落在[0, n]范围内,避免数组越界。限制二分查找在较小的数组中进行,可以使搜索空间更小,算法效率更高。如果不交换,可能因j的计
本文详细解析了使用广度优先搜索(BFS)实现二叉树层序遍历的标准模板。通过队列的FIFO特性,利用size变量控制每层节点的处理顺序,确保分层输出结果。文章从核心思想、代码拆解、执行流程到复杂度分析,全面阐述了BFS在二叉树遍历中的应用。该模板不仅适用于基础层序遍历,还可轻松扩展到各种变种题目,是解决分层遍历问题的通用方法。
leetcode
——leetcode
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵
 EazyDevelop社区

 AI编程社区