登录社区云,与社区用户共同成长
邀请您加入社区
萨芬
本文深入探讨了决策树(Decision Tree)在图像分类任务中的关键技术与调优策略。通过分析高维连续特征与决策树离散化本质的冲突,提出了二值化阈值法、区间分桶策略等特征离散化技术,并详细介绍了剪枝、特征重要性过滤等优化方法。文章还分享了决策树可视化、内存优化及多尺度特征融合等实战技巧,帮助提升图像分类准确率和效率。
本文是一份统计学习实战指南,通过深度解析从线性回归到决策树的经典习题,帮助读者将理论知识转化为解决实际数据问题的能力。内容涵盖线性回归的假设、正则化、逻辑回归与SVM的推导,以及决策树分裂准则和随机森林的集成原理,旨在通过习题拆解建立统计学习的核心思维框架。
在机器学习的世界里,决策树就像一位擅长做选择题的专家,总能根据数据特征一步步做出判断。今天咱们就用大白话聊聊这个实用的算法。
摘要:本文介绍了如何使用 Python 的 scikit-learn 库实现决策树模型,涵盖分类和回归两种主要场景。在分类部分,重点讲解了数据准备、模型创建、训练、预测与评估,并指出过拟合、数据质量和特征选择等注意事项,提供了基于鸢尾花数据集的示例代码。对于回归模型,同样阐述了建模流程,并以模拟数据演示了 DecisionTreeRegressor 的应用。文章强调了剪枝、数据预处理的重要性,并展
先说说这强大的解密能力,轻松解密本地微信数据库,提取聊天记录毫无压力。以 ChatWise 为例,打开 ChatWise→设置→工具,新建工具,类型选择 sse,填写参数 {"id":"chatlog","type":"sse","url":"http://127.0.0.1:5030/sse","autoRun":true},勾选“自动执行工具”,保存即可。双击运行 chatlog,或在命令行输
把BSR3100当成纯模拟器件(或者纯数字功能芯片),由外部的MCU通过SPI接口,连接到BSR3100的SPI2AHB口上,就可以访问到BSR3100芯片内部的所有功能,这样BSR3100就是一个外部MCU系统控制的纯模拟器件。BSR3100芯片作为主控,在芯片内部或者外部,连接上NorFlash芯片,组成一个完整的SoC系统,去控制各种外部设备,也就是我们通常说的MCU Solution。实验
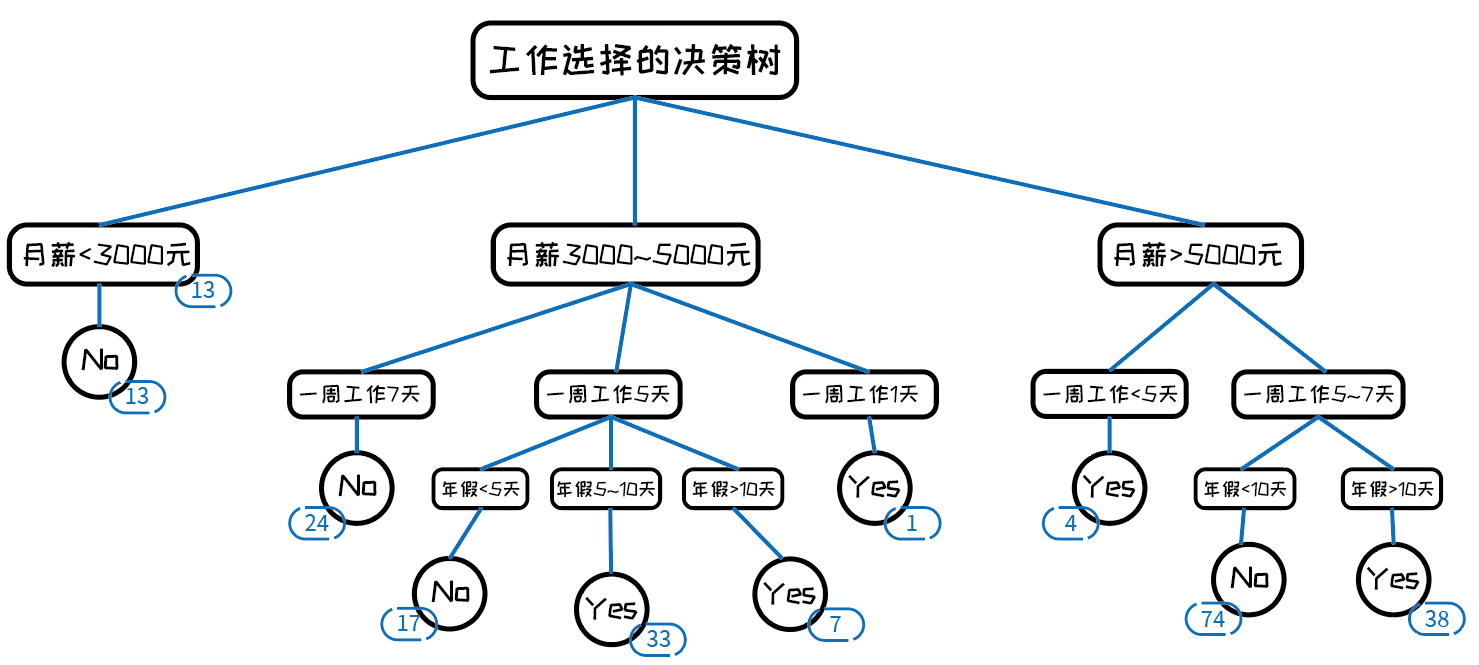
可以把它看作是一个“树”,每个节点表示一个特征的判断,而每个分支代表了可能的判断结果,最终的叶子节点表示预测结果。假设我们有一个数据集,其中包含不同动物的特征,如体重、是否有羽毛、是否会飞等,目标是判断动物是鸟还是非鸟(比如猫)。决策树就是通过这种方式来做决策的:根据每个特征(问题)的条件,将数据逐层分组,最终在树的叶子节点给出结果。每问一个问题,都会将可能的答案进一步分成不同的组,这样你最终会根
为学习机器学习算法——决策树而做的笔记
回归分析是一种统计方法,用于探索自变量(预测变量)和因变量(目标变量)之间的关系。它可以帮助预测变量的变化对目标变量的影响大小。例如,简单线性回归用于分析两个变量之间的线性关系,而多元回归分析可以处理多个自变量的情况。
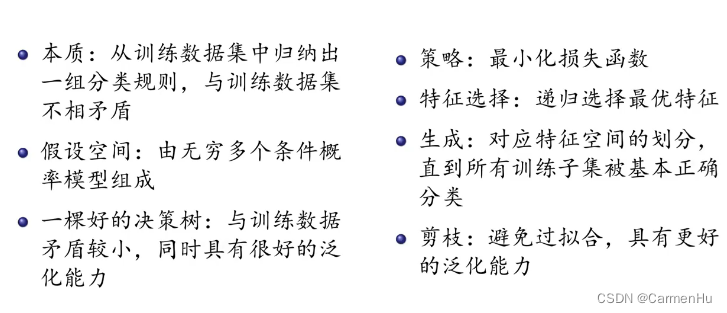
决策树易于理解和解释,但可能会因为选择的特征和树的结构导致过拟合或欠拟合。现代的决策树算法,如ID3、C4.5、CART和随机森林,都包含优化策略来提高性能和稳定性。
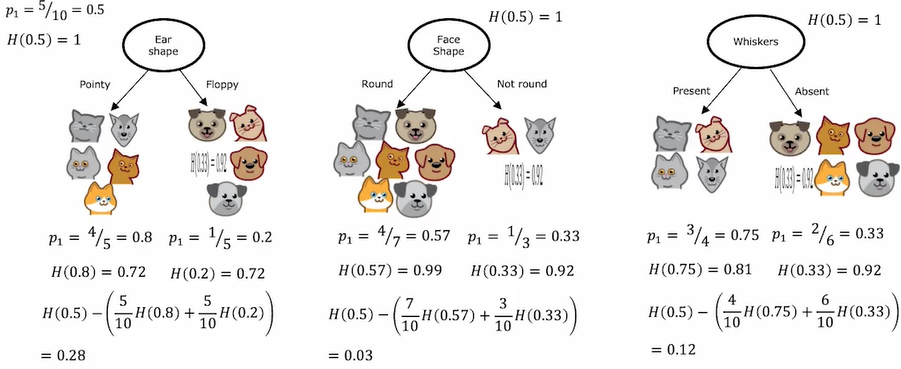
ID3算法中,选择的是信息增益来进行特征选择,信息增益大的特征优先选择。基尼指数的意义是从数据集D中随机抽取两个样本类别标识不一致的概率。基尼指数越小,数据集的纯度越高。相比于信息增益,信息增益比等作为特征选择方法,基尼指数省略了对数计算,运算量比较小,也比较容易理解,所以CART树选择使用基尼系数用来做特征选择。在这个模型中用ID3算出的准确率比基尼指数的高一些。
决策树(Decision Tree)是一种决策分析方法,它基于已知的各种情况发生概率来构建,旨在求取净现值的期望值大于等于零的概率,进而评价项目风险并判断其可行性。这种方法以图形的方式直观运用概率分析,由于决策分支的图形表现类似于树的枝干,因此得名决策树。在机器学习中,决策树是一个预测模型,它代表对象属性与对象值之间的一种映射关系。决策树是一种树形结构,其中每个内部节点表示一个属性上的测试,每个分
一、决策树:分类决策树模型是一种描述实例进行分类的树形结构。
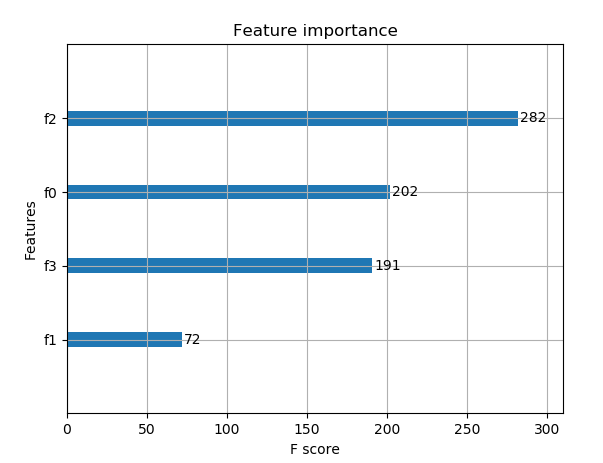
利用一些有用的属性来总结树的工作原理,其中最常用的事特征重要性,它为每个特征树的决策的重要性进行排序。对于每个特征来说,它都是介于0到1之间的数字,其中0代表“根本没有用到”,1代表“完美预测目标值”。特征重要性的求和为1。
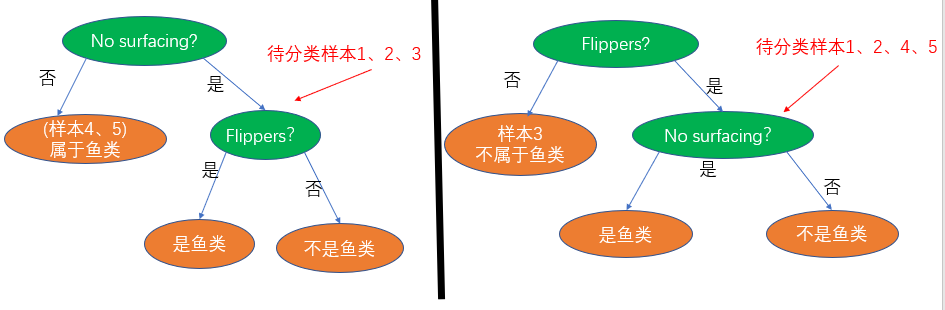
此参数指示pandas应该从CSV文件的第一行推断列名。换句话说,CSV文件的第一行被视为包含列名的标题。这段代码对data中的'Class'列进行了替换操作。具体来说,它使用replace方法将'fishes'、'birds'、'amphibians'和'reptiles'这些值替换为'non-mammals'。这意味着将这些类别中的动物都重新分类为非哺乳动物。使用 Pandas交叉表 来检查“
分类决策树模型是一种描述对实例进行分类的树形结构。决策树由结点和有向边组成。结点有两种类型:内部结点和叶节点。内部结点表示一个特征或属性,叶节点表示一个类。●熵可以表示一个系统的混乱程度,系统越混乱,熵值越高;反之,熵值越低。●1948年香农提出了”信息熵(Entropy)“的概念。●假设在当前的样本集合D中第k类样本所占的比例为pk(k=1,2,3,......,n),,D表示样本的所有数量,为
本文介绍了使用Python的scikit-learn库构建性别分类决策树模型的示例代码。通过身高和胡子特征数据训练模型,并预测新样本的性别分类(如158cm无胡子预测为女性,176cm有胡子预测为男性)。文章还提供了Markdown编辑器的使用指南,包括基础语法、功能快捷键、标题创建、文本样式、链接图片插入、代码高亮、表格制作等排版技巧。最后分享了论文写作/Python学习智能体的在线资源链接。
全文链接:http://tecdat.cn/?p=31745近几年来,各家商业银行陆续推出多种贷款业务,如何识别贷款违约因素已经成为各家商业银行健康有序发展贷款业务的关键(点击文末“阅读原文”获取完整数据)。相关视频在贷款违约预测的数据(查看文末了解数据免费获取方式)的基础上,探索是否能通过借贷者的数据判断其违约风险,从而帮助商业银行提前做好应对。解决方案任务/目标根据借款者的个人信息和贷款的属性
决策树机器学习使用场景分类、回归、仿真优化、量化求解、时间序列预测问题监督机器学习给定目标学习,房价预测,信用卡欺诈检测。
本节将以例子为主,详细介绍生成决策树的原理部分,代码将不做重点介绍。
Xgboost是Boosting算法的其中一种,Boosting算法的思想是将许多弱分类器集成在一起,形成一个强分类器。因为Xgboost是一种提升树模型,所以它是将许多树模型集成在一起,形成一个很强的分类器。而所用到的树模型则是CART回归树模型。Xgboost是在GBDT的基础上进行改进,使之更强大,适用于更大范围。Xgboost一般和sklearn一起使用,但是由于sklearn中没有集成X
决策树、随机森林等估计器
建立选择合适的决策树提高算法效果。
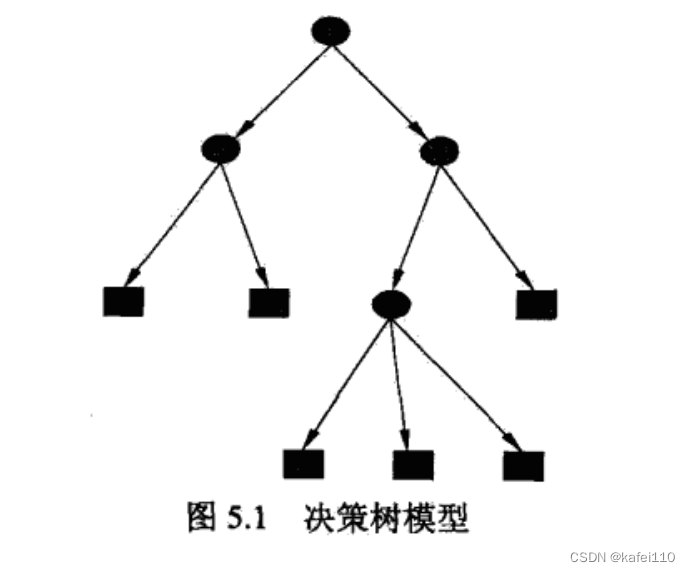
1、决策树是一个树结构(可以二叉或非二叉),每一个非叶子节点表示一个特征属性的测试,每一个分支代表这个特征属性在某个值域上的输出,叶节点存放类别。2、决策过程:从根节点开始,测试待分类项中相应的特征属性,并按照其值选择输出分支,直到达到叶子节点,叶子节点存放的类别作为决策结果。
简单来说决策树就是一棵树,一颗决策树包含一个根节点、若干个内部结点和若干个叶结点,叶结点就是问题的决策结果。也就是说一棵树包括根节点、父节点、子节点、叶子节点。子节点由父节点分裂出来,然后子节点作为新的父节点继续分裂,直到得出最终结果。优点:易于理解和解释,决策树分类很快,可以处理不相关特征数据。缺点: 对缺失数据的数据集处理困难。它构建过程是一个递归的过程,需要确定停止条件,否则过程将不会结束。
可以看到,该文件大小为61878*95,其中最后一列为目标标签;其中还发现该文件数据没有缺失值和重复值。最后一列是object类型,这里采用字典编码进行转换。相关可视化效果展示如下。
决策树算法可以应用于分类问题与回归问题,李航的书中主要讲解的是分类树,构建决策树分为三个过程,分别是特征选择、决策树生成、决策树剪枝以及CART算法。
数据挖掘期末复习
决策树基础知识:从信息熵决策熵到信息增益、信息增益率、基尼系数,到两种剪枝处理和随机森林,生动易懂配有自制插图
注:本篇博客参考 b站:机器学习经典算法(2)——决策树与随机森林文章目录一、熵与基尼系数二、决策树构造实例三、信息增益(ID3算法)四、信息增益率(C4.5算法)五、二分选值六、决策树减枝七、随机森林决策树有三种算法:一、熵与基尼系数熵:一件事情的混乱程度如果一个集合内部的属性很多,混乱程度就很大,则熵值也较大如果一个集合内部的属性很少,混乱程度就很小,则熵值也较小基尼系数和熵在公式上面不同,但
人们观测或者收集到的数据样本是高维的,但与学习任务密切相关的也许仅仅是某个低维分布,即高维空间中的一个低维“嵌入”。且在高维情形下出现的数据样本稀疏、距离计算困难等问题是所有机器学习方法共同面临的严重障碍,因此特征工程的目的是最大限度地从原始数据中提取特征以供算法和模型使用。不仅减少过拟合、减少特征数量(降维)、提高模型泛化能力,而且还可以使模型获得更好的解释性,增强对特征和特征值之间的理解,加快
亲爱的朋友,本次我们开始学习决策树,为了让大家对这个算法有一个系统清晰的认识,这篇博文侧重于对算法整体流程以及算法核心部分进行阐述。决策树算法整体流程大致都一样,不同的是在特征选择时,特征选择策略不同,这篇博文以ID3算法进行特征选择来学习决策。如果你已掌握决策树算法整个工作流程,想要详细学习其他特征选择策略,推荐学习资料 《统计学习方法》(李航著)话不多说,进入正题!算法简介决策树算法,是有监督
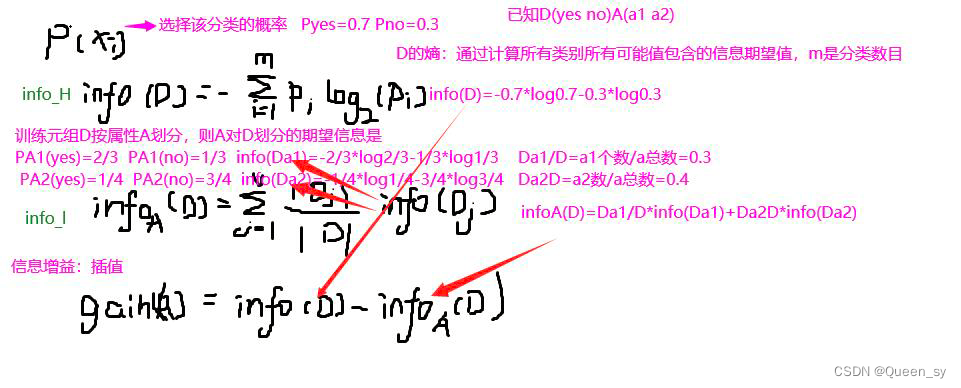
开始入门机器学习有关知识,在这里发文的目的一是来记录主要的知识点,二是熟悉一下CSDN的发文操作,方便后续的更新。信息增益:熵(entropy):是表示随机变量不确定性的度量。设X是一个取有限个值的离散随机变量,其概率分布为:则随机变量X的熵定义为:熵越大,随机变量的不确定性越大。条件熵H(Y|X)表示在已知随机变量X的条件下随机变量Y的不确定性。随机变量X给定的条件下随机变量Y的条件熵(cond
风控数据挖掘方法(决策树规则挖掘)import pandas as pdimport numpy as npdata = pd.read_excel("/Users/zhucan/Desktop/金融风控实战/第二课/oil_data_for_tree.xlsx")data.head()结果:set(data.class_new)#{'A', 'B', 'C', 'D', 'E', 'F'}#or
实现信息增益、信息增益率、基尼指数三种划分标准使用给定的训练集完成三种决策树的训练过程计算三种决策树在最大深度为10时在训练集和测试集上的精度,查准率,查全率,F1值
盛夏已至,又到了各种内推和招聘贴满天飞的季节,拖延了好久,终于抽出时间分享面经。本篇分享机器学习相关的面试经验,我在秋招中投递的大多数是推荐算法岗,真正机器学习岗的面试其实并不多,但准备过...
机器学习是一门多领域交叉学科,涉及概率论、统计学、逼近论、凸分析、算法复杂度理论等多门学科。专门研究计算机怎样模拟或实现人类的学习行为,以获取新的知识或技能,重新组织已有的知识结构使之不断改善自身的性能。文章目录1. 定义2. 机器学习原理3. 机器学习的分类3.1 基于学习策略的分类3.2 基于学习方法的分类3.3 基于学习方式的分类3.4 基于数据形式的分类3.5 基于学习目标的分类4. 常见
第 4 章 决策树4.1 算法原理:从逻辑角度,一堆if else语句的组合从几何角度,根据某种准则划分特征空间。最终目的:将样本越分越“纯”信息论内容补充:信息熵自信息的期望,随机变量的不确定性的度量此时的信息熵所代表的“不确定性”可以理解为集合内样本的“纯度”。条件熵Y的信息关于概率分布X的期望信息增益信息熵-条件熵最大化信息增益。通过遍历A中所有属性,求出每个属性所有可能取值下的信息熵,计算
数学建模_随机森林分类模型详解Python代码随机森林需要调整的参数有:(1)决策树的个数(2)特征属性的个数(3)递归次数(即决策树的深度)'''from numpy import inffrom numpy import zerosimport numpy as npfrom sklearn.model_selection import train_test_split#生成数据集。数据集包括
决策树的相关介绍可以先看看这篇统计学习(三)决策树ID3、C4.5、CART。这里做一下使用sklearn直接导入决策树模型进行分类问题,回归问题的解决演示。关于sklearn中封装的决策树模型的详细参数可以看这篇文章SKlearn中分类决策树的重要参数详解。下面的示例所有数据和代码看这里。如果对你的学习有所帮助欢迎点star,谢谢~一、分类问题这里同样的,我们还是使用手写数字集进行分类问题演示。
1)导入包和数据(来自sklearn)%matplotlib inline# 如果不是jupyter notebook 可无视import matplotlib.pyplot as pltimport pandas as pdfrom sklearn.datasets.california_housing import fetch_california_housing2)查看数据描述housing
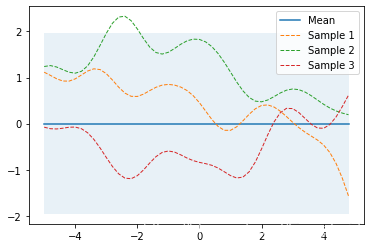
机器学习小结前言决策树熵熵的性质非参数概率密度统计模型HistogramParzen KernelNadaraya-Watson高斯过程算法目的算法理论要点实验附:高斯函数的基本性质前言本文旨在整理一些博主学习中零散的知识点。决策树熵熵最好理解为不确定性的量度而不是确定性的量度,因为越随机的信源的熵越大。H(p)=−∑k=1npklog2pkH(p) = -\sum_{k=1}^np_klog_2
ID3/C4.5算法分类决策树import numpy as npimport mathclass Node:def __init__(self,feature_index=None,value=None,label=None):self.feature_index=feature_indexself.value=valueself.child=[]self.label=labelclass C4
文章目录1.信息增益1.信息熵2.条件熵3.信息增益2. 信息增益比3.决策树的构建1.ID3算法2.C4.5算法4.决策树的剪枝5.CART算法1.信息增益1.信息熵熵交叉熵KL散度均匀分布时,熵最大,不确定性最大2.条件熵P733.信息增益信息增益的概念:表示得知特征X的信息而使得类Y的信息的不确定性减少的程度,倾向与选择取值较多的特征2. 信息增益比3.决策树的构建1.ID3算法2.C4.5
实验内容:使用ID3算法设计实现决策树,使用uci数据集中的Caesarian Section Classification Dataset Data Set数据进行分类获取数据集:https://archive.ics.uci.edu/ml/datasets/Caesarian+Section+Classification+Dataset数据集:@attribute ‘Age’ { 22,26,
信息熵、信息增益、基尼系数、决策树、随机森林的生成、性能、作用。
决策树5.1 决策树模型与学习5.2 特征选择5.2.1 信息增益5.1 决策树模型与学习分类决策树模型是一种描述对实例进行分类得树形结构。内部节点表示一个特征或属性,叶子节点表示一个类。路径上内部节点的特征对应着规则的结论,而叶节点的类对应着规则的结论。决策树的路径具有一个重要的性质:互斥并且完备,每一个实例都被一条路径或一条规则所覆盖,且只被一条路径或一条规则所覆盖。决策树与条件概率决策树还可
随机森林随机森林是集成学习分(Ensemble Learning)中的一种。随机森林主要体现在‘随机’和‘森林’上。0.。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。.。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。.。。。。。。。。。。。。。。。。。。。。。。。。。。。。
决策树
——决策树
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 天工造物局

 DAMO开发者矩阵