登录社区云,与社区用户共同成长
邀请您加入社区
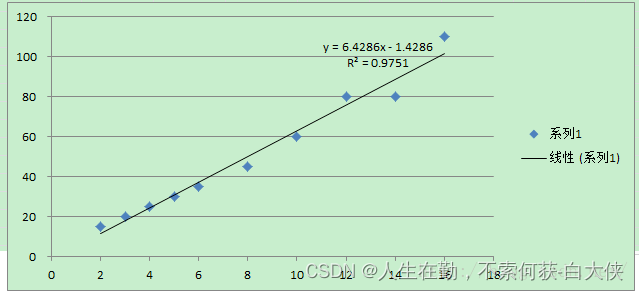
本文详细介绍了利用Excel对NTC 10K温度传感器进行分段线性回归分析,以解决其非线性特性在Arduino等嵌入式系统中直接处理精度低、效率差的问题。通过Excel构建理论模型、执行数据拟合,并将优化后的系数高效移植到C程序中,结合二分查找算法和单点校准,最终实现高精度、低资源占用的温度测量方案。
本文详细介绍了如何利用Excel进行数据处理和线性回归分析,为NTC 10K温度传感器生成分段线性拟合系数,并结合Arduino C程序实现高效、精准的温度测量。该方法通过PC端计算与嵌入式端查表插值的结合,有效解决了在资源有限的微控制器上处理非线性传感器的难题,适用于物联网、环境监测等多种场景。
首先来看看看一元线性回归方程式,了解求a,b的公式,求误差的平方的和就是求上图中所有蓝色点到对应直线的距离的平方和。假设一组数据是价格和供给量的关系。一元线性回归是通过拟合一条直线 来研究两个变量之间的关系,从而实现预测。1、将数据导入到oracle中并。
作为一个21世纪的开发工作者,对算法和数据结构的学习现在已经越来越重要了,所以我想将自己对算法和数据结构的一些理解和认识总结出来,让各位读者进行指正。这个总结我准备分为三部分:基础课、进阶课和练习课。从简单到困难将自己关于这方面的知识展现出来。一.认识复杂度我们学习算法就是为了提升代码的执行效率,但是实现同一功能的算法有那么多,如何区分区分各种算法的优劣呢?主要指标有:1.时间复杂度(流程决定)既
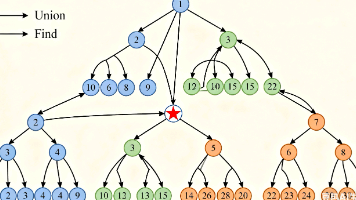
并查集是一种高效处理 “动态连通性” 问题的数据结构,核心用于解决元素分组、判断元素是否同属一个集合,以及合并不同集合三大场景,在最小生成树、亲戚关系判定、岛屿数量统计等问题中应用广泛。本文从基础原理切入,拆解关键优化策略,结合典型例题测试并查集的效率差异,帮读者快速掌握这一 “高效分组工具” 的使用逻辑与场景适配。
作者:დ旧言~> 座右铭:松树千年终是朽,槿花一日自为荣。> 目标:了解什么是深搜,并且掌握深搜算法。> 毒鸡汤:有些事情,总是不明白,所以我不会坚持。早安!
即使没有深厚的编程背景的人,也可以通过低代码平台的可视化界面和简单的操作,利用 AI 接口提供的智能功能,开发出满足自己需求的应用程序。例如,在教育领域,开发人员可以利用低代码平台集成的 AI 接口,开发出个性化的学习助手,根据学生的学习情况和特点,为学生提供定制化的学习建议和资源。还有可能出现 “识别失败,请检查配置重新尝试” 的情况,原因可能是 ApiKey、SecretKey 配置错误,上传
本文分享了作者参加第十七届蓝桥杯Python B组省赛的解题思路和代码实现。文章依次分析了7道赛题,包括: 和平干饭日(模运算枚举) 干涉条纹(数学推导与区间计算) 定制展示盘(合数判断) 密室逃脱(数论与线性方程组) 奇偶博弈(奇偶性分析) 蓝小圈(带权并查集) 星光共鸣(动态规划) 位数求和(单调栈与几何计数) 每道题都给出了核心算法思路和Python代码实现,其中涉及模运算、数论分解、动态规
7 大章节、61 个交互式可视化(图3),快排、AVL、Dijkstra、KMP……每个算法都能逐步播放执行过程,指针怎么动、元素怎么交换、结构怎么变,全部用动画演给你看。考研、求职、工作,三个阶段都梳理了一次数据结构和算法,每一次都有新的收获。第三次梳理的时候就做了这个网站。把 408 考纲全部知识点整理成了一张交互式学习路线图,点任意节点直接弹出讲解,顺着走就行。不是你笨,是人脑本来就跑不动算
本文详细介绍了使用线性回归模型预测波士顿房价的完整技术流程,涵盖数据清洗、可视化分析、特征工程和模型优化等关键步骤。通过Python、Pandas和Matplotlib等工具,展示了如何从原始数据中提取有价值的信息,构建高性能预测模型,并提供了实用的优化建议和常见陷阱规避方法。
在C#开发领域,单元测试是确保代码质量和功能正确性的关键环节。目前存在多种成熟的单元测试框架,每种框架都具有独特的设计哲学和适用场景。这些框架主要旨在帮助开发者编写、组织和运行测试代码,通过自动化验证程序单元的行为是否符合预期。常见的框架包括Microsoft官方的MSTest、流行的开源框架NUnit以及功能强大的xUnit.net。这些框架都集成了现代开发工具链,与Visual Studio等
衡量两个向量方向的一致性,反映线性拟合的质量。项目描述优点- 不依赖深度学习框架- 可解释性强- 计算开销小- 可用于边缘设备局限- 表达能力有限- 无法捕捉高频语义- 对噪声敏感适用场景- 音频分类初筛- 异常声音检测- 教学演示- 低资源环境下的特征提取本文提出了一种新颖而直观的方式,将音频信号通过线性动力学建模 + 特征量化的方式转换为离散序列。是否可以用更简单的方法逼近复杂模型的部分能力?
例如,{2,3,1,5,4} 是一个长度为 5 的排列,而 {1,2,2} 和 {1,3,4} 都不是排列,因为前者存在重复元素,后者包含了超出范围的数。例如,{2,3,1,5,4} 是一个长度为 5 的排列,而 {1,2,2} 和 都不是排列,因为前者存在重复元素,后者包含了超出范围的数。解题思路:由于陷阱只有一个, 从(1,1) 到 (n,m), 特殊情况一种是往右n-1步, 往下走m-1步,
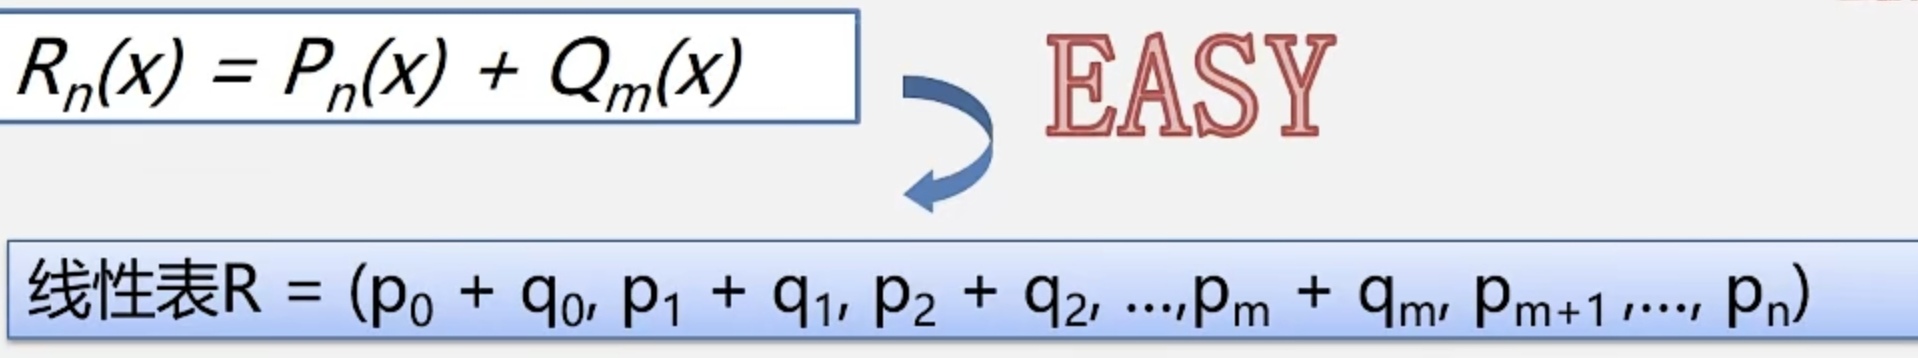
定义线性表(Linear List)是由n(n>=0)个具有相同特性的数据元素(结点)a1,a2,…an组成的有限序列。线性起点也称首元如果这个线性表没有元素,即n=0时为空表。统一线性表中的元素必定具有相同的特性,数据元素间的关系是线性关系。线性表的例子【例1】分析26个英文字母组成的英文标:(A,B,C,D,……,Z)数据元素都是字母;元素间关系是线性。【例2】分析学生情况登记表外链图片转存失
KMP算法(Knuth-Morris-Pratt算法)是一种用于查找字符串中是否存在某个模式的算法,时间复杂度为O(m+n),其中m是模式串的长度,n是文本串的长度。该算法是由Knuth、Morris和Pratt三人于1977年共同提出的,它利用了模式串的前缀信息来避免无效的匹配,从而提高匹配效率。KMP算法的核心思想是,当模式串中的某个字符与文本串中的某个字符不匹配时,能够利用模式串的前缀信息快
按照桶排序思路进行预处理:保证 1 出现在 nums[0] 的位置上,2 出现在 nums[1] 的位置上,…例如样例预处理后的数组 [1,-1,3,4] 中第一个 nums[i]!遍历 nums,找到第一个不在应在位置上的 [1, n] 的数。例如样例中 [3,4,-1,1] 将会被预处理成 [1,-1,3,4]。令数组长度为 n,那么答案必然在 [1, n + 1] 范围内。输入:nums =
循环队列(详解)--->数据结构(队列)
一.线性回归 线性回归是利用数理统计中回归分析,来确定两种或两种以上变量间相互依赖的定量关系的一种统计分析方法,运用十分广泛。其表达形式为y = w’x+e,e为误差服从均值为0的正态分布。回归分析中,只包括一个自变量和一个因变量,且二者的关系可用一条直线近似表示,这种回归分析称为一元线性回归分析。如果回归分析中包括两个或两个以上的自变量,且因变量和自变量之间是线性关系,..
线性回归是数据分析与预测建模中最基础且核心的统计方法,它通过建立因变量与一个或多个自变量之间的线性关系模型,来量化变量间的关联并做出预测。其原理基于最小二乘法,旨在找到一条最佳拟合直线,使预测值与实际观测值之间的残差平方和最小。在技术价值上,线性回归不仅提供了清晰的系数解释(如“广告投入每增加1万元,销售额平均提升X元”),还能作为评估更复杂模型性能的基准。在应用场景中,它广泛用于销量预测、用户价
本文系统介绍了一元线性回归的核心内容,分为两大部分: 变量关系度量:阐述函数关系与相关关系的区别,重点讲解Pearson相关系数的定义公式、等价计算式及其推导过程,包括相关系数的性质、判断标准和假设检验方法(t检验统计量的推导)。 一元线性回归模型:建立总体回归模型,详细推导最小二乘估计量β̂₀和β̂₁的计算过程,验证其二阶条件,并证明回归系数估计的无偏性。文中包含完整的数学推导步骤,如目标函数求
一元线性回归摘要 一元线性回归研究两个变量的线性关系,包括变量间关系度量和回归模型建立。相关系数r(-1≤r≤1)衡量线性相关强度,通过t检验判断显著性。回归模型Y=β₀+β₁X+ε中,采用最小二乘法估计参数:β₁̂=Lxy/Lxx,β₀̂=Ȳ-β₁̂X̄。估计量具有无偏性,β₁̂和β₀̂分别是β₁和β₀的无偏估计。回归分析包括参数估计、显著性检验(t检验)和拟合优度评估(R²),广泛应用于预测和
机器学习算法是人工智能领域的核心技术,其核心原理是通过数据驱动的方式自动发现规律。从数学角度看,算法本质上是优化问题的求解过程,如线性回归通过最小化残差平方和求解最优参数。在实际工程中,理解算法设计思想比记忆公式更重要,例如决策树的分裂准则体现了信息增益的优化思想。典型应用场景包括金融风控(GBDT)、计算机视觉(CNN)和自然语言处理(LSTM)。本文通过线性回归的几何解释、随机森林的双重随机性
本文是一份统计学习实战指南,通过深度解析从线性回归到决策树的经典习题,帮助读者将理论知识转化为解决实际数据问题的能力。内容涵盖线性回归的假设、正则化、逻辑回归与SVM的推导,以及决策树分裂准则和随机森林的集成原理,旨在通过习题拆解建立统计学习的核心思维框架。
控制预测类问题
摘要:本文介绍了如何使用 Python 的 scikit-learn 库实现决策树模型,涵盖分类和回归两种主要场景。在分类部分,重点讲解了数据准备、模型创建、训练、预测与评估,并指出过拟合、数据质量和特征选择等注意事项,提供了基于鸢尾花数据集的示例代码。对于回归模型,同样阐述了建模流程,并以模拟数据演示了 DecisionTreeRegressor 的应用。文章强调了剪枝、数据预处理的重要性,并展
本文研究了机器学习算法在股票市场分析中的应用,重点探讨了基于线性回归的股票趋势预测方法。通过Python的Pandas和Scikit-learn库进行数据采集、清洗和预处理,比较了线性回归、决策树、随机森林等算法的预测性能,发现神经网络和随机森林表现较优。系统实现了数据采集、分析与可视化功能,提供用户友好的GUI界面,通过K线图等可视化方式辅助投资决策。研究表明机器学习与金融知识结合可提高股票分析
本文详细对比了Excel中实现线性回归的两种核心方法:一键生成与手动计算。通过从绘制专业散点图开始,到解读回归结果与诊断图,指导读者掌握一元及多元线性回归的完整流程。重点在于理解模型背后的原理,避免常见陷阱,并学会根据场景选择高效或深入的分析路径,提升数据分析的准确性与洞察力。
1 变量间关系的度量1 变量间关系的度量1.1 变量间的关系相关关系农作物产量施肥量函数关系y 完全依赖于 x1.2 相关关系的描述和测度相关分析就是对两个变量线性关系是否存在关系怎样的关系关系强度能否代表总体为了解决上述的四个问题,我们给出以下2个假定线性关系随机变量方法一:绘制散点图方法二:相关系数:相关系数是根据样本数据计算的,用来度量两个变量之间线性关系的一种。总体全部数据总体相关系数样本
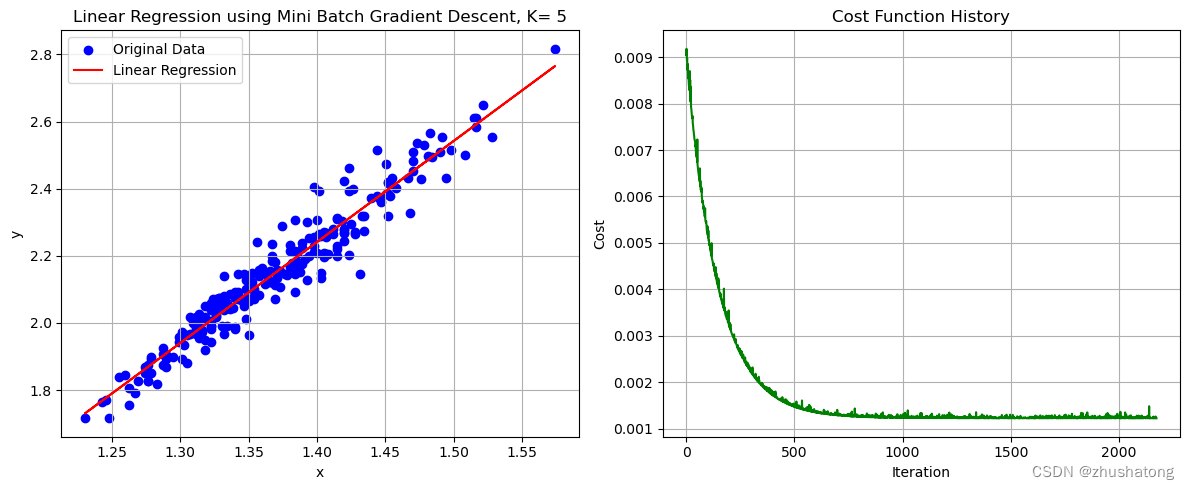
在一元线性回归中,模型是一个线性函数,其形式通常为 y=wx+b,其中 y 是预 测值,x 是输入输入特征(自变量),w 是权重(系数),b 是偏置项(截距)。主要实现了一个简单的线性回归模型,通过批量梯度下降(Batch Gradient Descent, BDG)算法来拟合一个大致为 y = 0.7x + 12 的线性关系,并绘制了原始数据点和拟合的直线。它通过对损失函数求导并令其为零,来找到
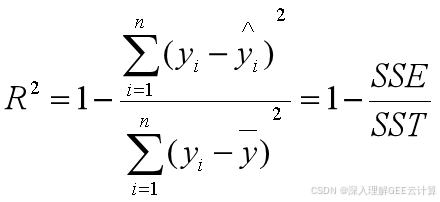
本文将详细介绍在GEE中如何计算SST、SSR、MSE、RMSE、R2、皮尔逊相关系数等回归评价指标。
欠拟合和过拟合是机器学习模型训练中的两个重要概念,它们涉及到模型在拟合数据时的表现。下面是对这两个概念的详细概述。
统计学习是一套以复杂数据建模和数据理解为目的的工具集,是近期才发展起来的统计学的一个新领域,它与计算机科学特别是其中的机器学习相互融合、协同发展。统计学习领域涵盖了许多方法,比如说 lasso 回归、稀疏回归、分类和回归树、提升法和支持向量机。
线性回归原理和分析
回归之所以能预测,是因为它通过大量的花瓣长度与宽度数据,“弄懂了”花瓣长度与宽度之间的线性关系,在这个基础之上就可以通过花瓣长度预测花瓣宽度了。通过鸢尾花的花瓣长度与宽度的线性关系来预测花瓣宽度,通过杯子里水的体积就可以知道(预测)水的重量。但是也并非所有“越…”都是线性的,比如“弹簧的弹力与位移的关系”。回归的目的是为了预测,比如在通过鸢尾花花瓣长度预测花瓣宽度。○①若不填或者填0,每次生成的数
从一维搜索问题到非线性方程求解的各种优化算法,包括黄金分割法、线性规划、梯度下降法、拉格朗日乘数法、二次规划、混合整数线性规划、多目标规划、极大最小化、半无限优化、线性最小二乘法和牛顿法等。
线性回归是机器学习中最基础也是最经典的算法之一,尤其在监督学习的背景下,它被用来解决回归问题,即预测一个连续数值的结果。
提交时请在文件名称前加上你的名字。
PaddleTS是基于飞桨深度学习框架PaddlePaddle开发的时序模型库。它提供了丰富的时序分析模型,包括预测、表征、异常检测和分类模型,适用于多种时序数据的分析和应用。通过这些模块,PaddleTS为用户提供了一个完整的时序数据分析解决方案。学生们可以根据不同的应用需求选择相应的模型模块,快速构建并部署时序预测、表征、异常检测和分类模型。
R平方的替代方案称为调整后的R平方,它会惩罚模型的复杂性(控制过度拟合),但它通常会使复杂性不足。R平方是解释的方差的比例,意味着由模型解释的观察数据中的方差比例,或者在空模型上的误差减少。可以看到蓝线解释了数据中的一些方差(R平方= 0.54),绿线解释了更多的方差(R平方= 0.64),红线更符合训练数据( R平方= 0.66)。正确答案是高偏差/低差异。Statsmodels计算我们的模型系
Coursera课程 吴恩达机器学习 第1课 :机器学习入门(监督机器学习、回归和分类)
回归算法系列笔记
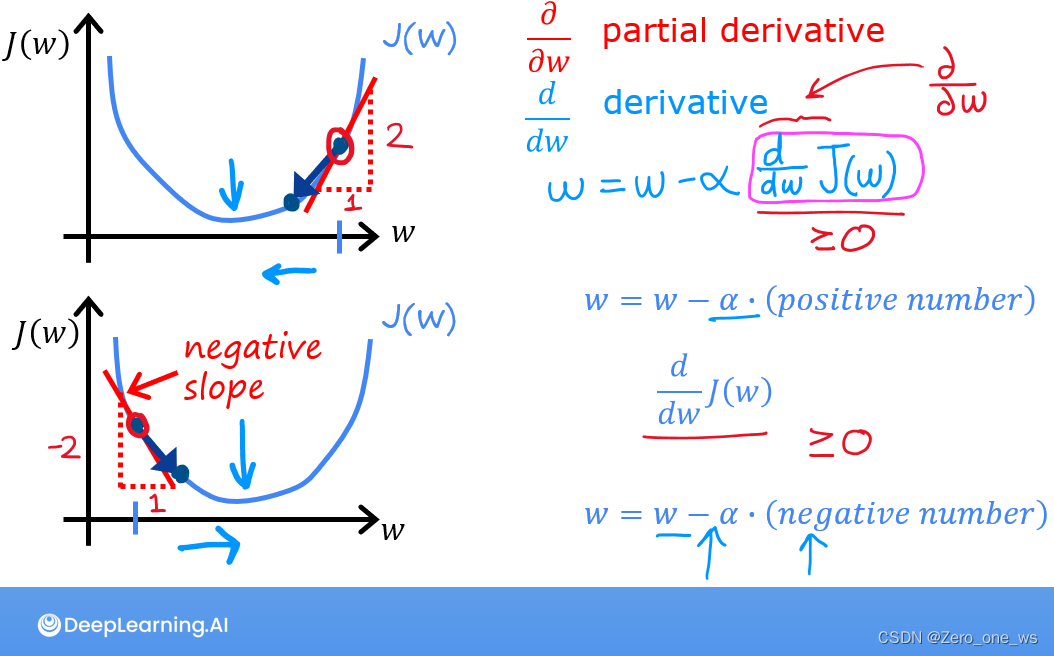
目前接触到的梯度下降是批量梯度下降,表示每次计算梯度,我们都会包括所有的训练样本。其它类型的梯度下降可能计算部分训练样本。我们需要设置迭代次数来进行梯度下降,先写好计算梯度也就是计算导数项的函数,然后循环迭代次数来不断计算梯度并更新梯度,同时也保存好每次更新的w,b。通过二维关系图和等高线图,我们看到梯度下降一开始可以大幅度降低成本函数,随着迭代次数提升,更新的幅度慢慢减少。而如果学习率设置过大,
线性模型我们主要讲解几个经典的线性模型线性模型很大程度上是非线性网络,深度学习的基础~主要有三个内容1 线性回归(又分为一元线性回归和多元线性回归)2 对数几率回归(也称为逻辑回归)3 线性判别分析。
促进企业绿色转型是中国实现高质量发展的重要路径。outreg2 using 竞争、环境和污染.doc,append bdec(3) sdec(3) ctitle(TFP_LP) e(r2_a,F)addtext(Firm FE, YES,Year FE, YES)outreg2 using 竞争、环境和污染.doc,append bdec(3) sdec(3) ctitle(TFP_LP) e(r
这个项目不是关于使用现成的库,而是对驱动线性回归的核心原则的一次探索。我们从基础数学开始,逐步构建出一个功能完善的线性回归模型。这种实践方法专为那些希望深入理解机器学习中最基本算法之一的复杂性的学习者和爱好者设计。深入体验前所未有的线性回归!
(详细描述数据集:如特征属性名称及意义、记录数等)(写出项目中涉及的主要算法原理及模型评价方法)
'g' 是表示绿色'b--o'是表示蓝色/虚线/o标记'c*'是表示蓝绿色(cyan)/*标记‘MakerIndices',1:5:length(y) 每五个点取点(设置标记密度)
带源码,可靠绝对可以运行
统计学 一元线性回归的相关内容,包括:一元线性回归模型的估计、判优和显著性检验、利用回归模型进行预测以及残差分析
线性回归
——线性回归
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区




 天工造物局






 DAMO开发者矩阵