- @m0_72274883


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文系统介绍了因子分析的原理、SPSS操作步骤及结果解读要点。因子分析是一种多元统计方法,通过数学模型X=AF+ε从观测变量中提取潜在因子,实现数据降维、结构探索和综合指标构建。实施前需满足变量相关性(KMO>0.6)、足够样本量(n≥100)等条件。SPSS操作包括变量设置、KMO检验、主成分抽取(特征值>1)、最大方差法旋转等步骤。关键结果解读涉及KMO值、共同度、方差贡献率(&g
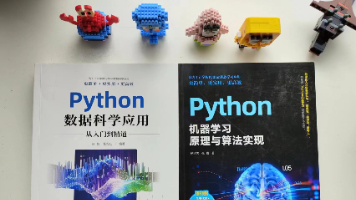
在数字化浪潮下,掌握Python已成为一项关键技能。然而,传统学习方式常因脱离实际场景,导致学习者陷入“学不会、用不上”的困境。破解此局面的关键,在于以解决真实问题为导向。数据科学正是Python学以致用的黄金领域,其应用已深入商业分析的方方面面,从客户洞察到风险预测,价值巨大。本文推荐了两本经典书目,不囿于语法细节,而是独创“原理-案例-代码-解读”四位一体的教学模式,是真正能让读者看懂、学会、
从众多特征中选择强相关特征,排除弱相关特征及冗余特征的过程,就是特征选择(Feature Selection)。
本文介绍了机器学习的核心概念和实战应用,适合零基础学习者。主要内容包括:1)机器学习基本概念,如监督学习、无监督学习和强化学习;2)4个实战案例,涵盖分类、预测、图像识别和工业应用;3)推荐Python工具库如Pandas、Scikit-learn;4)学习路径建议,从入门到进阶;5)推荐两本注重实践、弱化数学推导的权威书籍;6)实用避坑指南,强调数据质量和模型可解释性。通过案例驱动的方式,即使数

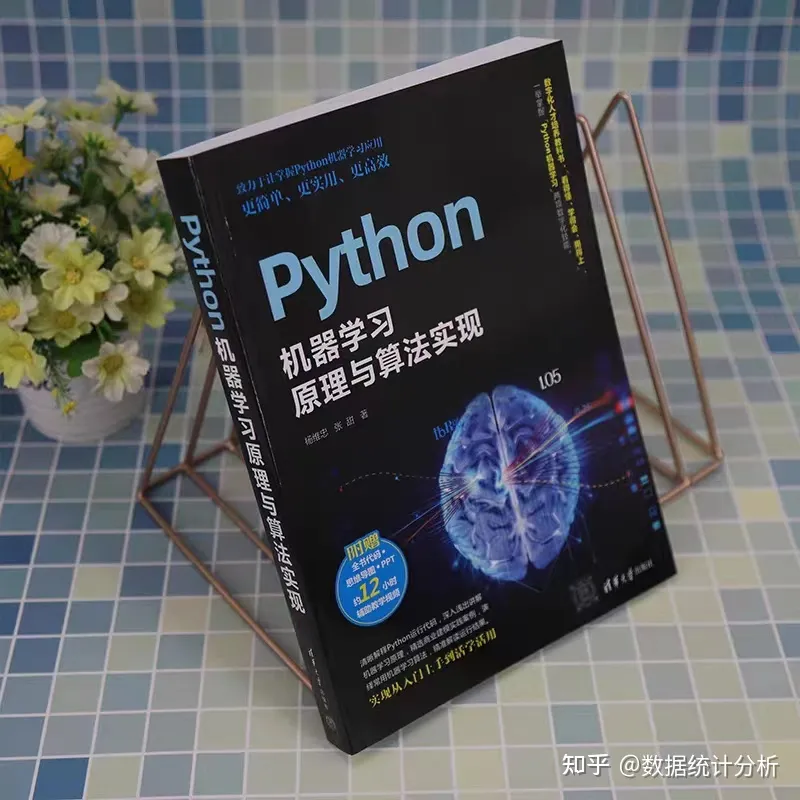
决策树是一种基于树状结构的监督学习算法,适用于分类和回归任务。其核心优势在于规则可解释性、混合数据处理能力及快速原型开发,广泛应用于金融风控、医疗诊断、电商运营等领域。算法通过递归划分特征(如信息增益、基尼指数)构建决策路径,支持预剪枝和后剪枝优化。Python实现示例展示了从数据准备到模型评估的全流程,并推荐通过集成学习(如随机森林)和参数调优提升性能。两本入门级图书《Python机器学习原理与
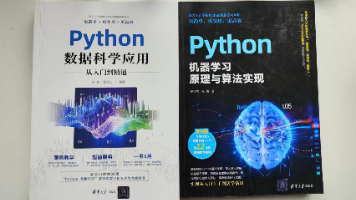
本文强调机器学习学习的实用导向,推荐两本Python入门书籍:《Python机器学习原理与算法实现》和《Python数据科学应用从入门到精通》。这两本书避开复杂数学推导,注重代码实操,包含490个案例和10小时视频教程,覆盖数据清洗、特征工程到建模全流程。特别适合非科班出身者快速掌握工业级应用技能,书中代码可直接迁移至金融、电商等真实业务场景。随书附赠源码、PPT等资源,通过边做边学模式帮助读者实
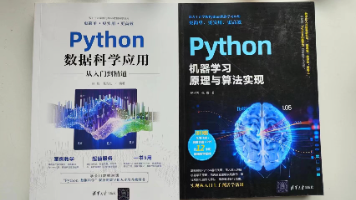
Python与机器学习深度融合,形成现代数据科学的核心工具链。Python凭借简洁语法和丰富库(如NumPy、Scikit-learn)大幅降低机器学习门槛,实现三行代码训练模型到构建神经网络的跨越。传统教学中二者割裂导致学习低效,而《Python机器学习原理与算法实现》等书籍通过问题驱动模式,将算法实现与Python编程有机融合,配套代码注释、视频讲解和实战项目,帮助零基础者绕过数学障碍快速掌握
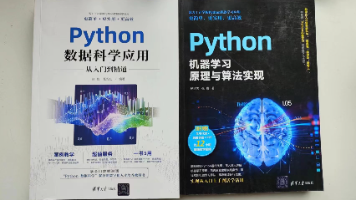
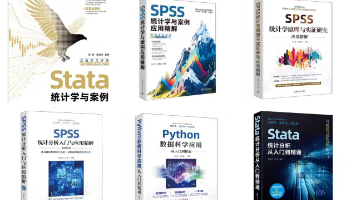
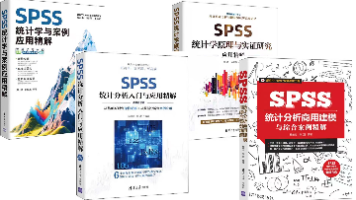
AI时代的数据分析已演变为技术、业务与表达融合的复合能力。技术维度建议根据需求选择工具:SPSS适合零基础快速进行标准统计分析;Stata是学术研究尤其是计量经济学的标杆;Python则具备最强的扩展性,适合数据科学和机器学习。业务维度强调从商业问题出发构建指标体系,培养领域知识。表达维度需掌握数据可视化和叙事能力,让分析产生价值。核心能力升级包括人机协作、批判性思维和持续学习。推荐构建T型能力矩

数据科学三大核心学科:统计学侧重数据推断与总体规律,计量经济学聚焦经济变量间的因果关系,而机器学习则追求预测准确度。SPSS、Stata和Python分别成为各学科主流工具:SPSS以菜单操作为特色适合统计入门;Stata专为计量经济模型优化;Python则凭借灵活性和丰富库支持机器学习全流程。针对不同学习需求,推荐杨维忠、张甜编著的系列教材,如《SPSS统计分析入门与应用精解》和《Python机
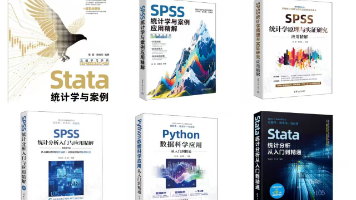
本文阐述了统计分析和机器学习对数据分析师职业发展的重要性,指出这两门学科是从数据提取转向洞察发现的关键。文章从五个方面展开:1)强调统计和机器学习能让分析从描述性转向预测性;2)统计学提供处理不确定性的科学框架;3)机器学习是统计学的扩展,能处理复杂问题;4)建议非科班学习者采用业务导向的渐进学习法;5)推荐SPSS、Stata和Python的实用学习资源,包括多本清华大学出版社的教材。全文旨在帮