登录社区云,与社区用户共同成长
邀请您加入社区
AI工程化是推动人工智能技术走向实际应用、创造实际价值的重要途径,随着技术的不断发展和应用场景的不断拓展,AI工程化将在未来发挥更加重要的作用。面对未来的挑战和机遇,我们需要加强技术研发与创新、建立数据治理体系、培养与引进人才以及关注法规与政策动态等多方面的努力来推动AI工程化的不断发展。
信用卡欺诈是金融行业面临的一个重要问题,快速且准确的欺诈检测对于保护消费者和金融机构的利益至关重要。本项目旨在通过利用自动编码器(Autoencoder)这一无监督学习算法,来检测信用卡交易中的欺诈行为,特别适合于异常检测任务,因为它能够学习正常数据的分布,并通过重构误差来识别异常数据。
⑤安装gdal:gdal属于第三方库,不能直接用pip安装,所以在https://www.lfd.uci.edu/~gohlke/pythonlibs/#gdal这个网址下载所需版本的gdal,然后输入。一、Anaconda的下载与安装,在清华镜像网站或者官网上下载Anaconda安装包:https://mirrors.tuna.tsinghua.edu.cn/anaconda/archive/⑥
原因:装sklearn包,包名不能是sklearn,而是scikit-learn。问题:用pip质量或者conda指令去安装sklearn的时候,仿佛都装不了。解决方法:以conda指令为例,安装sklearn包。
最近重新开始使用anaconda了,但是之前环境都删除了需要重新配置,但是当下载到sklearn包的时候怎么也安装不好,尝试了各种各样的方法,头疼了一上午,又是重装anaconda又是conda换各种源都不行。最后是用pip安装才解决的,突然想起来去年好像也是这么回事儿。主要原因就是国内下载太慢太慢了,时间一长自动认为下载失败!
(你不要直接搜sklearn,你下载这个包,你import导入的时候,还是会报错)大概长这样,然后你下载,这样子就ok了。然后你就可以正常导入sklearn的库了。下一步我们搜索scikit-learn然后下载。下载的前提是我们选择的是清华源的安装库。找到项目这一栏,有一个python解释器。首先我们打开pycharm。然后点击左上方的一个+号,
windows10环境下python安装sklearn当我运行python代码from sklearn.model_selection import StratifiedShuffleSplit时遇到了ImportError: No module named 'sklearn’这样的错误提示。这是因为我的python没有安装sklearn。而要安装sklearn之前必须要安装sklearn依赖..
机器学习在金融领域的应用日益广泛,其中股票预测是热门方向。其核心原理是利用历史行情数据,通过特征工程构造滚动统计量等特征,并定义预测标签,训练监督学习模型。技术价值在于提供数据驱动的决策信号,但需警惕数据泄漏和过拟合。典型应用场景包括量化策略信号生成和趋势判断。本文以Python和sklearn为例,详细讲解从数据获取、特征工程、模型训练到回测评估的完整链路,并重点剖析股票预测代码中常见的五大陷阱
机器学习中,时间序列预测需严格避免标签泄漏,核心在于特征工程与模型评估。通过构建滞后特征、滚动统计量等技术指标,将原始价格序列转化为监督学习样本,并采用时间序列交叉验证确保模型泛化能力。sklearn提供逻辑回归、随机森林、梯度提升等算法,结合回测与混淆矩阵可评估策略收益与风险。本文以股票预测为例,详细演示从数据获取、特征构造到模型训练与滚动回测的全流程,帮助读者掌握sklearn在金融时序预测中
完整代码# 二元Logistic回归算法#数据准备# 1载入分析所需要的模块和函数import numpy as npimport pandas as pdimport seaborn as snsimport matplotlib.pyplot as pltfrom warnings import ...
TensorFlow是由Google Brain团队开发的开源机器学习库,用于各种复杂的数学计算,特别是在深度学习领域。以下是对TensorFlow的详细概述:
案例测试。
多层网络是一种深度学习模型,也称为深度神经网络(Deep Neural Network, DNN)。它由多个神经网络层(或称为隐藏层)组成,每一层包含多个神经元(或节点),用于逐层提取和学习输入数据的特征表示。
决策树是一种基本的分类与回归方法,它通过一系列的决策规则将数据集分割为不同的类别或预测值。在决策树中,每个内部节点代表一个属性,每条边代表一个属性取值,每个叶子节点代表一个类别或预测值。决策树的生成过程通常包括特征选择、树的构建和剪枝三个步骤。总之,决策树是机器学习领域的重要算法之一,它以树形结构为基础,通过一系列的决策规则将数据集分割为不同的类别或预测值。在实际应用中,我们可以根据具体问题的特点
本教程详细介绍了sklearn的基础用法,包括数据加载、预处理、模型训练在机器学习模型的训练、调参和保存过程中,还有一些其他值得探讨的内容。
随机森林的本质还是决策树,在拥有决策树优点的同时,弥补了决策树的缺点。因为随机森林选取数据样本和特征都是随机的,所以在训练时要设定`random_state`,以确保我们每次训练都得到稳定的结果。
【机器学习】机器学习算法的随机数据生成
过滤法(方差过滤;相关性过滤,含卡方、F检验、互信息);嵌入法;包装法
【代码】sklearn train_test_split用法详解。
python sklearn pipeline做函数拟合,-看学习曲线(均方误差MSE)
机器学习 Sklearn 入门笔记
实现Kmeans算法实现聚类要求:1、根据算法流程,手动实现Kmeans算法;2、调用sklearn中聚类算法,对给定数据集进行聚类分析;3、对比上述2中Kmeans算法的聚类效果。读取文件def loadFile(path):dataList = []#打开文件:以二进制读模式、utf-8格式的编码方式
splitting = train_test_split(*arrays,**options)如:X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=0, shuffle=False)参数参数说明备注splittingX_trainlist, length=2 * len(ar
机器学习-Sklearn-06(逻辑回归制作评分卡)
Pycharm 调用sklearn时出现“Process finished with exit code -1066598274 (0xC06D007E)”解决方案问题描述跑代码的时候发现总是莫名奇妙的中断程序,出现代码“Process finished with exit code -1066598274 (0xC06D007E)”,网上搜半天也能用的解决方案,后面逐句运行发现是调用sklear
文章目录1. 二维SVM分类例子2. 多维SVM分类例子2.1 高斯核函数2.2. 多项式核函数2.3 多项式 LinearSVC%matplotlib inlineimport matplotlib.pyplot as pltimport numpy as np1. 二维SVM分类例子from sklearn.datasets import make_blobsX, y = make_blobs
机器学习从入门到入职--用sklearn与Keras搭建人工智能模型第四章4.1根据样本之间关联关系,及数据的行和列,用SimpleImputer方法进行缺失值处理,策略有均值插补、中位数插补和高频数插补。例子如下:#引用相应的库,numpy用于生成缺失值,sklearn.impute库中的simpleimputer方法用预处理缺失值import Numpy as npfrom sklearn.i
离散型编码的Python库,里面封装了十几种(包括文中的所有方法)对于离散型特征的编码方法,接口接近于Sklearn通用接口,非常实用可以使用多种不同的编码技术把类别变量转换为数值型变量,并且符合sklearn模式的转换。官方github:https://github.com/scikit-learn-contrib/category_encoders官方文档:http://contrib.sci
使用 python 做线性回归分析有好几种方式,主要的分别是 scipy 包,statsmodels 包,以及 sklearn 包。但是,这些包目前都不能处理共线性,即自动剔除部分共线性的变量,需要自己去编函数,这一点不如 spss 或 r 语言。1. 用 scipy 包做线性回归...
本文详细解析了使用sklearn进行机器学习实验时确保结果可复现的3个关键步骤,包括全局随机种子管理、数据准备阶段的可复现性以及模型训练中的随机性控制。通过正确设置random_state参数和采用端到端的工作流,可以有效解决实验结果的波动问题,提升团队协作和论文复现的效率。
作者:張張張張github地址:https://github.com/zhanghekai【转载请注明出处,谢谢!】【参考文献】sklearn 贝叶斯部分官网 https://scikit-learn.org/stable/modules/naive_bayes.htmlapache github主页:https://github.com/apachecn/AiLearning...
机器学习实战——朴素贝叶斯1 模型介绍1.1 朴素贝叶斯分类器1.2 朴素贝叶斯的参数估计2 朴素贝叶斯在Sklearn中的实现1 模型介绍1.1 朴素贝叶斯分类器朴素贝叶斯是基于贝叶斯定理及特征条件独立的假设来实现分类的方法,就是在已知先验概率的前提下,求后验概率的最大值。设样本集合为 xxx ,其属性集合为{x1,x2,⋯ ,xd}\{x_1
该部分用于文本分类任务的基础实现,主要包括机器学习(ml)和深度学习(dl)两大部分,机器学习部分基于sklearn/lightgbm包实现,深度学习部使用pytorch深度学习框架。机器学习部分主要包含特征工程和分类器两大部分:特征工程部分主要针对文本分类任务的hash/lsa/lda/doc2vec特征提取/特征选择/特征组合/特征构造进行了实现;分类器部分主要有逻辑回归/SVM/...
一、前言RMS泰坦尼克号的沉没是历史上最臭名昭着的沉船之一。1912年4月15日,在首次航行期间,泰坦尼克号撞上冰山后沉没,2224名乘客和机组人员中有1502人遇难。这场轰动的悲剧震撼了国际社会,并导致了更好的船舶安全条例。海难导致生命损失的原因之一是没有足够的救生艇给乘客和机组人员。虽然幸存下来的运气有一些因素,但一些人比其他人更有可能生存,比如妇女,儿童和上层阶级。这篇博客运...
据说,心情不好的时候,整理东西可以让好心情回归,那么同理,懒散得想要沉沦时候,总结知识可以召回学习的神龙。学习回顾:认识sklearn:scikit-learn,Python库之一,Scipy(Scientific Python,Python科学计算)工具集的一部分,该库整合了多种机器学习算法,因此可用scikit-learn库实现机器学习,可用来预测模型的创建和验证。sciki
那么这个问题可能出在Onedrive上,系统语言设置为中文时,Onedrive出现将英文翻译为中文,导致conda生成脚本文件时路径出现乱码的迷惑操作。最终导致conda无法将脚本放入“Documents”文件夹。运行conda init powershell 虽然提示已经完成,但是最后一项运行脚本路径存在乱码,我对比了另一个系统使用非中文账户的运行结果,发现乱码字符是“Documents”。将乱
客户需求背景主要原因是各个包版本不兼容。
# 将数据集按照比例划分为训练集和测试集def split_datas(datas,labels,random_state=1,train_size=0.9,test_size=0.1):train_data, test_data, train_label, test_label = sklearn.model_selection.train_test_split(datas,.
jupyter notebook 导出 markdown文件格式原本jupyter notebook 里面自带的可以选择导出为markdown格式,但是下载之后文件总是打不开,只能另寻他法方法:第一步:安装nbconvertpip install nbconvertPython-第二步:安装pandocpip install pandocPython第三步:在你要转换的文件目录下输入以下指令:ju
2.处理缺失值下载 UCI 数据集中的“匹兹堡的桥”(https://archive.ics.uci.edu/ml/datasets/Pittsburgh+Bridges, 选择其中的bridges.data.version1 部分)。对该数据集中出现的缺失值(用?表示),选择一个数值列,用平均值填充;选择一个离散列(离散型取值),用众数填充。说明:(1)建议放入数据集的特征名。(2)建议将缺失值
遇到这个问题的原因通常是,在预测的标签中缺少实际的标签。我举个简单的二分类的例子:实际标签 1,1,1,1,0,0,0,0预测标签 0,0,0,0,0,0,0,0这里在预测标签中就没有 1 这个标签。这个时候就会出现这样的警告,注意这个是警告并不是错误。一种避免警告的方法如下:import warningswarnings.filterwarnings("ignor...
对于低维度数据集,或者高维度数据集在使用pca等方法降维后,有时需要根据标签画出3维图,不同类别标签使用不同颜色。如下图所示,x,y,z为数据特征,根据类别使用不同颜色。可见,特征混叠严重,需要更换降维方法。以下,将以 kaggle中Instant Gratification数据集(二分类数据集)为例,在使用pca降维后,根据类别使用不同颜色画图。
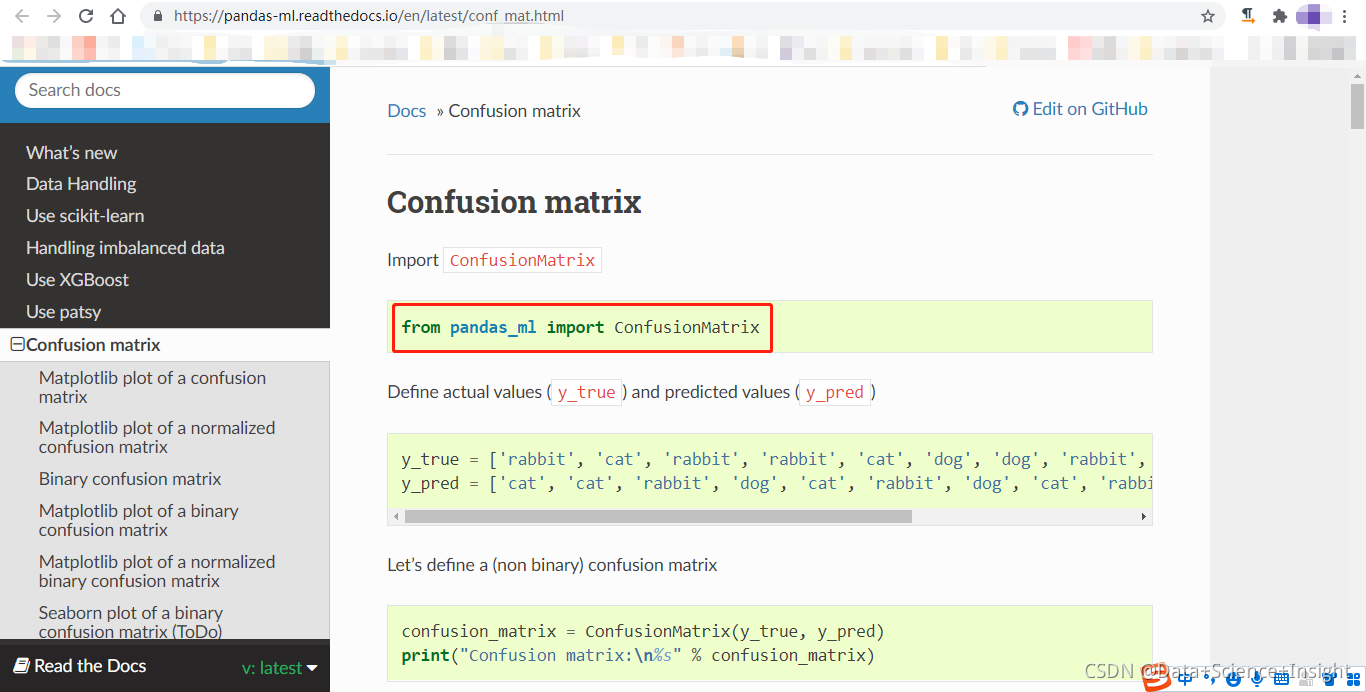
Python使用pandas_ml输出混淆矩阵以及从混淆矩阵衍生出来的其他指标:TP、TN、FP、FN、TPR、TNR(SPC)、PPV、NPV、FPR、FDR、FNR、ACC、F1、MCC等目录Python使用pandas_ml输出混淆矩阵以及从混淆矩阵衍生出来的其他指标:TP、TN、FP、FN、TPR、TNR(SPC)、PPV、NPV、FPR、FDR、FNR、ACC、F1、MCC等#panda
sklearn pandas系统环境1.安装pandas系统环境CentOS Linux release 7.7.1908 (Core)Linux version 3.10.0-1062.1.1.el7.x86_64 (mockbuild@kbuilder.bsys.centos.org) (gcc version 4.8.5 20150623 (Red Hat 4.8.5-39) (GCC...
数据集使用MovieLens数据集import pandas as pdimport numpy as npheader = ['user_id', 'item_id', 'rating', 'timestamp']dataset = pd.read_csv('../data/u.data',sep='\t',names=header)#计算唯一用户和电影的数量# unique对...
最近在做数学建模,要使用深度森林算法,于是我安装了相应的模块,但是在调用的时候,scikit-learn中的函数一直报错,如下图于是查找资料,但是找到的资料都是GitHub上的英文解决方案,因此我自己做了笔记,来帮助其他人解决这个问题。
pandas读取csv,sklearn.model_selection.train_test_split 划分训练集和验证集。
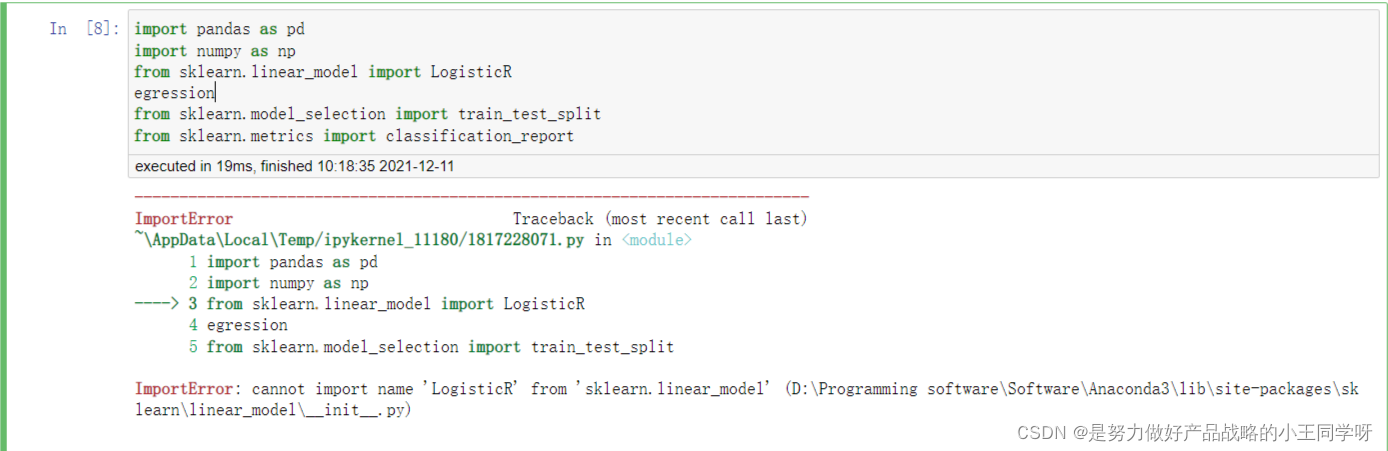
1.问题:调用sklearn出现诸如ImportError: cannot import name 'LogisticR' from 'sklearn.linear_model' (D:\Programming software\Software\Anaconda3\lib\site-packages\sklearn\linear_model\__init__.py)2.环境:我是python3,
一丶监督学习概述:通过已有的数据结果,分析训练出一个预测模型,使模型能够对任意给定的输入,对其相应的输出做出一个好的预测。即: 根据训练集训练出模型, 再根据测试集对结果预测.1.回归模型1.1线性回归概念: 一般用于求一个变量随着另一个变量的变化而变化的情况多元线性回归:现实生活中, 一个变量所受的影响往往不只是会受另一种的变化,而是会受到多种情况的影响,这就需要使用多元线性回归求解的两种方式:
之前的from sklearn.externals import joblib或者是from sklearn.utils import joblib。1.该报错是应为sklearn的版本太高的问题。这二个接口都已经不存在了。
sklearn
——sklearn
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区









 天工造物局

