登录社区云,与社区用户共同成长
邀请您加入社区
大多数介绍 GPT Image 2.5 的文章放一张漂亮的图就结束了。这篇换个写法:挑三个大家真正在花钱用的场景,2026 年 9 月 26 日通过 API 从头跑了一遍,每一张图的提示词、参数、耗时和花费都写在下面,照着就能复现。。利益相关:我在工作,本文的图都是在这里跑的。APIModels 是一个 AI 模型 API 聚合平台,用一个兼容 OpenAI 的 Key 就能调用 GPT Imag
做AI短剧的人都有个体会:单条生成不难,难的是产能。一条视频从写prompt到出片到剪辑发布,全流程走完少说40分钟。一天满打满算做10条已经是极限。但短剧赛道拼的就是更新频率——日更3条是底线,日更5条才能维持账号活跃度。瓶颈不在创意,在工程。
OpenAI GPTImages2.5升级显著,生成速度提升50%,图像保真度增强,新增草图参考、局部标注编辑、模板库、透明背景输出及多轮一致性编辑等能力。国内用户可通过兼容MaaS中转平台(如myapi-ai.com)便捷体验,无需特殊网络或部署,支持网页端操作与API集成。实测显示,草图构图、透明PNG输出、模板化生成等场景应用高效实用,提示词优化可进一步提升效果。本文仅为技术测试记录,服务合
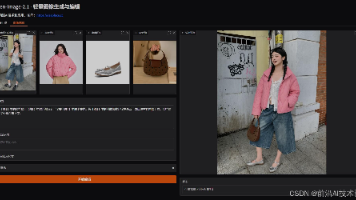
Qwen-Image-2.1 是一个“小巧但全能”的图像模型,把生成、透明图处理、多参考图编辑、局部精准修改都整合在一起,特别适合需要高效出图和灵活编辑的设计、电商和内容创作场景。图像编辑选项卡“自定义尺寸”参数,默认关闭,即编辑后的图像保持“参考图1”的尺寸,如果开启,则支持自定义编辑后的尺寸,请手动设置,建议参考或接近“参考图1”的尺寸,否则会出问题。更高级的采样器通常所需步数较少。启动Web
Windows 用户最省事的路线是:安装 ChatGPT 桌面应用,打开本地项目,登录 Codex,保留请求审批,再从只读分析任务开始。需要 Linux 工具链或终端工作流时,使用 WSL2,在 Linux 主目录中保存代码,再通过官方安装命令部署 Codex CLI。两条路线的核心都不是“装完就自动改代码”,而是把本地项目、Git 检查点、审批权限和验证结果组成一个可控的工作循环。先让 Code
本文介绍如何通过AI工具将现有视频转化为可编辑的脚本,分为两大步骤:一是利用ASR技术实现视频转文字,提取对白、旁白与场景信息;二是借助NLP与生成模型进行内容结构化重构,实现风格调整、创意扩写与多场景适配。推荐使用剪映、讯飞听见等工具完成转写,结合ChatGPT或专业短剧平台进行脚本再创作。关键技巧包括提取多维信息、复用成功元素、多角度重构,并沉淀素材以保障系列内容一致性。根据需求选择免费或付费
本文深度对比DALL-E 2/3、Imagen、Stable Diffusion/SDXL与Midjourney的技术架构与效果差异。从文本编码器(CLIP→T5)、扩散空间(像素→潜空间)、模型开源性到美学调优,揭示各模型核心优势:DALL-E 3借GPT-4提升语义理解,Imagen以T5实现精准描述,SD系列靠开源生态爆发,Midjourney则以美学优化和社区运营制胜。最终形成“可控性”“
DALL-E 3通过GPT-4重写用户提示并结合强Caption模型生成的详细描述,突破了CLIP编码的信息瓶颈,实现精准文本-图像对齐。其“缝合怪”架构融合LLM、潜空间扩散与多阶段生成,显著提升细节还原与复杂场景理解能力。相比DALL-E 2的unCLIP方案,数据质量与架构协同优化带来质变。该策略对LoRA训练与Prompt工程具有普适启示,推动生成式AI向更可控、高精度方向演进。
批量准备电商图,除了提示词,还要算清生成费用、处理等待中断和异常结果。本文以 GPT Image 2.5 Flare 为例,介绍 Python 参考图上传、请求预览、任务 ID 保存与查询恢复,对照 OpenAI 官方计费和 imgAPI 按张报价,并说明超时补偿、严重质量异常赔付的条件与申请方式。附 MIT 开源接入示例。
76元一份的星蝶公主头像,在小红书上**卖了4000多份直接收入30万**,21.9元一份的AI萌娃头像,**2000+人购买,直接收入4万多**!
今天和大家推荐一款基于Flux训练的真人写实的lora模型:Flux_小红书真实风格丨日常照片丨极致逼真。一看这个模型的命名,就可以猜测出以小红书日常真实拍摄的照片为数据集训练而来,该模型生成的照片风格极度真实自然。今天我们中国著名景点旅游拍照打卡为场景来体验一下图片生成的效果。注意目前Flux模型还无法正确理解中国各种著名景点,所以提示词中关于著名景点的场景描述参照即可,大家不用太较真哈。我们只
用了很久的Stable Diffusion,但从来没有好好解析过它内部的结构,写个博客记录一下,嘿嘿。Stable Diffusion是比较新的一个扩散模型,翻译过来是稳定扩散,虽然名字叫稳定扩散,但实际上换个seed生成的结果就完全不一样,非常不稳定哈。Stable Diffusion最开始的应用应该是文本生成图像,即文生图,随着技术的发展Stable Diffusion不仅支持image2im
如果想从一张分辨率低的图片得到一张高清的图片,直接用缩放的方法肯定是不行的,就像下图那样,左面是我们在stable diffusion 中用AI生成的小姐姐,右边是用 PhotoShop直接放大4倍后的效果,很明显,放大后的图片变得很模糊。而在 stable diffusion 中,我们想将一张低分辨率的图片放大到4K高清图片,方法有很多种,但哪种才是最优解呢?方法1,直接在附加功能中放大图片。
整合包对非技术出身的同学比较友好,因为秋叶大佬把相关的东西已经都整合好了,只需要点点点就行了。当然懂编程的同学就更没有问题了。
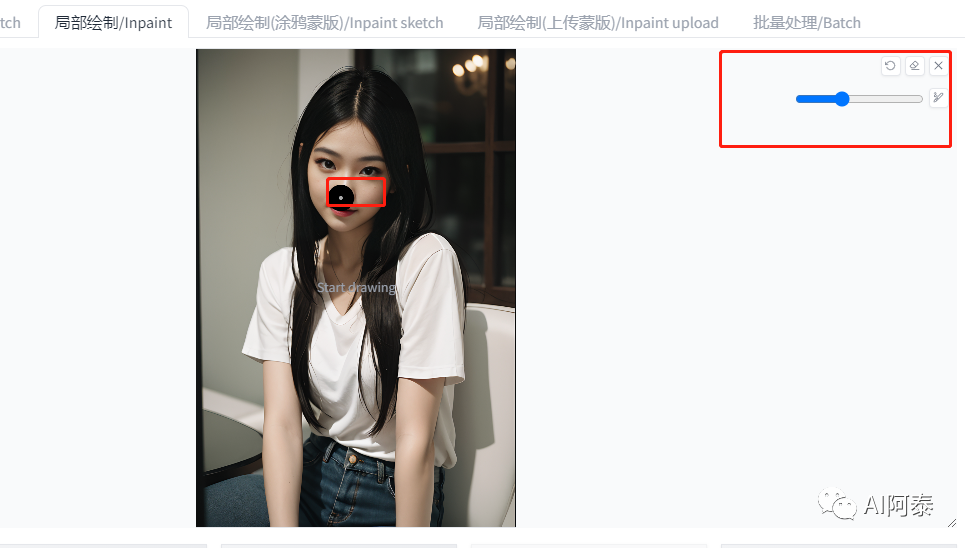
今天分享stable diffusion 局部重绘功能文章使用的AI绘画SD整合包、各种模型插件、提示词、AI人工智能学习资料都已经打包好放在网盘中了,有需要的小伙伴文末扫码自行获取。局部重绘能够对图片进行快速换衣 换背景 换模特局部重绘主要用到画笔工具进行涂抹1.绘制非蒙版内容:将画笔涂抹的区域进行重绘2.绘制非蒙版内容:除了画笔涂抹的区域外进行重绘3.绘制区域 全图:在原图大小的基础上 绘制蒙
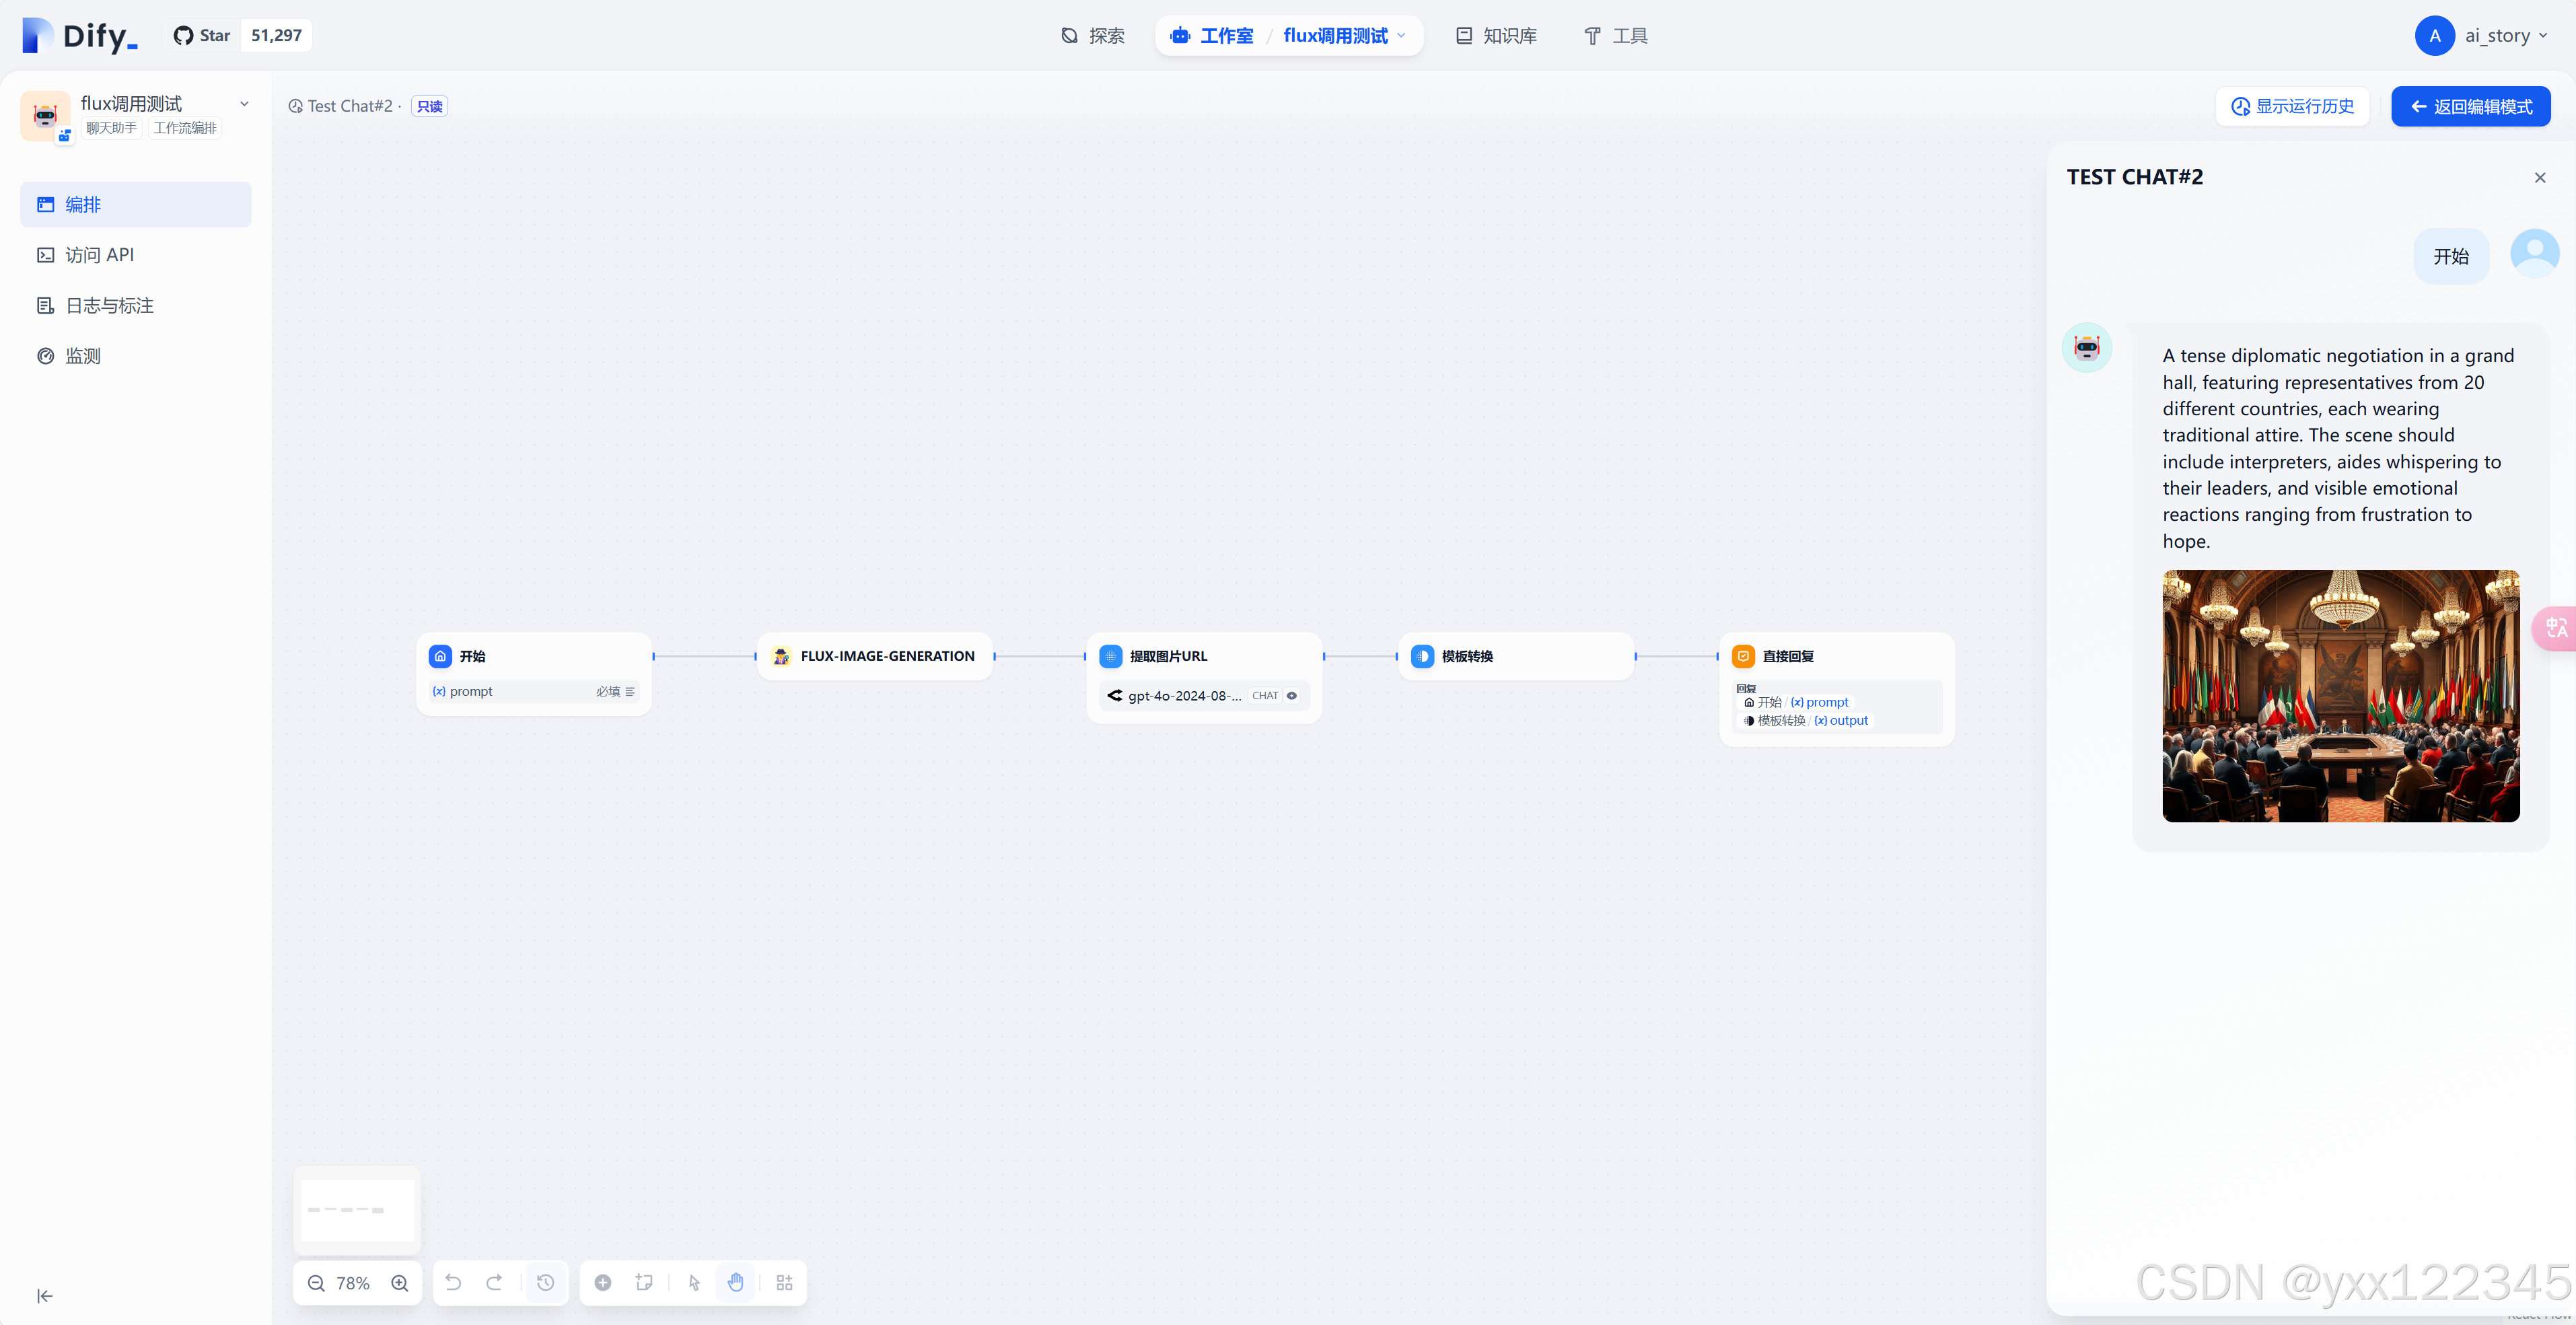
"info": {"description": "Flux Image Generation API. Powered by 柏拉图AI.",},"paths": {"post": {"description": "Generate images using Flux model. Powered by 柏拉图AI.",],"model": {},},"size": {},"model","pro
给大家推荐三个最好用的写实风格的**Stable Diffusion Model00:00 概述01:00 ChilloutMix模型04:45 Deliberate模型07:17 Realistic Vision1 ChilloutMix 下载地址**** https://civitai.com/models/6424/chilloutmix?ref=blog.256pages...
AIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,AIGC技术将继续得到提高,同时也将与人工智能技术紧密结合,在更多的领域得到广泛应用。感兴趣的小伙伴,赠送
腾讯云Serverless SD开放免费试用申请;FlowUs AI 开启公测全面;Meta开源AI模型ImageBind;中国互联网大厂的 ChatGPT 追赶之旅……点击阅读全文
在用webui转换游戏图标的风格时,使用controlnet固定图标样式,运行报错:,报错说的是pytorch在进行矩阵乘法运算时,第一个矩阵的行数与第二矩阵的列数不相等,无法作乘法。一头雾水,查了github,google,百度都未找到解决方法,为了后续人少踩坑,把写问题记一下。当更换当前大模型后,再用同样的参数画图,然后就没报错了。所以,解决方
如果有朋友想尝试上面这种视频,主要难度在于视频剪辑,手搓需要用多种工具配合,难度较大。工作流已放共享空间,每个工作流都附有单独的教程说明,小白也不怕。先看作者的数据,有点炸裂。让我们看看生成的效果。
体验地址:https://ucnygalh6wle.feishu.cn/wiki/Ii9uwKHweibsZSkJHGacXJZgnGh。扣子工作流三分钟制作“三分钟读书”爆火书单号带货视频,150条作品,18万粉丝,获赞42万,附核心工作流。如果有朋友想尝试上面这种视频,主要难度在于视频剪辑,手搓需要用多种工具配合,难度较大。让我们看看生成的效果。
SparkAi创作系统是一款基于OpenAi/ChatGPT、GPT-5、AI大模型、AI智能体、扣子coze、Agent智能体、AI绘画Midjourney、Dalle绘画开发的AI大模型智能问答系统、AI绘画系统、Agent智能体一站式系统;自定义GPTs智能体对接、支持 Dall-E-2/3、支持Midjourney的AI绘画等主流前沿AI绘画。文生图、图生图、垫图混图、角色一致参考图、风格
感兴趣的小伙伴,赠送全套AIGC学习资料,包含AI绘画、AI人工智能等前沿科技教程和软件工具,具体看这里。AIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,
如果想从一张[分辨率]低的图片得到一张高清的图片,直接用缩放的方法肯定是不行的,就像下图那样,左面是我们在stable diffusion 中用AI生成的小姐姐,右边是用 PhotoShop直接放大4倍后的效果,很明显,放大后的图片变得很模糊。而在 stable diffusion 中,我们想将一张低分辨率的图片放大到4K高清图片,方法有很多种,但哪种才是最优解呢?方法1,直接在附加功能中放大图片
ai画图comfyUI,私有化本地部署,一键安装三秒出图。
一、prompt提示词][1、概况][2、prompt分类][3、提示词的权重分配][4、反推提示词][二、WebUI参数说明][1、文生图参数][2、图生图参数][3、inPaint局部重绘及参数][三、模型][1、模型类型][(1)大模型][(3)LoRa:低秩模型][(4)Hypernetwork 超网络][2、模型分类及top模型名称][(1)二次元模型][(2)真实系模型][(3)2.5
一个关于产品摄影的Lora模型,更适合美妆类的产品。一个关于产品摄影的Lora模型,在调用触发词后能够生成产品摄影的图片,如果再稍加点提示词,可以泛化出更多的场景图。写这篇文章的初衷,网上的Stable Diffusion教程太多了,但是我真正去学的时候发现,没有找到一个对小白友好的,被各种复杂的参数、模型的专业词汇劝退。,也是产品展台设计lora,生成的风格可以更多样:科技、国风、简约、风景,适
观察生成的多张图片后,可以根据目标需求和生成效果来对提示词进行优化和调整。这可能包括更改关键词,调整参数或者试验不同的表达方式。通过这种反复迭代和调整的过程,才能逐步接近理想的图像效果。这也是我们提升AI绘图技巧,实现个性化创作需求的关键步骤。
Stable Diffusion是一款用于生成AI图片的软件。这些图片可以呈现出照片般逼真的效果,就像由相机拍摄一样,也可以呈现出艺术家专业创作的艺术风格。最最重要的是,SD是免费的(和Midjourney相比)
目前AIgc领域正在持续关注,等到年底的时候做一个最全面的视频和文字讲解,现在还是在等等,目前AI领域热度确实是在持续降温,但是呢,深入了解AI的人都知道,AI的发展不是想人一样需要很长时间的积累,有时候可能就是一个算法的突破,就能应用到文字,图像声音等。(注意不是说AI没有积累,只是说这种发展会很激进,往往可能一夜之间,就和变天一样)。之前有人问我,如何真人转二次元,要做的很像。
5月16日,C站一个刚刚发布的lora,当天就达到了11k的下载量。熟悉C站的小伙伴都知道,很多知名模型也不过这样的下载量,这是一个什么模型,如此受欢迎?从模型名字看,很显然是个中国小哥训练出来的,这个lora的名字里就带着中文:Shiny pantyhose\亮丝\马油袜\黑丝。更有趣的是,作者发布页面用了四种语言:中英日韩。大部分模型中的丝袜表现不佳,因此我重新制作了丝袜模型,训练时背景与人像
本地部署controlnet,利用huggingface提供的训练代码和数据进行训练。从相关文件的下载,环境的配置,到训练模型,测试模型,以及报错的解决
这段文字详细讲解了 Pandas 库中 axis 参数的使用方法。首先,它回顾了 axis 参数在 drop 方法中的作用,解释了 axis=1 表示删除列,axis=0 表示删除行。然后,它通过 drinks.mean() 例子展示了 axis 参数在计算平均值时的作用。默认情况下,axis=0,表示计算每列的平均值。最后,它总结了 axis 参数在 Pandas 中的普遍用法:当一个方法...
大家好,上次的视频中我们介绍了三款写实风格的模型。https://youtu.be/eqcZ7ipyKLoStable Diffusion 玩家中有不少动漫迷,因为有很多专门为动漫开发的功能和模型。在众多动漫风格的 Checkpoint Model 中,我为大家推荐了最好的三个!以下是 Stable Diffusion Top3 动漫 Model。模型一【Anything】(适合各种主...
AI绘图界的stable diffusion这个当红炸子鸡,画人很强,而且出图超快,几秒钟就能完成一张图,尤其是最近不再需要内测邀请就能使用,更方便大家开始玩耍。我也开始玩Stable diffusion,有了它之后,Disco Diffusion就已经很少打开了。所以近期我发文的末尾,备注的都是“图像来源:stable diffusion”。
宠物AI写真“猫猫守护神”在小红书上走红
AI绘画stable diffusion入门基础教程(非常详细),AI绘画入门到精通,收藏这一篇就够了!
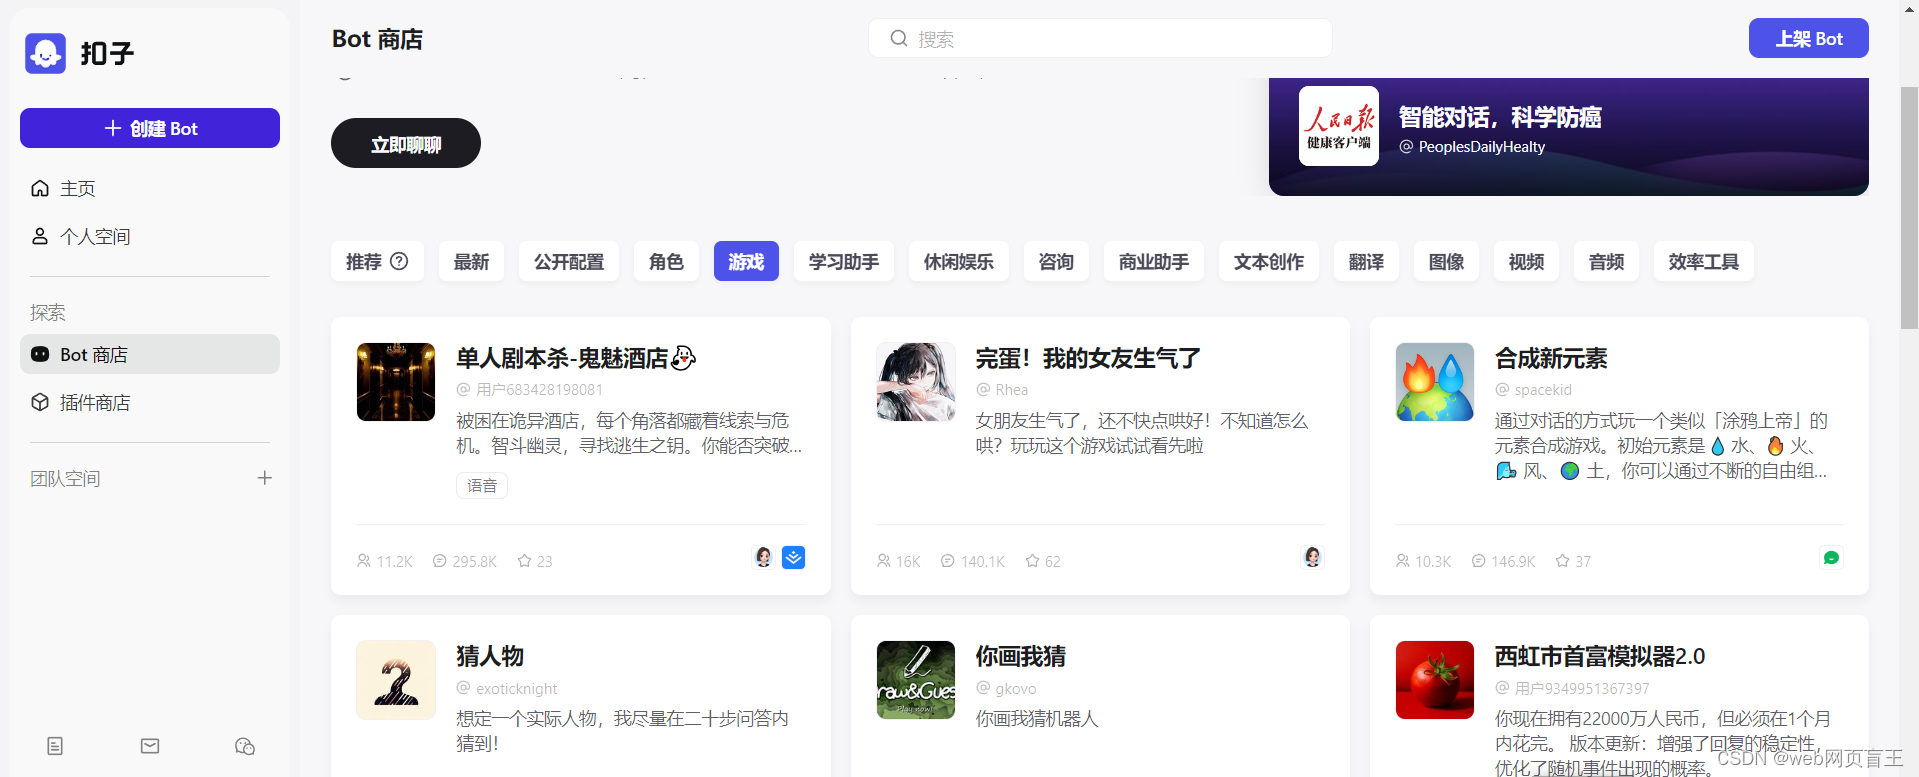
扣子是字节跳动推出的 AI Bot 开发平台,整合了插件、长短期记忆、工作流、卡片等丰富能力,它能让用户仅仅说几句话,就能开发属于用户自己的定义AI,同时支持一键发布到飞书、微信公众号、豆包等渠道。同时,官方内置大量插件供用户使用,在Bot商店也能体验到大量其他用户开发的Bot。文字类有专门写爆款文案,周报等。图片类有制作头像、绘画等。甚至可以体验到文字游戏,比如沉浸式体验剧本杀或者中国人最喜欢的
AI绘画——Stable Diffusion模型,变分自编码器(VAE)模型 , lora模型——调配设置与分享
本文手把手教你将百炼 CLI 作为 agent skill 集成至 coding agent,仅用自然语言即可驱动生图、视频生成及六大进阶场景(竖屏、图生视频、多轮改图、首尾帧、文档转视频、批量生图),并详解参数逻辑与实测避坑指南。通过命令拆解与成本控制,实现高效、可控的 AI 内容生产,真正让 Agent 做“拼命令”的活,你专注提需求。
从文章中我们可以知道,。后台也有很多小伙伴问我,有没有什么模型可以推荐的,我这边就给大家简单介绍几个我自己觉得还不错的模型。同时,也给大家避避雷,有的模型又大又慢,就不用下载了。
Stable Diffusion是基于人工智能技术开发的绘画工具,用户可以根据任意文本输入生成高质量、高分辨率的逼真图像。目前Ai绘画火爆,不少用户咨询我们关于Ai绘画的配置要求和电脑配置方案,下面装机之家分享一下stable diffusion AI绘图电脑配置要求,顺便推荐几套组装电脑主机配置推荐。stable diffusion AI绘图配置要求CPU:intel 酷睿12代i3四核处理器;
目前AIGC领域里最强的两款软件,Midjourney(MJ)和stable diffusion(SD)到底有什么区别?我们应该怎么选择呢?这是很多新手朋友经常问的问题,这篇文章对此问题专门进行解释说明。
DeepSeek这次的开源行动,不仅展示了他们在技术上的深厚积累,更体现了他们对开源社区的 commitment 和对 AGI 发展的推动。他们将自己在生产环境中经过验证的技术无私地分享出来,让每一行代码都成为加速AI发展旅程的动力。DeepSeek的“车库精神”和社区驱动创新的理念,让这些技术不再是高高在上的“黑科技”,而是成为了所有AI研究者和开发者可以共同探索和改进的资源。性能分析数据: h
AI作画
——AI作画
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 快递鸟社区
 火山引擎视频云技术社区
 EazyDevelop社区

 AtomGit AI 社区

 全球具身智能开发者社区


 乐奇 Rokid 开放社区






















 天工造物局