登录社区云,与社区用户共同成长
邀请您加入社区
本文提出一套基于ComfyUI+本地LLMAgent+Wan2.2-ReMixV3.0的无人值守漫剧自动生成流水线,可在8G显存消费级显卡上实现长剧集全自动生产。通过角色特征缓存、智能分镜生成、显存自动回收、失败重试机制及本地TTS配音与字幕合成,解决换场景脸变、显存溢出、流程割裂等痛点,全流程离线运行,输出符合红果短剧规范的竖屏成片,显著降低人力与成本,助力个人及小团队高效量产高质量漫剧。
本文提出一套基于ComfyUI+本地LLMAgent+Wan2.2-ReMixV3.0的无人值守漫剧自动生成流水线,可在8G显存消费级显卡上实现长剧集全自动生产。通过角色特征缓存、智能分镜生成、显存自动回收、失败重试机制与本地TTS配音字幕集成,解决换场景变脸、显存溢出、流程割裂等痛点,全流程离线运行,输出符合红果短剧规范的竖屏成片,显著降低人力与成本,助力个人及小团队高效量产高质量漫剧。
本文介绍了如何在星图GPU平台上自动化部署Qwen-Image-2512-ComfyUI镜像,高效实现AI图像inpaint修复。用户无需配置环境,一键启动即可对照片中路人、划痕、标签等局部区域进行语义级智能填充,广泛适用于电商修图、老照片修复及内容去瑕疵等典型场景。
对于预算有限、显卡只有 8G,又想做 AI 漫剧本地量产的创作者来说,LocModel 是一套非常省心的一体化方案。它把过去分散的大模型、绘图、视频工具整合,屏蔽了底层 CUDA、依赖、显存调度的复杂细节,不用再花大量时间解决环境报错,把精力放在剧本、分镜、提示词本身,快速搭建属于自己的离线漫剧生产流水线。
在图像生成领域,传统图生图依赖噪声重绘与提示词控制,往往难以精准修改局部内容。随着视觉语言模型的发展,指令式图像编辑成为新方向,它通过自然语言直接描述“改什么、怎么改”,让编辑过程更可控。ComfyUI作为模块化工作流平台,可无缝集成轻量级指令编辑模型QwenImageEdit,以极简节点实现背景替换、元素增删等操作。该方案基于0.6B参数模型,消费级显卡即可运行,大幅降低硬件门槛。实际应用中,工
Stable Diffusion作为当前最流行的AI图像生成技术,通过扩散模型原理实现从文本到图像的智能转换。其技术价值在于为创作者提供了高效的视觉内容生成能力,广泛应用于数字艺术创作、概念设计、广告营销等场景。ComfyUI作为基于节点式工作流的Stable Diffusion工具,在批量任务处理和资源利用效率上具有显著优势。秋叶整合包通过全中文界面和中文提示词支持,结合一键安装部署方案,有效解
AI绘画工具ComfyUI的节点式工作流依赖Python、PyTorch与CUDA环境,手动配置常因版本冲突导致启动失败。秋叶整合包通过预置嵌入式Python、匹配CUDA组件和可视化启动器,将环境配置标准化,降低安装门槛。该方案适用于无命令行经验的新手或希望快速部署的开发者,能有效解决依赖缺失、路径错误和显存不足等常见问题。从下载校验、解压到模型放置与工作流运行,整合包让用户专注于创作而非环境调
AI绘画正从专业领域走向大众,而Stable Diffusion的开源生态催生了ComfyUI等节点式工作流工具,将文生图拆解为可灵活组合的功能积木。节点化设计赋予创作者极高自由度,但复杂的环境配置——Python、PyTorch、CUDA版本匹配——往往是新手入门的最大障碍。秋叶ComfyUI整合包通过便携式封装和绘世启动器,将依赖、模型、插件统一管理,实现解压即用。从硬件门槛、路径规划、模型摆
本文介绍了如何在星图GPU平台上自动化部署Nunchaku FLUX.1-dev文生图镜像,并利用ComfyUI可视化界面进行AI绘画创作。该平台简化了复杂的环境配置流程,用户可快速搭建个人AI画室,轻松将文字描述转化为细节丰富的高质量图像,适用于艺术创作、设计灵感生成等场景。
本文提供了一种无需重装PyTorch即可消除ComfyUI中"WARNING:You need pytorch with cu130"警告的解决方案。通过修改ComfyUI核心文件quant_ops.py中的CUDA版本检测条件,将版本阈值从(13,)改为(0,),可以绕过严格的CUDA13.0+版本检查,同时保持CUDA加速功能正常使用。该方法特别适合RTX30/40系列显卡
本文介绍了如何在星图GPU平台上自动化部署ComfyUI镜像,快速搭建AI图像生成工作流引擎。该平台简化了部署流程,用户可轻松配置并启动服务,将ComfyUI从本地工具转变为稳定的生产级应用,核心应用于自动化、高质量的AI图片生成与团队协作场景。
本文介绍了如何在星图GPU平台上自动化部署Z-Image-ComfyUI镜像,开箱即用运行阿里开源的中文优化文生图模型。用户无需配置环境或编写代码,通过网页界面即可快速生成高质量图像,典型应用于社交媒体配图、电商主图制作及中文提示词驱动的AI绘画创作。
本文介绍了如何在星图GPU平台上自动化部署Z-Image-ComfyUI镜像,快速启用国产高性能图像生成能力。通过平台一键拉起环境后,用户可轻松安装Z-Image专属自定义节点,实现基于自然语言提示的高质量图片生成,典型应用于国风设计、AI绘画创作等场景。
官方整合包中的ComfyUI默认不带Manager,需手动安装。通过GitHub下载插件压缩包,解压后放入custom_nodes目录,重启即可启用管理器,方便后续节点扩展与管理。
官方整合包启动的ComfyUI默认不带Manager,需手动安装。通过GitHub下载对应插件,解压后放入custom_nodes目录,重启即可启用节点管理功能。
Midjourney 是一款基于文本生成图像的 AI 创作工具,与 Stable Diffusion 和 DALL·E2 并称为当今三大 AI 绘画软件,各具特色。
本WebUI是由B站up主@秋葉aaaki精心整合的StableDiffusion一键启动安装包。这个版本专为那些对AI绘画感兴趣的初学者设计,使得用户能够在没有技术背景的情况下,轻松部署并使用StableDiffusion。
comfyUI自从面世以来,就以一种潜力股的姿态快速流行了起来,越来越多的小伙伴开始使用comfyUI。也许你一开始会被comfyUI密密麻麻的“线路”吓到,但其实comfyUI也没那么复杂,并且好处多多。
本文探讨如何将ComfyUI的可视化节点流程与WebRTC的实时通信能力结合,实现多用户远程协同编辑AI生成流程。通过P2P数据通道同步节点状态,支持低延迟操作同步、权限分级与离线缓存,提升团队协作效率,推动AIGC工具向群体智能平台演进。
本文介绍了如何在星图GPU平台上一键自动化部署“语音+图片合成数字人视频工作流”镜像,快速搭建数字人视频制作环境。该工作流基于ComfyUI,用户只需上传人物图片和音频,即可高效生成唇形同步的数字人视频,广泛应用于企业宣传、在线教育等短视频内容创作场景。
本文介绍了如何在星图GPU平台上自动化部署语音+图片合成数字人视频工作流镜像,实现无需代码的数字人视频生成。通过ComfyUI可视化界面,用户可快速将人物图像与音频合成为口型精准的视频,适用于企业宣传、教育课件和短视频制作等场景,显著提升内容生产效率。
视频生成模型正在成为内容生产的新基建,而本地部署则是实现可控生成与低成本试验的关键路径。MiniMax H3作为一款高权重视频生成模型,通过ComfyUI工作流可完成文生视频、图生视频及参考模式生成,其中ref2va全能参考模式能有效保持人物ID一致性,为虚拟主播、固定角色视频创作提供了技术支撑。在工程实践上,结合量化整合包可降低显存门槛,使8G显存级别的NVIDIA显卡也能运行。生成后的视频片段
视频超分辨率技术旨在通过算法提升视频的清晰度与细节表现,其核心原理是从低分辨率序列中重建出高分辨率画面。传统方法多依赖插值与锐化,容易产生伪影,而结合扩散模型与提示词引导的AI方案,则能基于对画面内容的理解智能补充细节,显著提升视觉质量。这项技术在短视频创作、老片修复、游戏录屏增强等场景中具有重要应用价值。本文以Wan2.2模型和ComfyUI节点化框架为例,详细解析如何构建一个本地化、可定制的智
图像超分辨率(Super-Resolution)技术旨在通过算法将低分辨率图像重建为高分辨率版本,其核心原理通常基于深度学习模型学习高低分辨率图像间的映射关系,以恢复或生成缺失的细节。这项技术的价值在于能突破原始图像传感器的物理限制,在影视修复、医学成像、卫星遥感等领域提升视觉信息的可用性与分析精度。在AI生成内容领域,结合扩散模型,超分技术不仅能提升画面清晰度,更能实现基于文本条件的智能细节增强
超分辨率(Super-Resolution)技术通过模型重建高频细节,将低分辨率视频提升至4K画质,是AI视频制作中关键的预处理环节。在ComfyUI这类节点化工作流中,视频超分不仅涉及单帧放大,还需处理时序一致性、人脸崩坏等问题。潜空间(Latent Space)操作作为扩散模型的核心机制,在压缩特征层面进行重绘优化,可显著降低显存开销并提升整体稳定性。当视频中人物面部像素较少时,直接放大易导致
本文介绍了如何在星图GPU平台上自动化部署Qwen-Image-2512-ComfyUI镜像,快速构建中文图像生成环境。该镜像专为Qwen-Image-2512模型深度优化,支持一键启动与开箱即用,典型应用于中文海报设计、电商宣传图等多行文本排版场景,显著提升视觉内容创作效率。
通过蓝奏云分发DDColor模型,结合ComfyUI可视化工作流,用户无需编程即可本地运行AI上色,简化家庭老照片修复流程,兼顾隐私与易用性,推动AI技术普惠化落地。
本文详细解析了ComfyUI与Stable Diffusion WebUI之间实现模型共享的两种核心方法:符号链接与YAML配置。通过路径映射技术,用户可让两个平台共用同一套模型文件,从而有效解决硬盘空间重复占用问题,提升模型管理效率与一致性。文章提供了从原理对比到实战操作的完整指南,帮助用户根据自身存储环境选择最佳方案。
目前使用 Stable Diffusion 进行创作的工具主要有两个:WebUI 和ComfyUI。而更晚出现的ComfyUI凭借超高的可定制性和复现性迅速火遍全球。有设计师表示SD发布了XL1.0后,ComfyUI用它优秀的底层逻辑率先打击了臃肿不稳定的WebUI1.6,成为更适合“体验”XL的SD生图工具。需要体验的小伙伴直接扫码可以获取本文就来具体介绍一下ComfyUI是什么?为什么好?怎么
AI漫剧是AIGC在垂直内容生产中的关键落地场景,其核心在于多模态语义对齐与跨工具链协同。原理上需解决剧本结构化、角色一致性控制、动作-光影-分镜三重绑定等工程问题。技术价值体现在降低专业门槛的同时提升批量交付稳定性,避免常见‘人物漂移’‘口型错位’‘节奏崩坏’等失效现象。典型应用场景覆盖小说IP改编、自由职业接单及设计师转型AI内容生产。本实践以番茄热榜选题校验为起点,依托豆包的剧本逻辑解析、C
AI自动化工具正在重塑UI设计的工作方式,从需求分析、界面生成到视觉还原与交付,传统手工作业逐步被可编排的智能流程取代。理解这些工具的原理与协作方式,是提升设计效率的关键。在2026年的设计链路中,AI生成式UI工具负责从0到1的初稿探索,Figma作为组件化设计系统与协作中台,ComfyUI批量产出风格一致的视觉素材,Storybook与Playwright通过自动截图对比守护视觉还原度,而n8
AI视频生成是当前AIGC领域的重要技术方向,其核心在于将文本、图像与动作逻辑转化为连贯视听内容。原理上依赖多模态对齐、时序建模与可控生成三大技术支柱,技术价值体现在降低专业创作门槛、加速内容工业化生产。典型应用场景包括网络漫剧、教育动画、广告短视频等需高频迭代视觉叙事的领域。本文聚焦零基础用户可实操的AI漫剧落地路径,以即梦实现快速动作验证、豆包驱动结构化分镜与提示词生成、剪映完成精细化节奏与表
从一句剧本到一部短剧,AI生成技术正在改变内容创作的门槛。本地部署AI模型无需依赖云端服务,可兼顾隐私保护与成本控制。利用文本模型进行分镜设计、图像模型生成画面、视频模型赋予动态效果,再通过语音合成与剪辑工具完成成片,构成完整的自动化创作链路。这种技术方案适用于短视频创作者、剧本开发者与独立制作人,在概念预览与教学演示等场景中具有实用价值。本文以夜间便利店场景为例,梳理本地AI短剧生成的关键环节与
本文介绍了如何在星图GPU平台上自动化部署Qwen-Image-2512-ComfyUI镜像,实现高效AI图片生成功能。依托该平台,用户可在RTX 4090D单卡上一键启动,4步内完成高清图像生成,典型应用于电商主图批量制作、教育插图自动生产及社交媒体热点海报快速响应等实际场景。
本文提供了两种解决ComfyUI Desktop v0.7.0版本中KeyError: 'tensorrt'错误的方法:首选方案是在C盘程序目录下创建models\tensorrt文件夹(无需修改代码);备选方案是手动修改folder_paths.py文件强制注册tensorrt路径,适用于希望将引擎文件存放在自定义目录(如H盘)的情况。文章详细说明了两种方案的具体操作步骤、适用场景及注意事项,并
本文介绍如何利用ComfyUI结合ControlNet与OpenPose,基于用户参数动态生成个性化服装体型参考图。通过API调用实现自动化推理流程,提升电商场景下的尺码匹配体验,降低退货率,推动个性化视觉服务落地。
最近,ComfyUI 宣布对进行首批支持,这一功能的推出无疑是一个令人激动的消息。这意味着用户可以在 ComfyUI 上使用 Black Forest Labs 为 Flux.1 系列所设计的全新 3 系列模型,包括Re dux 适配器、填充模型、ControlNet 模型 和 LoRA(深度和 Canny),这些新增的工具将使得图像生成和编辑的过程更加精准和灵活。
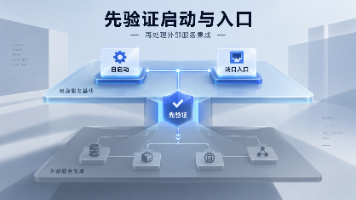
把 ComfyUI 接入机器人、自动化或其他外部服务前,不要把“镜像能访问”和“外部服务能集成”混成同一个问题。本文以已核验的 ComfyUI-v0.3.7 镜像自启动状态和开放端口入口为例,拆解第一层基线验证应该回答什么、不能推出什么,以及什么时候才值得进入外部集成排查。
从AI视频生成到短剧工业化生产,AI工作流编排成为提升效率的关键。ComfyUI以节点化方式管理复杂模型调用,支持文生图、视频生成、角色一致性控制等环节的可视化编排;Skills系统在此基础上封装标准化“技能”,实现按剧目类型一键调用。本文从部署细节出发,涵盖zip包分发、模型目录配置、典型报错排查(如EOCD、显存不足)、批量处理与LLM联动等工程实践,帮助创作者将散装AI能力整合为一条稳定、可
视频理解是大模型应用的重要方向,但视频帧序列无法直接进入语言模型上下文,需要先解决采帧与表示问题。h3.c 作为 antirez 发布的单文件 C 库,将视频解码、场景检测和关键帧抽取封装为简洁接口,大幅降低了视频预处理门槛。在 Apple Silicon 统一内存架构下,通过 GGUF 量化与 llama.cpp 的 Metal 后端,33B 视觉模型能够在 64GB MacBook 上以 4b
在人工智能应用落地中,本地化推理正成为数据隐私与实时响应的重要解法。ComfyUI作为节点式工作流引擎,擅长生成任务,但面对视频理解等多模态推理时,常需要外部后端协同。此时,一个轻量级的HTTP回调机制尤为关键。h3.c作为零依赖的C语言HTTP库,可通过ctypes嵌入Python进程,以极快启动速度和极低资源占用承担本地回环服务,将ComfyUI节点与llama.cpp推理进程高效桥接。借助A
AI短剧并非依赖单一超级模型,而是一条涵盖剧本分镜、文生图、视频生成、TTS语音合成、剪辑质检的完整生产链路。随着创作者涌入,如何通过工程化手段将分散的AI能力组织成可复用的流水线,成为决定成片质量与成本效率的关键。本地部署环境涉及显存、CUDA、模型文件与工作流管理,以ComfyUI为代表的节点式框架为批量生产提供了技术基础。API接口与任务队列支持规模化生成,但需处理并发控制、失败重试与资源监
把 ComfyUI 接入机器人、自动化或其他外部服务前,应该先把“镜像自身是否可访问”和“外部服务是否可集成”拆成两个验证层。本文只讨论第一层:如何根据具体镜像的启动方式和开放端口入口建立最小服务基线,以及这一结果能证明什么、不能证明什么。
本文介绍了如何在星图GPU平台上自动化部署DeOldify图像上色镜像,并利用ComfyUI搭建可视化AI工作流。该方案能一站式完成老照片的智能上色、超分辨率放大及面部增强,显著提升历史影像修复的效率和效果,适用于家庭相册数字化、历史资料复原等场景。
ComfyUI
——ComfyUI
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 北京朝阳AI社区


 openEuler 社区

 乐奇 Rokid 开放社区




 火山引擎视频云技术社区


 DAMO开发者矩阵