- @qq_40206371


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
自定义配置类的要点:必须继承自,以继承等功能;构造函数__init__()必须接收任意**kwargs并传给父类;添加model_type属性,以支持 AutoClass;可以加入参数校验逻辑。
解决方法是在.bashrc文件中添加如下一行文字(如果没有.bashrc文件,就在root中新建一个这个文件)也就是安装anaconda3的路径。然后退出编辑,在命令行中敲入。
在解释NII(NIFTI,neuroimaging information technology initiative)格式之前,我们需要先知道一下Analyze格式。每一个Analyze格式的数据包含了两个文件:带有二进制图像信息的.img,包含图像元数据的头文件.hdr但是,Analyze的头文件不能很真实地反应元数据(比如没有方向信息,eg在左边还是在右边),于是NIFTI格式文件应运而生n
评估 UniTraj 在不同轨迹相关任务(如轨迹恢复、预测、分类、生成)中的适配与泛化能力。将原始 GPS 点与道路网络进行对齐,从而提高轨迹的几何准确性。增强数据多样性,使模型暴露于多种采样频率,提高鲁棒性和泛化能力。短轨迹则可能在采样不足时丢失重要信息,难以学习有效表示。长轨迹可能数据冗余、计算负担重、易过拟合;根据历史轨迹预测未来点(共 5 个点)无微调(wo/ft):只训练分类头;仅使用编

它用于将参数转换为数值类型这个函数尤其适用于在数据清洗过程中,将数据集中的字符串或其他类型的列转换为数值型数据。

用于将数据系列或数据框中的数据按指定的位置移动。这对于某些时间序列分析特别有用,例如计算数据的变化量或滞后值。
比如这样的两个区域,我们想知道从蓝到绿、从绿到蓝都有哪些边。

鸡尾酒排序算法是对冒泡排序算法的优化,它的复杂度和稳定性和冒泡排序算法是一致的,时间复杂度为O(N^2),空间复杂度为O(1)【虽然轮次减少,所以所需时间会比冒泡算法稍微少一些】需要7轮(即使2~8已经排序完成了,但也需要一个一个冒泡到相应的位置去)那么鸡尾酒算法第二轮结束的时候已经排序完成了,比冒泡排序少了很多轮。第二轮,则从右向左进行比较、交换。
1 基本使用方法DataFrame.agg(func=None, axis=0, *args, **kwargs)在指定轴上使用一项或多项操作进行聚合。不同于numpy的聚合函数,agg只能在某一个特定的轴上执行2 参数说明func用于聚合数据的函数可以支持的类型有:字符串函数名称函数(lambda形式等)函数列表列名称:函数名称列名称:函数列表axis0,应用于每一列 a[...
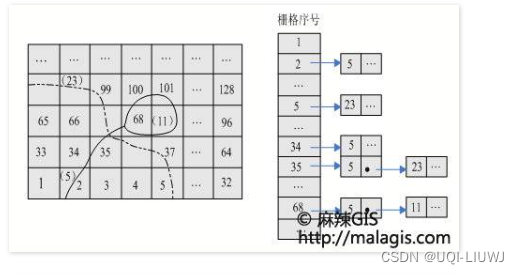
在二维网格下是这样的。