- @m0_52911108


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
环境最好还是自己动手配置,别人配置的话不好排查错误。以及对文件哪些部分进行了改动,这些东西都要留档,方便回滚,要养成好习惯。t=O83At=O83At=O83Aopen_clip.create_model_and_transforms 加载本地模型_clip 加载本地bin或pt-CSDN博客https://blog.csdn.net/zengNLP/article/details/1356444
本文提出了AI-Guardian框架,本质是让模型预测结果受到后门控制,而很难被攻击者操纵,从而抵御对抗攻击。在模型训练阶段,AI-Guardian会针对原始训练样本生成一批后门样本(经过后门处理的样本),按标签双射关系为后门样本分配对应标签,实现后门注入;在模型预测阶段,AI-Guardian先对输入数据进行后门处理,然后将其输入到模型,根据模型输出结果、标签双射关系返回对输入数据真实标签的预测
我们介绍了一种新的越狱攻击方法,针对使用对齐的大型语言模型(LLM) 的视觉语言模型(VLM),这种方法能够抵抗仅限文本的越狱攻击。具体来说, 我们开发了一种跨模态对齐攻击方法,将对抗性图像与文本提示配对,通过视觉编码器传递到语言模型,从而破坏其对齐机制。我们的攻击方法采用一种新的组合策略,将对抗性目标图像与普通提示相结合,以诱导越狱。因此,大型语言模型会在这种上下文下回答对抗性图像生成的提示。生
(1)对抗性流量规避效果:在无对抗流量的情况下,NIDS模型在检测大多数攻击类型时表现良好,而引入ProGen生成的对抗流量后,各模型的F1分数显著下降。(2)真实度的影响:ProGen通过约束条件生成的对抗流量在真实性方面表现更好,尤其是在HR约束下,生成的流量在到达时间分布和有效载荷长度等方面与良性流量更加接近。对抗流量的规避效果通过检测恶意流量被归类为良性流量(S数)的频次来衡量,真实度则通

警告:本文包含具有攻击性的数据、提示和模型输出。最近,将视觉集成到 大型语言模型(LLM)中的兴趣激增,典型代表是 Flamingo 和 GPT-4 等视觉语 言模型(VLMs)。本文揭示了这种趋势的安全性和安全隐患。首先,我们强调,视觉输入的连续性和高维度性使其成为对抗性攻击的薄弱环节,代表了视觉集成 LLM 的扩展攻击面。其次,我们指出,LLM 的多功能性也为视觉攻击者提供了更广泛的对抗性目标
ICLR 2021仍旧看图理解文章作者的做法是把图像进行切分,每一个切分的块进行线性排布,输入线性映射层,加上位置编码、分类头特殊token,然后把embedding结果输入Transformer块中,最后经过一个MLP进行分类识别。输入图像 → 分块 (patch) → 展平 → 线性投影 (Patch Embedding) → 添加位置编码 → [CLS] token 拼接 → Transf


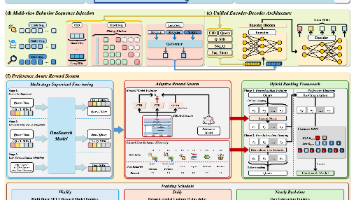
模块解决的问题KHQE:关键词增强的层次量化编码如何把商品/查询编码成适合生成模型预测的 Semantic IDsMu-Seq:多视角行为序列注入如何让模型理解用户短期兴趣和长期偏好如何把搜索建模成端到端生成任务PARS:偏好感知奖励系统如何让生成结果既相关,又符合点击、购买、转化偏好。
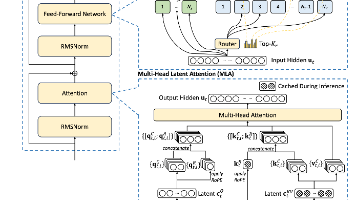
核心亮点:多头潜在注意力机制MLA、DeepSeek MoE架构、多Token预测训练目标MTP这张图其实已经可以比较清晰地说明MLA和MoE架构了。对于MLA,主要的策略是把输入的hiddenstates进行降维,使得KV Cache的量更小,需要运算的时候再升维处理。MoE则是添加了Router,来决定当前token的隐状态走哪些公开的专家头,以及所有token一定都会走通用的专家头。
这样模型在推理时,就能一边读上下文,一边把当前上下文压进这部分权重里。用现有 MLP 的 Wdown 充当可在推理时更新的 fast weights,用面向 next-token prediction 的目标把当前上下文压进这块参数里,并通过 chunk-wise + prefix-sum 的方式把这个动态更新过程做成严格因果且可并行的机制。