登录社区云,与社区用户共同成长
邀请您加入社区
家具增至50件后转视角卡顿,根源不在GPU,而在节点过多、纹理重复、无效渲染与每帧冗余计算。通过建立性能监控,发现瓶颈在于不可见对象渲染、重复材质占用内存及频繁逻辑更新。优化策略包括:启用视锥体裁剪隐藏远端物体、共享相同材质纹理、仅在状态变化时更新逻辑,并在页面销毁时释放资源。关键在于先测数据、再针对性优化,实现流畅体验。
多设备并发的核心是"隔离"。每台设备一个独立Session,自己的任务队列、自己的状态、自己的重试。一台设备慢或失败,不影响其他设备。工程上最容易翻车的是把所有设备的任务放一个队列里,一台卡住全部卡死。分开以后,用Promise.allSettled并行跑,谁慢谁自己等,不拖别人。下一篇做工程收尾:异常恢复、状态机、资源释放。
BqLog 是一个轻量级、高性能的工业级日志系统,已在线上广泛应用于《王者荣耀》等项目。 BqLog 2.x 正式发布! 新增纯血鸿蒙、Python 与 Node.js 支持,并带来非对称混合加密能力。🚀 在 Benchmark 中,BqLog 压缩日志模式比 fmtlog 快 2–3 倍、quill 快 3–6 倍、spdlog 快 3–16 倍、Log4j2 快 10–12 倍、glog 快
在机器人竞赛(如 FTC / FRC / 电赛)、无人机高精度对准降落以及工业 AGV 仓储导航等场景中,AprilTag 3凭借其亚毫米级的定位精度和鲁棒性,成为了空间位姿估计的绝对标配。然而,在边缘计算设备上,AprilTag 的 CPU 算力开销极为沉重。以国内备受关注的高性能 RISC-V 芯片——嘉楠勘智 K230(搭载平头哥玄铁 C908 双核,最高主频 1.6 GHz,硬件支持 RI
游戏启动慢往往不是单个函数慢,而是引擎初始化、资源校验、脚本装载、着色器准备和首场景构建叠加。鸿蒙内核应用快启把可复用的稳定运行状态沉淀为快照或内存镜像,在满足恢复条件时缩短重复初始化链路,但恢复后的一致性验证仍由应用负责。
本文深入探讨ijkplayer在移动音视频开发中的架构设计与性能优化策略。作为基于FFmpeg的强大播放器,ijkplayer通过模块化设计支持硬解码与软解码,并提供灵活的内存管理、渲染调优及二次开发能力,助力开发者应对直播、点播等复杂场景的性能挑战。
本文详细介绍了在Vue项目中优化FLV直播流从单屏到六屏播放性能的实战经验。通过xgplayer-flv.js的深度配置、动态实例内存管理、CSS渲染优化等关键技术,有效解决了多屏场景下的卡顿和内存泄漏问题,为监控视频等需要多屏播放的场景提供了可行的解决方案。
本文详细探讨了Qwen 2.5-VL视频抽帧模块的性能优化实践,对比了Decord和FFmpeg在不同场景下的表现。通过批量帧读取、硬件加速解码等技术手段,显著提升了视频处理效率,为多模态大模型的视频内容理解提供了实用解决方案。
本文详细解析了SRS 4.0流媒体服务器在WebRTC一对一通话中的性能调优策略,涵盖核心参数配置、网络传输优化及高级架构设计。通过NACK/TWCC机制调优、UDP缓冲区调整和自适应码率控制,显著提升通话流畅度与稳定性,适用于实时音视频通信场景。
本文深入剖析视频直播美颜SDK接入中的7大性能优化问题,包括GPU过载、内存泄漏、多线程调度等,并提供实战验证的解决方案。通过分帧处理、设备分级适配、功耗监控等技术手段,显著提升美颜效果与性能平衡,助力开发者打造流畅稳定的直播体验。
本文详细介绍了如何基于ijkplayer打造企业级播放器SDK,涵盖FFmpeg定制化编译、性能调优及跨平台优化策略。通过精简编解码器、优化硬件加速和架构升级,显著提升播放器性能与稳定性,适用于超低延迟直播、DRM加密等复杂场景。
DNS 检测、IP 检测、WebRTC 检测,是网络排障里非常实用的三类基础工具。它们关注的不是同一个问题:DNS 检测:看域名被谁解析、解析到哪里IP 检测:看网站看到你的公网出口是谁WebRTC 检测:看浏览器是否暴露额外网络地址本文从工程排障角度拆开解释这三类检测分别有什么用、能发现哪些问题、不能说明什么,以及遇到网页访问异常、账号环境异常、地区识别异常时,应该按什么顺序使用。
摘要 稳如狗加速网络工具箱是一套集成化网络检测工具,旨在帮助用户快速定位常见的网页访问问题。该工具箱包含七个核心模块:我的IP(公网身份确认)、IP查询(地址归属分析)、DNS解析检测(域名记录查询)、DNS出口检测(解析路径追踪)、WebRTC检测(浏览器通信分析)、网速测试(传输质量评估)和全球延迟测试(跨区域连通性检查)。通过分层检测设计,用户可依次排查网络身份、域名解析、浏览器行为、传输质
在嵌入式系统开发中,实时音视频处理是融合硬件、驱动、算法与系统资源的综合性挑战。其核心原理在于对有限的计算、内存与带宽资源进行精打细算,通过合理的软硬件架构设计,确保数据流的实时性与稳定性。这项技术的价值在于能将复杂的多媒体功能部署于资源受限的微控制器(MCU)上,广泛应用于智能家居、工业视觉、物联网音视频终端等领域。要实现这一目标,开发者需系统性地掌握从芯片选型、内存带宽评估、实时操作系统(RT
实时音视频通信技术基于WebRTC等协议实现端到端低延迟传输,其核心原理是通过UDP协议结合前向纠错(FEC)和重传(ARQ)机制保障数据传输的实时性。该技术的核心价值在于能够在网络波动环境下保持音视频流畅性,广泛应用于在线教育、视频会议等场景。本文聚焦SFU架构选型与编解码器优化,通过Mediasoup实战演示如何构建高可用的音视频系统,特别针对移动端H.264编码和Opus音频的带宽自适应策略
「多媒体文件发布及管理平台v1.0」作为 HoinWare 在数字化内容管理领域的旗舰新品,该平台面向学校、企业、政府机关等各类单位,提供从内容管理、权限管控、数据洞察到客户端检索的一站式解决方案,助力单位构建安全、高效、有序的多媒体资源体系。软件支持局域网内1000+客户端大并发访问,支持海量文件管理、VOD视频点播、内容检索一站式服务,一键运行完成部署。
美颜SDK作为实时图像处理的核心组件,通过人脸检测、特征点定位和图像增强算法实现磨皮、瘦脸等效果。其技术原理涉及计算机视觉和GPU加速渲染,在直播电商和社交平台中直接影响用户留存与转化率。主流方案采用Metal/Vulkan底层优化或多线程CPU加速,需平衡1080P延迟、内存占用等性能指标。开发者在选型时应关注动态分辨率适配、跨平台一致性等工程实践要点,结合DAU计费或买断制等商业模型决策。随着
我叫 NASM,是二进制江湖里横跨各派、冷眼看戏三十年的硬核老兵。1996年我为打破微软MASM等门阀垄断而生,凭纯粹的“中括号语法”和独创的16/32位无缝切换机制,成为早期Linux与FFmpeg等开源神作的拓荒孵化器。虽历经宏崩溃与架构断层的青年危机,但我凭 2.00版本彻底刮骨疗毒,全面重构宏引擎并制霸64位架构与现代扩展指令集。如今面对AI时代,我再度进化支持 AVX-512与AMX矩阵
Jev 的本质:不生成文本的"判断模型",输入状态 + 类型化问题,输出结构化答案 + 概率 + 置信度为什么快:不做自回归解码,输出空间提前定死,能并行采样 —— 从"写作文"变成"涂答题卡"三种原语Noul(是非 + 概率)、Choice(单选,≤255 项)、Score(2~10 级打分)Java 接入:手搓 HTTP → 社区 SDK → Spring Boot Starter → Spr
同样是打开一个网页,为什么在电脑上流畅自如的操作,到了手机上却频频误触?为什么桌面端能同时打开二十个标签页处理复杂任务,移动端却连多窗口都显得捉襟见肘?桌面端和移动端浏览器看似只是"同一个浏览器的不同版本",实则从底层架构、交互逻辑到使用场景都存在根本性差异。本文将从屏幕空间、交互方式、性能约束、网络环境、使用场景五大维度,深度剖析桌面端与移动端浏览器的差异化需求与设计侧重,帮助开发者理解"跨端适
本项目基于国产化软硬件栈(鲲鹏920、昇腾910B、openEuler、MindSpore),构建全链路信创语音识别平台,采用Conformer+CTC架构,实现客服录音批量转写与300路并发流式识别,支持热词优化、小样本微调与INT8量化,达CER≤6.5%、RTF<0.45。通过MindSpore原生适配,训练效率提升显著,推理性能稳定,三年TCO降低40%以上,实现从训练到部署的自主可控闭环
mindspore.dataset是专为大模型设计的高性能数据处理引擎,支持文本、图像、多模态数据的全流程预处理。其基于C++后端加速、多线程并行与流水线调度,实现数据加载、清洗、分词、编码、截断、填充、掩码生成等操作的高效并行执行,显著提升训练吞吐。通过链式变换、分布式分片、数据下沉等机制,有效解决“算力空转”问题,适配昇腾AI芯片与鲲鹏服务器。本文结合完整代码实战,系统讲解LLM与多模态预处理
本文基于昇思MindSpore与昇腾NPU,构建了覆盖模型收敛、任务精度、训练性能与硬件指标的全周期评估体系,实现Loss、PPL、单步耗时等核心指标的实时监控与早停控制。结合昇腾硬件特性,提出分层优化策略:通过混合精度、重计算降低显存占用;利用图模式融合、数据下沉提升算力利用率;采用分布式通信优化与梯度累积支持多机训练。配套提供可落地的工程代码,形成“评估—诊断—优化”闭环,有效解决大模型训练中
MindSpore Transformers为昇腾NPU提供原生大模型预训练方案,通过静态图编译、自动并行、混合精度与重计算技术,实现7B~13B模型高效训练。支持单机多卡及多机扩展,显存降低60%以上,训练速度提升2~4倍。结合异步数据流水线与优化配置,显著提升吞吐与稳定性,无需复杂改造即可开箱即用,全面释放昇腾硬件性能。
本文系统阐述了基于昇腾硬件与MindSpore框架的大模型预训练数据质量过滤体系。针对噪声、重复、低质等常见问题,提出规则粗过滤、统计特征过滤、相似度去重、模型打分四层递进式过滤架构,结合MindSpore的分布式数据流水线能力,实现TB/PB级语料高效清洗。通过完整代码示例与工程优化建议,构建端到端、可扩展、高可靠的过滤链路,从源头保障大模型训练数据质量,提升模型性能与安全性。
MindSpore通过Callback+日志收集+MindInsight可视化构建了大模型训练的在线监控体系,支持每步采集loss、lr、梯度、权重及NPU资源使用情况,自动保存最优模型并异常中断。MindSpore Transformers封装开箱即用组件,结合昇腾NPU适配,实现训练过程实时监控与可视化分析,显著提升训练稳定性与效率。
昇腾RAG SDK通过智能语义分块、多表征索引、分层架构与NPU原生加速,实现检索精度提升30%、构建速度提升8倍、存储成本降低60%。其四层优化架构深度融合算法与硬件,支持百万级文档毫秒级检索,显著解决大模型幻觉、知识滞后等落地难题,为行业提供高效、低成本的知识增强方案。
本文介绍MindSpore Transformers如何解决大语言模型(LLM)训练中的算力与显存瓶颈。通过自动并行、3D并行策略及混合精度、重计算等显存优化技术,实现千亿参数模型高效分布式训练。框架提供统一接口,支持预训练与微调无缝切换,并基于昇腾AI处理器实现单卡训练13B模型、8卡线性加速比达0.97,显著提升训练效率与稳定性。
本文详解SAP SD模块跨系统接口开发,聚焦电商、物流、CRM三大场景。通过RFC入站、OData、IDoc等技术实现订单同步、轨迹回传与客户数据双向交互,重点解析幂等设计、限流机制与数据一致性保障方案,提供完整ABAP代码示例,助力解决前端驱动型接口的高并发、重试与状态同步难题。
围绕 HarmonyOS 7 空间音频节点组合,拆解采集格式、降噪与美化、变声、空间渲染、路由切换、时延和资源释放。
围绕 HarmonyOS 7 沉浸光感效果,拆解能力检测、光随指动、描边、非线性形变、手势采样、深浅色适配与性能降级。
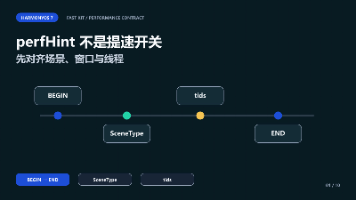
围绕 HarmonyOS 7 FAST Kit perfHint 的生命周期边界,拆解 BEGIN/END、SceneType 与线程集合不对齐时的失效原因,并给出两个可复现案例、代码和验收清单。
本文基于昇腾平台与MindSpore框架,以鸢尾花数据集为例,对比无优化器、SGD、Momentum和Adam四类优化器在神经网络训练中的表现。实验通过搭建简单全连接网络,分析其损失下降趋势与分类精度,揭示不同优化器的收敛特性:SGD震荡明显,Momentum平滑更新,Adam收敛最快且精度最高。结果表明,优化器显著影响模型训练效果,实际应用中推荐优先使用Adam。
互补性:LLM擅长语言理解和知识推理,HTN擅长约束满足和可解释执行,两者天然互补两种融合方式LLM生成 + HTN验证(LLM作为方法生成器)LLM建议 + HTN约束(HTN作为LLM的约束框架)主要挑战:幻觉问题、符号接地、实时性限制、验证复杂性应用前景:在航天任务规划、机器人控制、智能助手等领域有广阔前景。
# 小结电商网站的技术成色不在首页,而在四个地方:商品模型能不能支撑业务演进、订单支付的状态机与幂等是否严谨、大促并发和资金安全有没有量化验证、数据与账号是否真正属于甲方。SPU 描述商品公共属性(如「某品牌 T 恤」),SKU 承载可售卖单元(颜色+尺码的组合,各有独立价格、库存、编码)。创建订单、支付回调、退款接口都可能被重复请求(用户连点、支付平台重推、消息中间件重投)。状态(待支付、已支付
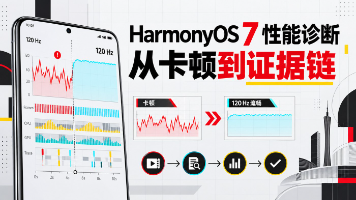
围绕 API 26 应用性能排查,给出从场景复现、指标采集、Trace 定位到回归验收的完整闭环,避免只盯平均 FPS。
围绕 Core File Kit mmap 文件映射,拆解适用边界、页对齐、窗口化映射、生命周期、并发一致性、异常降级与性能验证。
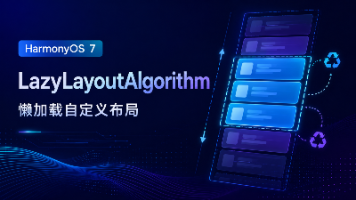
围绕大数据量自定义布局,拆解可视区计算、索引估算、按需测量、稳定Key、尺寸缓存与失效重算。
性能优化
——性能优化
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 人工智能6S服务平台


 DAMO开发者矩阵


 火山引擎视频云技术社区






 openEuler 社区
 AtomGit AI 社区
 EazyDevelop社区


 快递鸟社区
 HarmonyOS开发者社区