- @Jamence


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
int n, G[maxn][maxn], c[maxn], topo[maxn], t;/**n表示邻接表的个数,*c[]表示状态,为1表示访问过,为0表示未访问,为-1表示正在访问*topo表示排完序的拓扑序列*/bool dfs(int u){c[u] = -1;for(int v = 0; v < n; v++) if(G[u][v]) {if(c
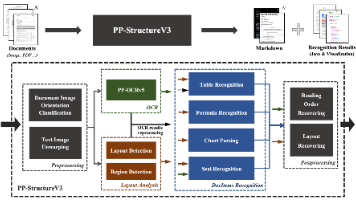
PP-StructureV3
相较于PCIe接口,具备提供更高的带宽和更低的延迟,更好的稳定性和可靠性,常用于高性能计算和数据中心。在显卡配置中,PCIe一般指PCIe接口,是服务器实现IO扩展的关键,PCIe接口除了用于插PCIe的GPU卡外,也可以广泛用于Raid卡、网卡、HBA卡等。常见的显存类型,具有较高的带宽和较低的延迟,适用于大多数显卡,如NVIDIA的GeForce系列和AMD的Radeon系列显卡。NvLink

➡️ 研究动机:为了全面理解MLLMs的能力和局限性,并为未来的安全防护提供有价值的见解和方法,研究团队提出了第一个综合评估框架(Comprehensive Evaluation Framework, ChEF),旨在全面评估每个MLLM,并公平地比较不同的MLLMs。➡️ 研究动机:现有的多模态大型语言模型(MLLMs)在处理不同模态的任务时,存在模态干扰的问题,即不同模态之间的信息可能会相互干
然而,现有的数学基准测试主要集中在评估MLLMs的问题解决能力,而忽略了更复杂的场景,如错误检测,这在教育场景中尤为重要。➡️ 研究动机:为了克服这一限制,研究团队提出了一种新的方法——MLLM As ReTriever (MART),通过利用交互数据来微调MLLM检索器,使其能够全面考虑轨迹的有效性,并优先考虑对未见过的任务有用的轨迹。➡️ 方法简介:研究团队构建了一个包含2,500个高质量多模
➡️ 问题背景:多模态大语言模型(Multimodal Large Language Model, MLLM)在视觉语言任务中展现出显著的能力,但现有的通用视觉语言模型(VLM)在医疗视觉问答(Med-VQA)任务中表现不佳,尤其是在处理细微的医学图像时。为了在保持高数据质量的同时最大化数据量,研究团队提出了自适应图像-文本质量增强器(AITQE),旨在动态评估和增强图像-文本对的质量,从而在不显
➡️ 实验设计:研究团队在14个不同的移动UI任务上进行了实验,包括3个来自Spotlight的任务(screen2words、widget captions、taperception)和11个针对iPhone和Android屏幕的双版本任务。现有的基准测试要么设计用于通用多模态任务,无法捕捉网页的独特特性,要么专注于端到端的网页代理任务,无法衡量细粒度的能力,如OCR、理解和定位。此外,该方法还
➡️ 实验设计:实验在VIMA和SimplerEnv两个模拟器上进行,针对LLaRA和OpenVLA两个开源VLAMs模型,设计了不同类型的物理攻击(如模糊、高斯噪声、亮度控制、基于排版的视觉提示和对抗性补丁攻击),并评估了这些攻击对模型性能的影响。➡️ 方法简介:研究团队提出了一种系统的方法,通过构建物理脆弱性评估管道(PVEP),评估了包括分布外(OOD)、基于排版的视觉提示(VP)和对抗性补
➡️ 论文标题:The Curious Case of Nonverbal Abstract Reasoning with Multi-Modal Large Language Models➡️ 论文作者:Kian Ahrabian, Zhivar Sourati, Kexuan Sun, Jiarui Zhang, Yifan Jiang, Fred Morstatter, Jay Pujara
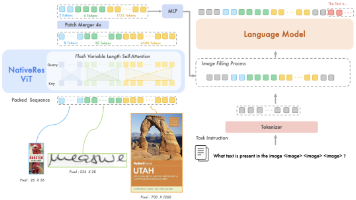
最近(2025年10月)发布的多模态大模型基本采用原生分辨率的图像配置,例如Kimi-VL、Qwen3-VL、Seed1.5-VL等。以Qwen3-VL为例,采用原生分辨率输入,保证输入图像的无损高清。然而,鲜有研究工作去分析图像分辨率、图像宽高比对多模态大模型的影响。北大、上海人工智能实验室等机构的研究人员构建评测集RC-Bench(Resolution-Centric)、原生分辨率多模态大模型