


- @lihuhelihu


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
回归之所以能预测,是因为它通过大量的花瓣长度与宽度数据,“弄懂了”花瓣长度与宽度之间的线性关系,在这个基础之上就可以通过花瓣长度预测花瓣宽度了。通过鸢尾花的花瓣长度与宽度的线性关系来预测花瓣宽度,通过杯子里水的体积就可以知道(预测)水的重量。但是也并非所有“越…”都是线性的,比如“弹簧的弹力与位移的关系”。回归的目的是为了预测,比如在通过鸢尾花花瓣长度预测花瓣宽度。○①若不填或者填0,每次生成的数

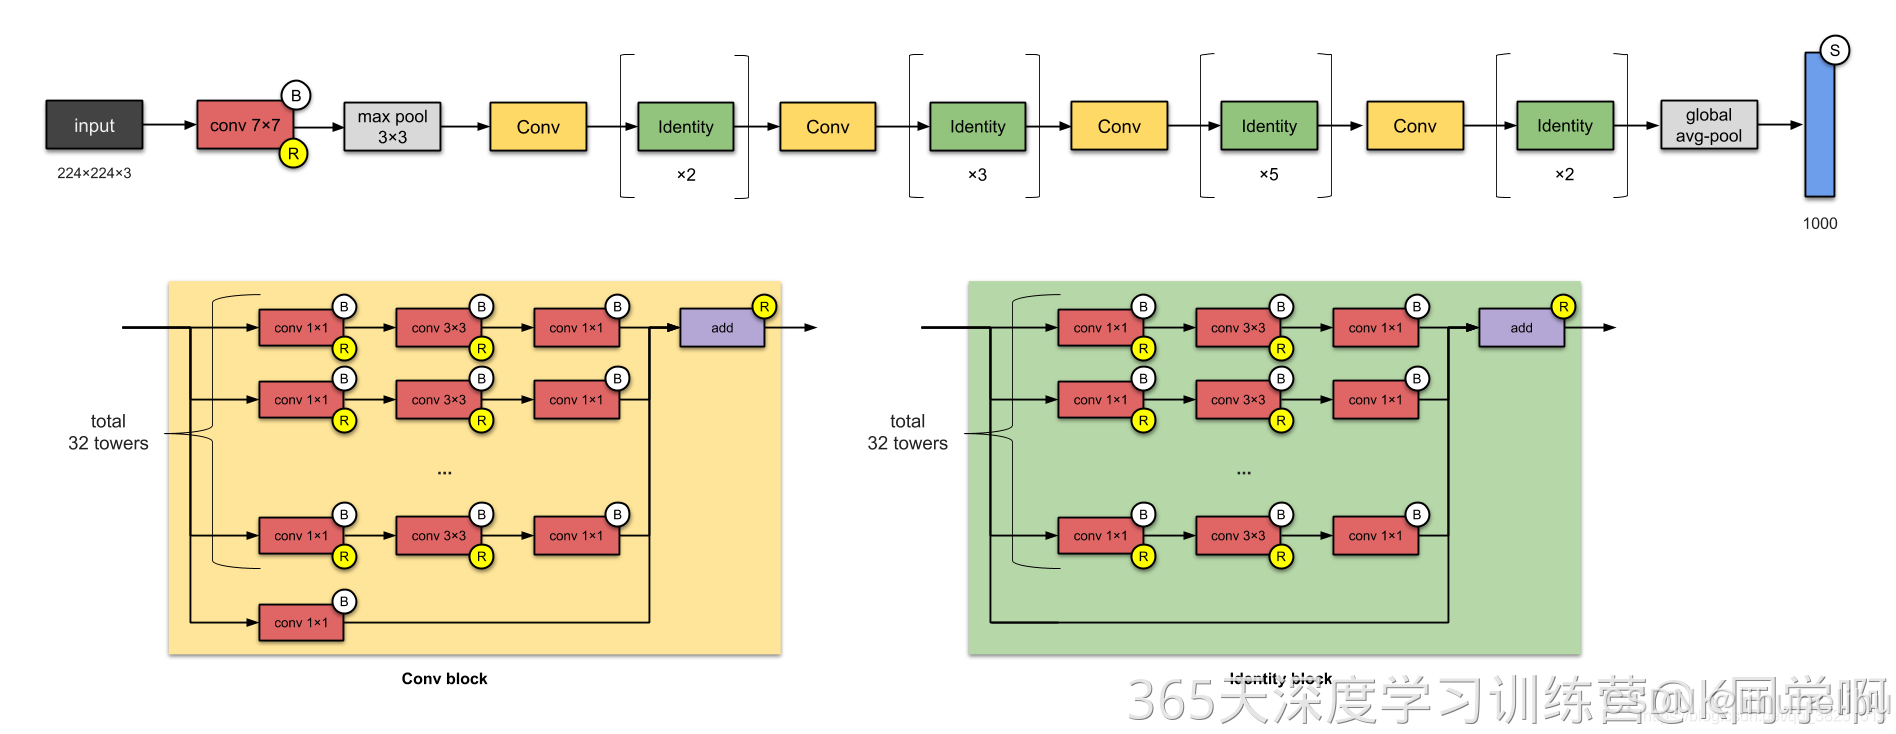
(2)2个block(conv_shortcut=False):conv_shortcut=False,结合代码可知,在进行Add操作时,是直接对输入的x与后续的[(Conv+BN+ReLU)+ 分组卷积 + (Conv+BN) ]的一系列操作后得出的特征图(filters=2。(1)1个block(conv_shortcut=True):conv_shortcut=True,结合代码可知,在进行
集成学习是机器学习中通过组合多个模型(称为)的预测结果来提升整体性能的方法。其主要思想是,多个简单模型的组合通常比单个模型更强大、更稳健。:例如,通过训练多个独立的模型并对其结果进行平均(回归任务)或投票(分类任务),来降低方差并避免过拟合。:例如和,逐步训练模型,每个新模型都试图纠正前一个模型的错误,减少偏差并提高准确度。

Linux运维必备1500+英文词汇1. file [fail] n. 文件;v. 保存文件2. command [kəˈmɑ:nd] n. 命令,指令3. use [ju:z, ju:s] v. 使用,用途4. program [ˈprəugræm] n. 程序5. line [lain] n. (数据,程序)行,线路6. if [if] conj. 如果7. display [disˈplei

lmageSets文件夹下面有个Main子文件夹,其下面存放了 train.txt、val.txt、test.txt 和 trainval.txt 四个文件,它们是通过split_train_val.py 文件来生成的。上面的代码,如果直接在pycharm运行tranin.py,会下载YOLOv5自身的数据集并进行训练,而不是会训练自己提供的数据集,需要对tranin.py进行修改才可以训练自己的

size = len(dataloader.dataset) # 训练集的大小num_batches = len(dataloader) # 批次数目train_loss, train_acc = 0, 0 # 初始化训练损失和正确率for X, y in dataloader: # 获取数据及其标签# 1. 确保输入数据有三个维度,添加一个seq_len维度if X.dim() == 2: #
