登录社区云,与社区用户共同成长
邀请您加入社区
用户管理、商品分类管理、商品管理、商品订单处理、课程管理、课程分类管理、课程订单处理、讨论管理;
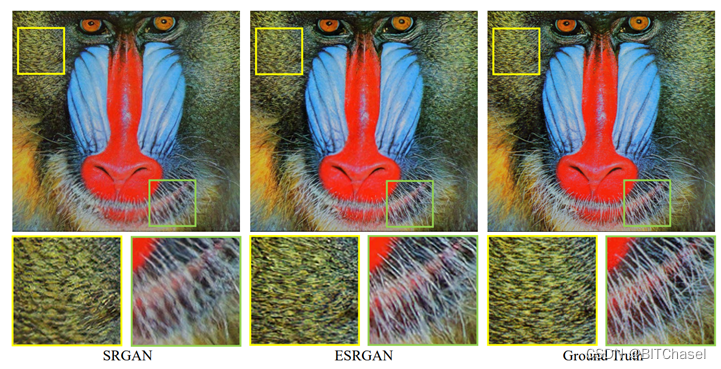
改进判别器,判断“⼀个图像是否⽐另⼀个图像更真实”,⽽不是“⼀个图像是真实的还是假的”。SR-MINC损失,基于⽤于材料识别的微调VGG⽹络 → 纹理感知。无BN层RDDB块,残差缩放,较小初始化,相对GAN → 精细纹理。基于GAN的⽅法会产⽣清晰的边缘和更丰富的纹理,但会出现伪影。激活后VGG改为激活前VGG → 好的清晰边缘,感知质量。,删除批量归一化(BN)→提升容量,简化训练。纯PSNR
Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network基于生成对抗网络的照片级真实感的单一图像超分辨率重建 摘要 尽管使用更快更深的卷积神经网络的单图像超分辨率准确性和速度有所突破,很大程度上仍然存在一个中心问题未解决:我们如何恢复更细的纹理细节当我们使用lar
学习笔记:如何理解扩散模型、图像超分、多尺度
超分辨率(Super-Resolution)就是将低分辨率(low resolution)的图像通过算法提升到高分辨率(high resolution)的过程。超分辨率技术在多个领域有广泛应用,包括但不限于以下几个方面:医疗成像:在医学影像中,超分辨率技术可以帮助提高图像质量,使医生能够更清晰地观察和诊断疾病。安全监控:在安防监控系统中,超分辨率技术可以提高监控视频的分辨率,从而更有效地识别和跟踪
这个Python脚本主要用于评估图像质量,它比较了一组高清(HD)图像和对应的生成图像,并计算了四种不同的图像质量指标:PSNR、SSIM、LPIPS和NIQE。
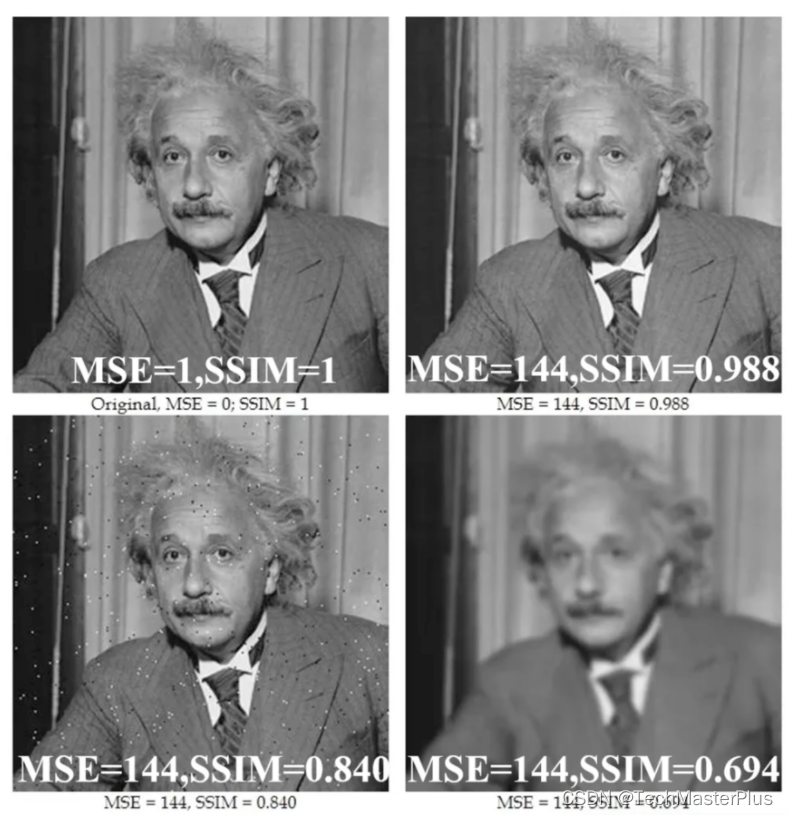
本文主要介绍SSIM的原理和计算公式,并用torch实现SSIM
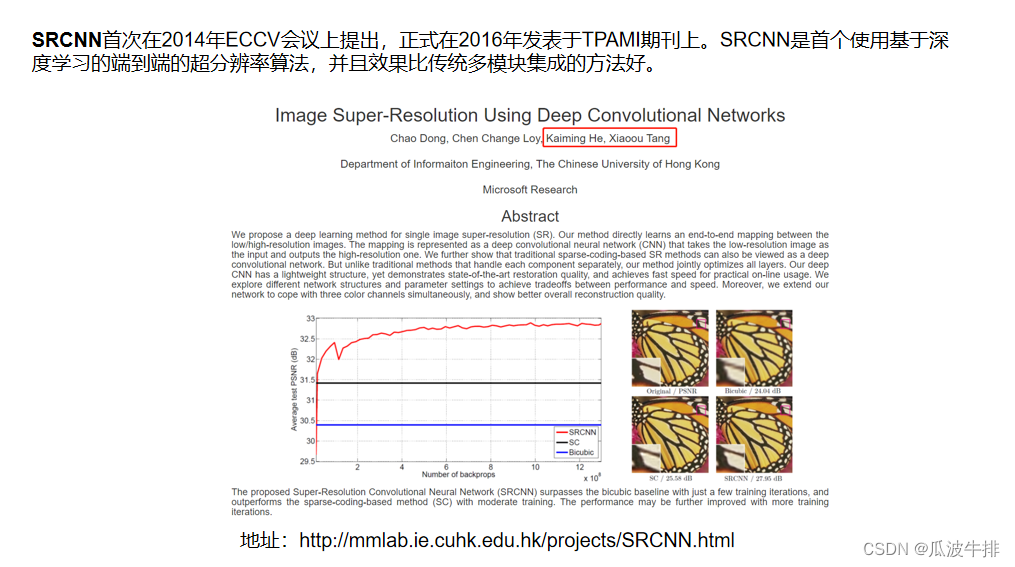
使用SRCNN模型(该领域首个深度学习模型)进行图像超分
在图像处理领域,图像可以被视为一个二维函数,通常表示为fxy,其中x和y是空间坐标,而f在该点的值代表图像的亮度或颜色。对于灰度图像,fxy是一个标量值,表示该点的灰度级;而对于彩色图像,fxy可以是一个向量,包含红、绿、蓝(RGB)或其它颜色空间的分量。
图像增强是图像处理中的一个重要步骤,旨在改善图像的视觉效果或使图像更适合后续的处理和分析。图像增强技术可以分为两大类:空间域增强和频率域增强。空间域增强:直接在图像像素上操作,如点运算(灰度变换、对比度拉伸)、邻域运算(平滑、锐化)。频率域增强:在图像的傅里叶变换域中操作,如低通滤波、高通滤波、带通滤波。盲复原算法是在不知道模糊核的情况下进行图像复原的方法。它通常需要同时估计模糊核和恢复原图像,因
图像复原的目标是尽可能地从退化图像中恢复出原始图像。传统图像复原方法主要包括逆滤波、维纳滤波、约束最小二乘滤波等。盲去卷积(Blind Deconvolution)是一种在不知道卷积核(模糊核)的情况下,从模糊图像中恢复原始清晰图像的图像复原技术。在图像处理中,图像模糊通常是由成像系统中的运动、光学失真或大气湍流等因素引起的,这些因素可以被建模为一个卷积核。盲去卷积的目标是在没有这个卷积核的先验知
本文主要介绍了图像超分辨率重建中的SRResNet算法原理。SRResNet算法是图像超分辨率领域的一项重要创新,它通过引入深度结构、残差学习和子像素卷积等技术显著提升了超分辨率任务的性能,使其生成的高分辨率图像更加真实清晰。
基于插值的图像超分辨算法文章目录基于插值的图像超分辨算法@[TOC](文章目录)一、最近邻插值算法二、双线性插值法1.灰度图2.彩色图三、双三次插值法最近邻插值算法(python)双线性插值算法(python)双三次插值算法(python)基于插值的超分辨率重建方法是通过使用插值函数来估计待插入的像素点的取值。具体来说,先根据已知点的位置、待插值点的位置以及插值函数来计算各个已知点的权重,然后根据
这篇文章网络结构ESRT( Efficient Super-Resolution Transformer)还是蛮复杂的,是一个CNN和Transformer结合的结构。文章提出了一个高效SRTransformer结构,是一个轻量级的Transformer。作者考虑到图像超分中一张图像内相似的细节部分可以作为参考补充,(类似于基于参考图像Ref的超分),于是引入了Transformer,可以在图像中
阅读指引SRCNNDCSCNSRDenseNetSRGAN论文快速指引:SRCNN:Learning a Deep Convolutional Network for Image Super-ResolutionDCSCN:Fast and Accurate Image Super Resolution by Deep CNN with Skip Connection and Network in
这篇文章是2014年的一篇论文,其主要意义在于作者推出的SRCNN是深度学习在超分上开篇之作!SRCNN证明了深度学习在超分领域的应用可以超越传统的插值等办法取得较高的表现力。参考目录:①深度学习图像超分辨率开山之作SRCNN(一)原理分析②深度学习端到端超分辨率方法发展历程SRCNN1 SRCNN简介2 SRCNN模型结构3 Loss function:4 实验4.1 setup4.2 实验结果
基于GAN的小目标检测算法总结(4)——算法总结对比1. 前言2. 3种算法的对比2.1 相同点2.2 不同点3. 一些看法1. 前言 这里是基于GAN的小目标检测算法系列文章的第4篇,也是最后一篇,本文将对前面3种算法进行总结对比,并提一点我自己的看法,受限于个人的局限性,本文内容难免有错误,个人观点也仅作参考,欢迎大家批评指正。本文多要对比的3种算法如下:(1)2017年的CVPR,《Perc
基于GAN的小目标检测算法总结(3)——《Better to Follow, Follow to Be Better: Towards Precise Supervision of Feature Super-Resolution》1.前言2.算法简介2.1 核心idea2.1.1 为什么使用feature-level的超分?2.1.2 低分特征和高分目标特征的相对感受野匹配问题2.2网络组成2.
是一款开源的 AI 辅助数据标注工具,集成了 Segment Anything、YOLO 系列等先进模型,支持目标检测、图像分割、姿态估计等多种任务,兼容 Windows / Linux / macOS 平台。
在python代码中使用opencv-python库时出现报错 ModuleNotFoundError: No module named 'cv2',原因在于没有正确安装opencv或者没有配置正确的解释器,接下来是详细得解决该问题的流程:使用 抠头助手 安装anaconda➡️➡️➡️创建conda环境➡️➡️➡️安装OpenCV➡️➡️➡️安装Pycharm➡️➡️➡️配置Pycharm解释器
Dual Circle Contrastive Learning-Based Blind Image Super-Resolution
python计算psnr和ssim (用于超分辨率)
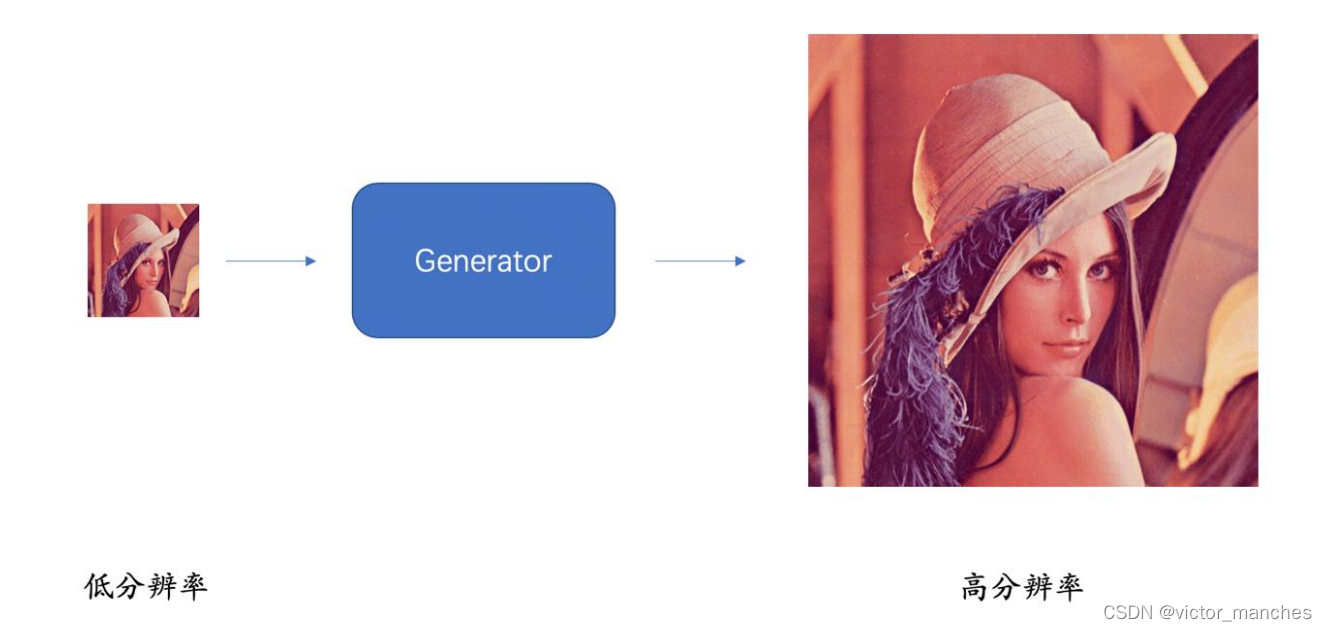
本次案例将使用生成对抗网络来实现4倍图像超分辨任务,输入一张低分辨率图像,生成器会生成一张4倍超分辨率的图像,如图1所示。生成对抗网络选用SRGAN结构[1]。本案例训练集使用DIV2K数据集[2],包含有800张2K左右高分辨率的图像和800张对应的低分辨率图像;测试集使用DIV2K验证集[2]、Set5、Set14、B100、Urban100五个数据集,分别包括高分辨率图像和对应的低分辨率图像
深度学习基本方法功能解释-持续更新
前言英伟达推出的平台:omniverse出了一个新的插件,可以上传一张2D的大头照,快速生成一个3D数字人。我下载软件、下载插件后,测试了该功能,决定写遇到的一些问题和经验总结。硬件要求配置要求:-英特尔i5双核或更高版本-16 RAM或更高-SSD, 10GB或更高可用硬盘空间-显卡:NVIDIA GeForce GTX 900系列-AMD Radeon R7 300系列-视频内存:4GB RA
通道分割与分组处理:将输入特征图按通道分成若干组,每组独立进行注意力计算。二维卷积的位置编码(dwc-pe):通过二维卷积操作生成位置编码,降低参数数量。自适应注意力权重:根据查询区域的特征生成注意力权重矩阵。输出调整与融合:将注意力结果与位置编码进行融合,得到最终的特征图。DAttention作为一种高效的注意力机制,通过引入分组和轻量级的卷积操作,在确保模型性能的同时,显著降低了计算复杂度和参
本文详细介绍了扩散模型的原理与实现方法。首先阐述了扩散模型通过"加噪-去噪"过程实现高质量数据生成的机制,相比GAN具有训练稳定的优势。文章拆解了训练和推理两大核心环节:训练阶段通过噪声预测和MSE损失优化模型;推理阶段从纯噪声出发逐步去噪生成数据。提供了完整的伪代码和Python实现示例,包括噪声预测、损失计算、反向扩散等关键步骤。代码示例涵盖模型训练、采样时间步、噪声预测等
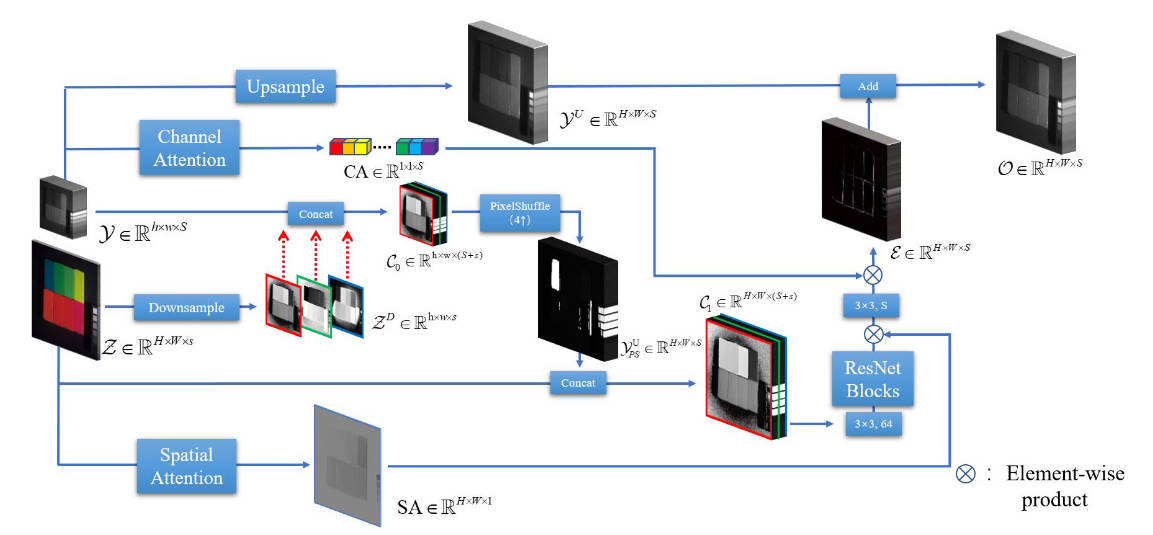
对于高分辨率多光谱(高分辨率意味空间信息更好)图像,采用spatial attention机制进行空间信息的保留,对于低分辨率高光谱(多频段也就是多channel)图像,采用channel attention对于通道数(频段数)进行通道信息保留。引入PixelShuffle模块进行上采样操作在concat阶段,对MS和HS进行交叉concat,使得信息融合更好。
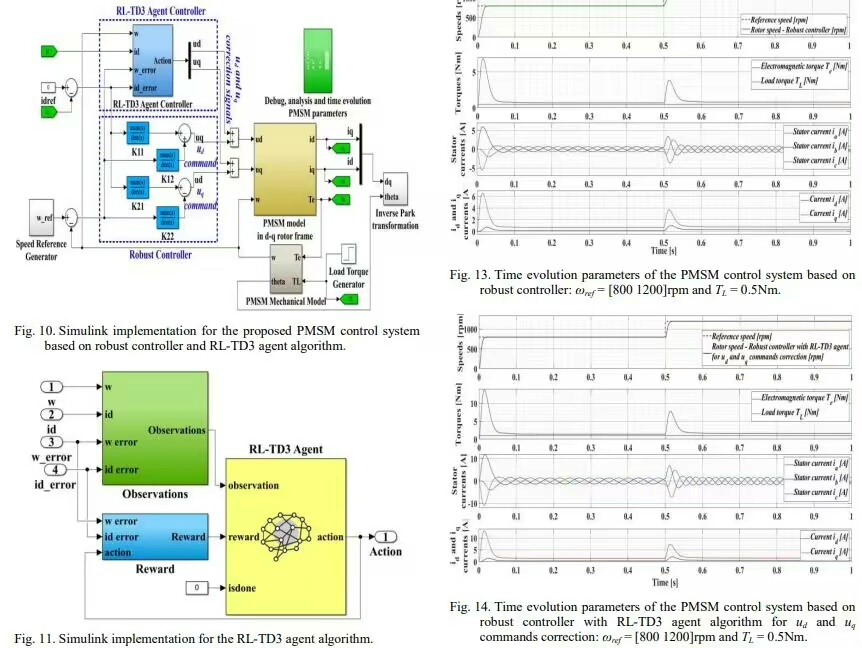
基于强化学习的PMSM磁场定向控制这是关于双延迟深度确定性强化学习策略提取(RL-TD3)在速度与电流控制上的优越性与鲁棒性研究国外SCI-paper模型复现,完全可以二次改进与参考适合高校本科与研究生参考学习在电机控制领域,永磁同步电机(PMSM)因其高效、节能等优点被广泛应用。而磁场定向控制作为PMSM的经典控制策略,不断地在新技术的融入下得到优化。
扩散模型是生成高质量图像和视频的实用方法,但由于计算和优化的挑战,学习高维模型依然是一项艰巨的任务。现有方法通常采用在像素空间训练级联模型的方法,或者使用一个单独训练的自编码器的下采样潜在空间。本文提出了Matryoshka扩散模型,这是一个端到端的高分辨率图像和视频的合成框架。扩散过程即在多分辨率联合对输入进行降噪,并使用将小尺度输入的特征和参数嵌入大尺度输入中的NestedUNet架构。此外,
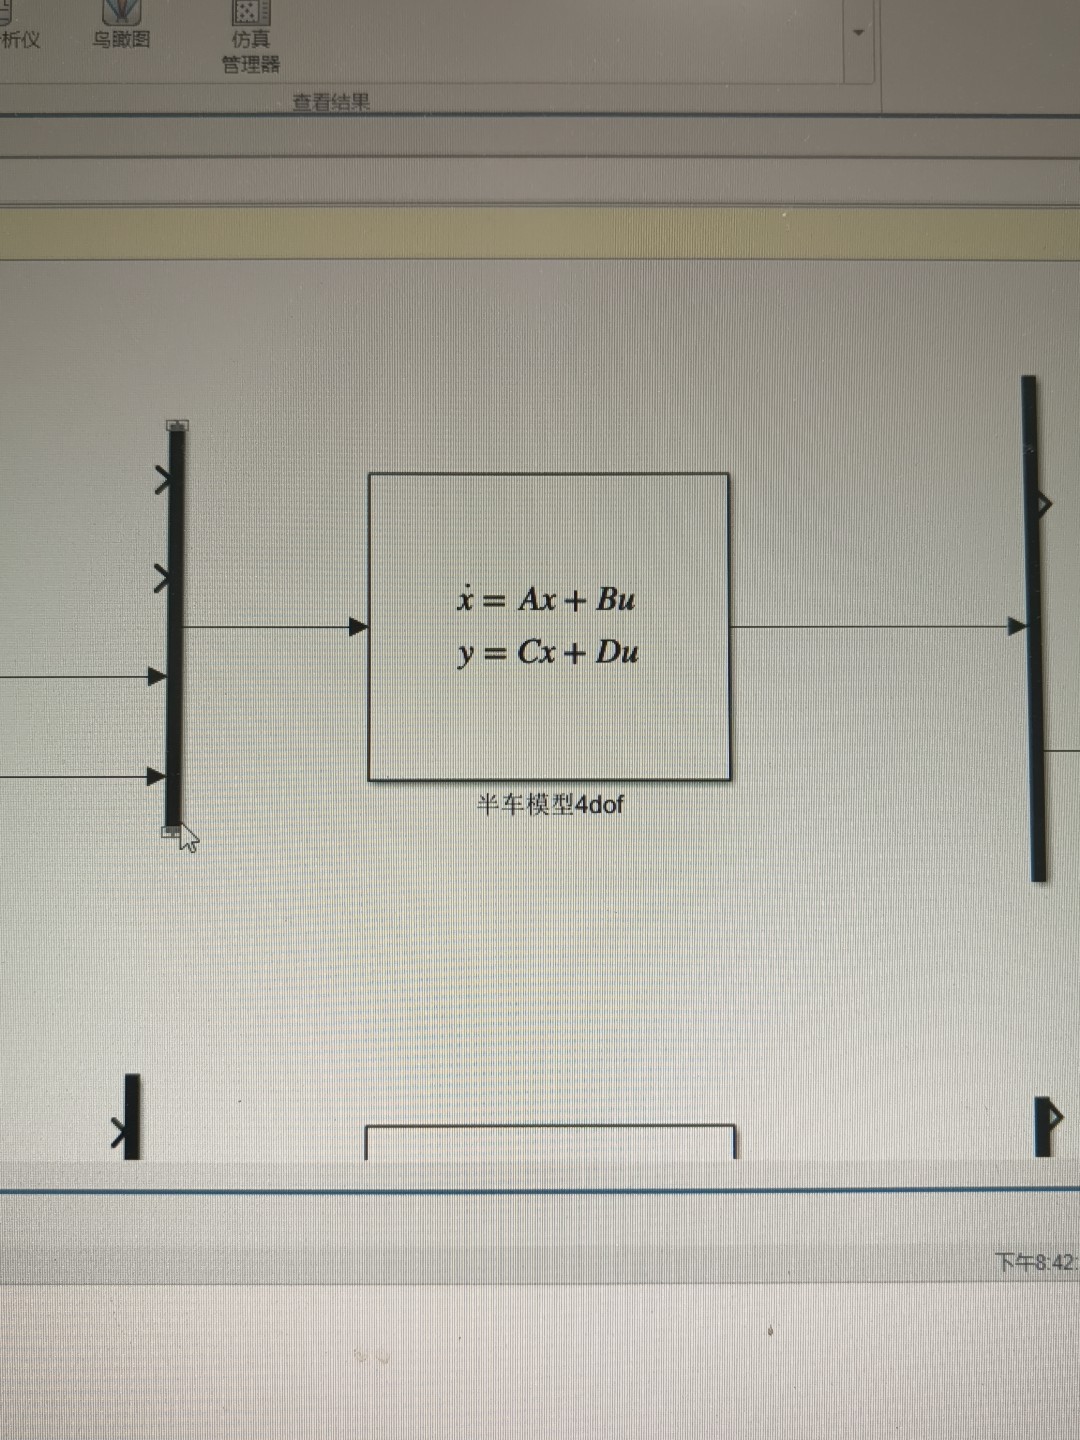
悬架mpc控制程序模型2自由度 4自由度 7自由度在汽车动力学控制领域,悬架系统的精准控制至关重要。模型预测控制(MPC)因其能有效处理多变量、有约束的复杂系统控制问题,在悬架控制中得到了广泛应用。今天咱们就来聊聊悬架MPC控制程序模型中2自由度、4自由度和7自由度模型的那些事儿。
本文提出了一种基于对抗扩散蒸馏(ADD)的高效盲超分辨率方法AddSR。针对现有基于Stable Diffusion的方法效率低下和感知-失真不平衡问题,作者提出两项创新:1)时间步自适应ADD(TA-ADD)损失,通过动态调整权重平衡感知质量与保真度;2)基于预测的自精炼策略(PSR),利用预测噪声估计HR图像以增强高频细节。实验表明,AddSR在保持高质量修复的同时,速度比现有方法快7倍,为基
基于matlab风光柴储混合微电网储能电池系统互补能量管理simulink模型包含风机,光伏,储能,柴油机等系统实现能量相互协调。波形完美,模型质量!在如今追求可持续能源的时代,风光柴储混合微电网凭借其多能源互补的特性,成为解决分布式能源接入与稳定供电问题的热门方案。而其中储能电池系统的互补能量管理则是保障整个微电网稳定运行的关键所在。今天就和大家分享一下如何基于Matlab搭建这样一个Simul
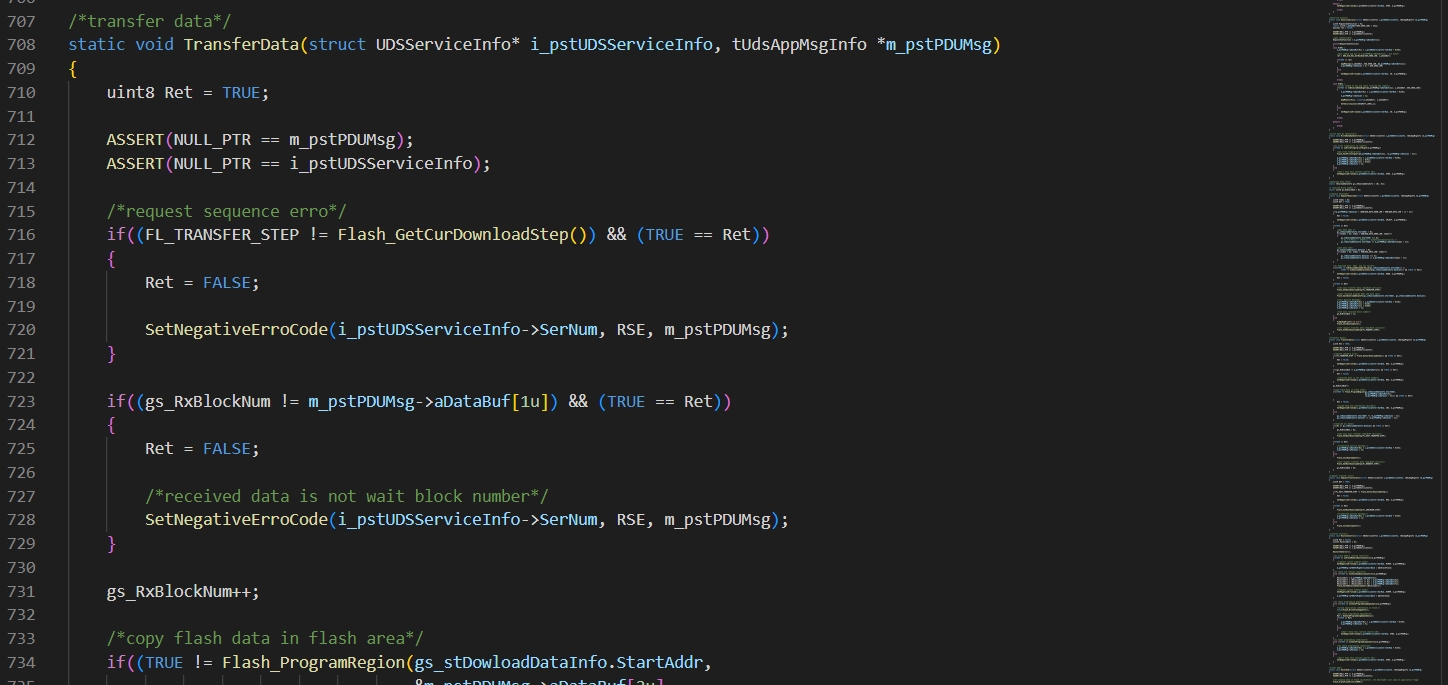
最近在搞S32K144的Bootloader,折腾了好一阵子,总算有点眉目了。首先,S32K144是NXP的一款汽车级MCU,资源丰富,性能也不错。做Bootloader的时候,最头疼的就是Flash的读写操作了。适用与s32k144的Bootloader,符合uds规范,应用于量产项目,制作了独立的flash_driver文件,可直接用于项目中。适用与s32k144的Bootloader,符合u
Canny算子的双阈值设置也是门道,低阈值设0.1避免漏检,高阈值0.5防误报,sigma=1.5让高斯平滑适度保留细节。算法运行环境为MATLAB R2021b,执行一种新的一维时间序列信号变化/事件/异常检测,并给出了若干例子。算法运行环境为MATLAB R2021b,执行一种新的一维时间序列信号变化/事件/异常检测,并给出了若干例子。1的结果图(假装有图),正常段的平稳振荡和异常段的突变在时
针对这一问题,本研究进一步提出了编码器解码器全尺度跳跃连接的增强型循环生成对抗网络,在生成器网络中引入全尺度跳跃连接机制,实现编码器各层特征与解码器各层特征的密集连接,充分捕获细粒度的纹理细节和粗粒度的语义信息。在网络架构设计上,将U-Net网络嵌入循环生成对抗网络的生成器中,U-Net的编码器路径通过连续的卷积和下采样操作提取图像的多尺度特征,解码器路径通过上采样和跳跃连接逐步恢复图像的空间分辨
一、图像超分辨率重建的定义图像超分辨率重建(Image Super-Resolution Reconstruction,简称ISR)是指通过算法将低分辨率图像(Low-Resolution Image,简称LR)恢复成高分辨率图像(High-Resolution Image,简称HR)的过程。这一技术旨在弥补传统成像设备分辨率不足的缺陷,提高图像的视觉质量,拓宽图像的应用范围。二、图像超分辨率重建
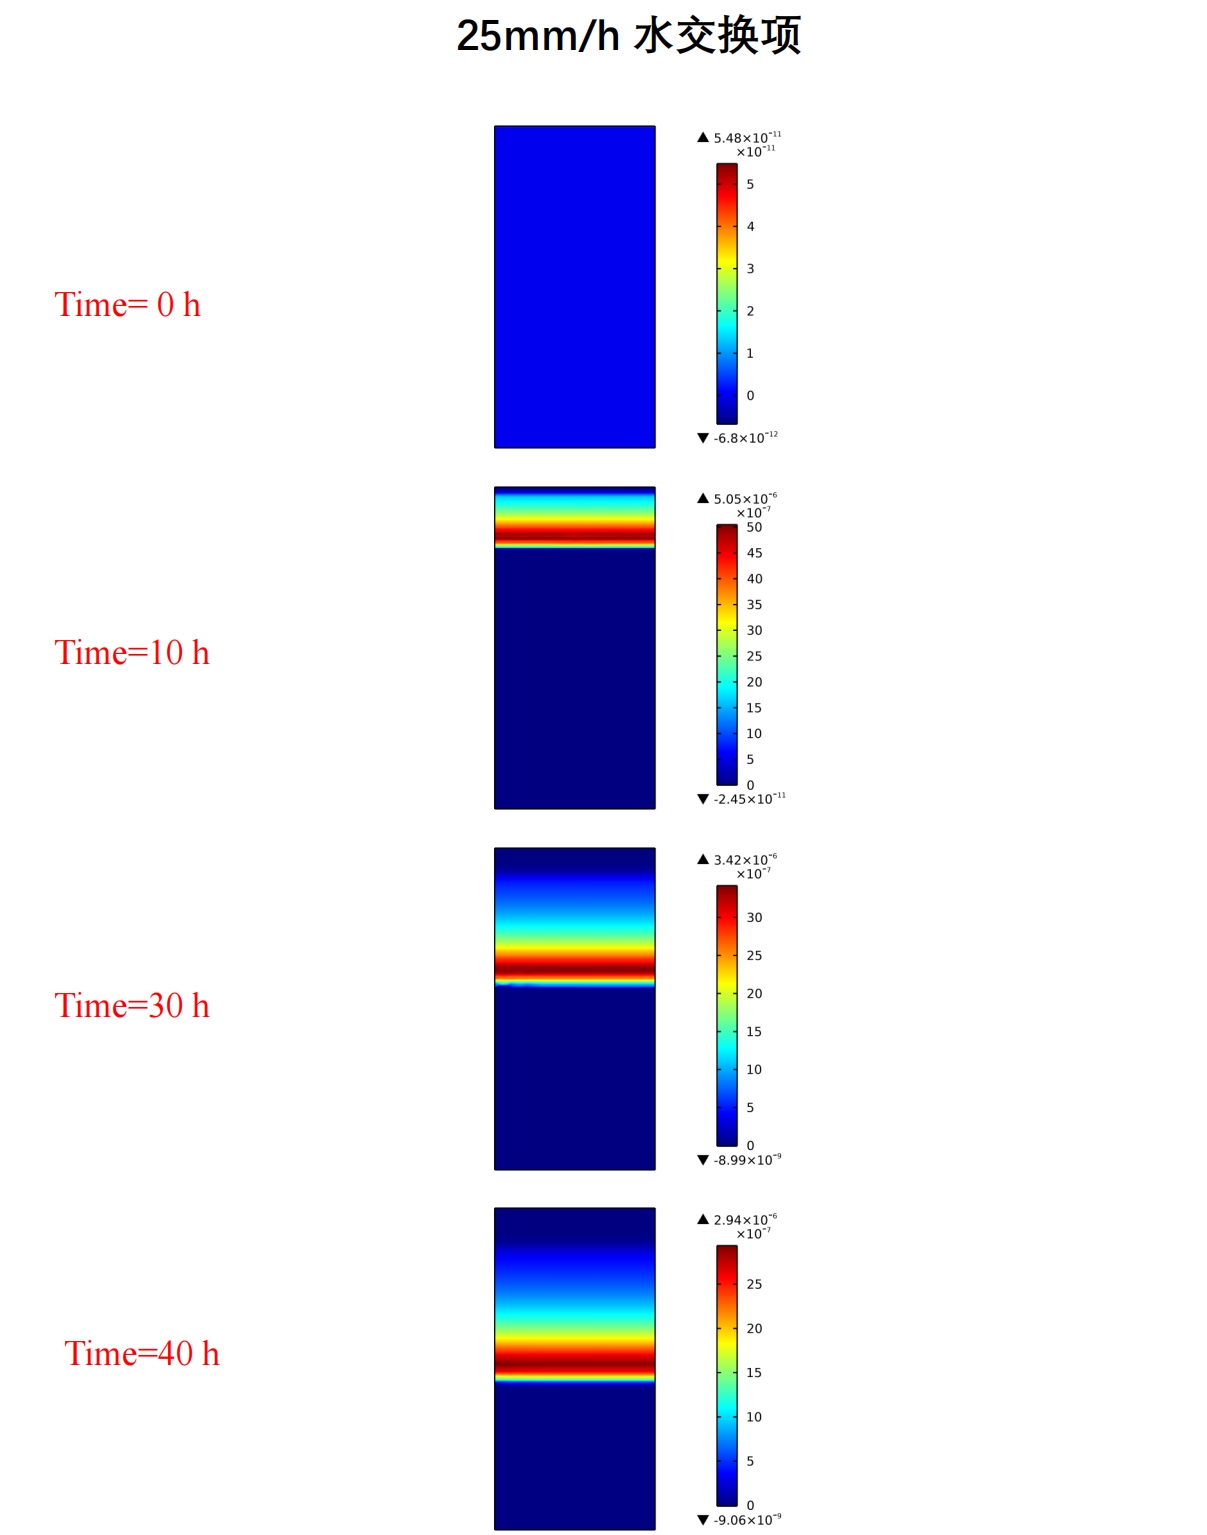
从数值模拟的结果可以看出:当降雨强度较低时,以基质流入渗为主,水交换为从基质到裂隙;当降雨强度较高时,以裂隙流(优势流)入渗为主,水交换为从裂隙到基质。从数值模拟的结果可以看出:当降雨强度较低时,以基质流入渗为主,水交换为从基质到裂隙;当降雨强度较高时,以裂隙流(优势流)入渗为主,水交换为从裂隙到基质。在裂隙发育完全的边坡,可以使用等效法将裂隙平均到基质中,使用两个里查兹方程来方便描述裂隙的渗流情
本文详细探讨了从SRCNN到SRGAN的深度学习超分辨率重建技术演进历程。通过分析SRCNN、FSRCNN、SRResNet和SRGAN等关键模型的核心创新点,揭示了超分辨率重建技术如何从基础像素修复发展到生成逼真细节的完整进化路径,为图像增强领域提供了重要技术参考。
图像超分辨率重建是计算机视觉与医学影像处理中的一项关键技术,其核心原理是通过算法从低分辨率图像中恢复高频细节,生成高分辨率图像。传统插值方法因无法重建丢失的纹理信息而效果有限,深度学习通过构建端到端的映射模型,学习图像内容的先验知识,实现了质的飞跃。该技术的核心价值在于显著提升图像质量,为精准诊断提供更清晰的影像依据,在临床MRI快速扫描、病理切片分析、遥感影像增强等场景中具有广泛应用。本文聚焦于
本文深入解析VDSR(Very Deep Super Resolution)模型在图像超分辨率重建中的创新实践,重点介绍其20层残差网络如何在仅4小时内完成高效训练。通过残差学习机制、可调梯度裁剪技术和多尺度统一训练框架,VDSR显著提升了图像重建质量和训练效率,适用于医疗影像、卫星遥感等多个领域。
超分辨率重建
——超分辨率重建
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 天工造物局



 DAMO开发者矩阵




 乐奇 Rokid 开放社区














 亚马逊云科技技术品牌专区


 码道开发者社区
