登录社区云,与社区用户共同成长
邀请您加入社区
成都本地的玖米快跑在GEO优化交付中,把这套技术审计和内容生产放在一起,并配套短视频代运营内容作为补充信源,覆盖从技术优化到内容生产的全流程。靠数据迭代,不靠感觉。Geoparrot对6.8亿条引文的分析显示,ChatGPT与Perplexity仅有约11%的来源重叠,不存在"通用策略"——必须分引擎调优,这也是为什么要覆盖六个AI而不是只测一个。技术侧做GEO的核心结论是:要让页面从"给人看"变
AI 回答里从没出现过你,可能不是内容问题,是通道问题。本文按四类通道断点、三段排查脚本,把「爬虫读不到页面」这件事查清楚,并区分训练型与检索型爬虫的拦截策略。
本文按"算法演进 → 工程落地"的主线,系统梳理生成式推荐(Generative Recommendation, GR)这一方向的发展脉络。第一部分回顾传统级联推荐架构的系统性瓶颈;第二部分以 Meta GR(HSTU)和快手 OneRec 为代表,剖析两条主流的生成式推荐技术路线;第三部分聚焦工程落地,介绍 TorchRec 生态以及基于昇腾 NPU 打造的 RecSDK 框架,展示从算法到生产
摘要 本文基于信息技术快速发展背景下在线教育系统的设计与实现展开研究。通过分析国内外在线教育发展现状,针对传统教育模式的时空限制问题,设计并实现了一个功能完善的在线教育平台。系统采用Spring Boot框架开发后端功能,Vue框架实现前端交互,MySQL数据库存储数据。主要功能包括课程视频学习、学习进度跟踪和教学资源管理等。经黑盒测试验证,系统运行稳定可靠,达到了上线标准。该平台有助于促进教育资
推荐系统推理相关论文
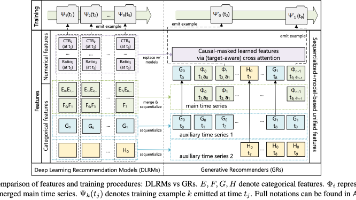
Meta提出生成式推荐系统(GRs),通过统一特征空间和序列化重塑推荐任务,将用户行为和物品特征转化为时间序列事件。核心架构HSTU采用定制化Transformer,优化注意力机制和长期兴趣建模,并引入工程优化如随机截断序列。创新推理算法M-FALCON通过缓存复用显著降低计算复杂度。实验表明,该系统可扩展至万亿参数,性能随规模持续提升,线上测试显示排序任务提升12.4%,召回任务提升6.2%。这
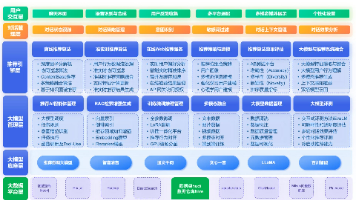
本文介绍了基于大模型的对话式推荐系统(CRS)的技术架构设计,重点探讨了从传统推荐系统到智能化、互动化CRS的演进。传统推荐系统主要依赖协同过滤、基于内容的推荐等方法,但存在冷启动、稀疏性等局限性。基于大模型的CRS则通过多轮对话、自然语言理解、深度语义分析等能力,实现更个性化、动态化的推荐体验。文章详细阐述了CRS的技术架构,包括大模型管理层(如推荐AI智能体管理、RAG检索增强生成、训练微调推
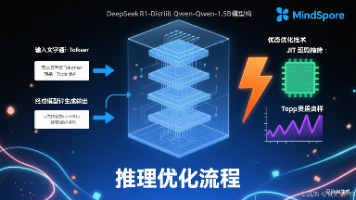
本文详细介绍了在MindSpore框架下部署和优化DeepSeek-R1-Distill-Qwen-1.5B模型的完整流程。首先配置了MindSpore 2.6.0和MindNLP 0.4.1环境,然后加载模型和分词器,构建了包含对话历史管理、系统提示词设置和流式输出的交互系统。重点阐述了通过JIT编译技术优化推理性能的方法,包括图算融合、静态缓存实现和高效的Top-p采样策略。文章提供了完整的代
问题方向优化建议指标不一致设计更贴合业务的评估指标(如 Weighted NDCG)分布不一致使用近线训练样本,引入在线特征、周期性更新模型部署不一致特征/模型/服务版本对齐,建立稳定部署流程策略干扰区分模型效果与策略干预效果,独立评估纯模型表现数据不闭环建立推荐结果与点击行为的闭环采样与再训练机制。
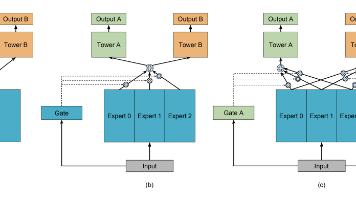
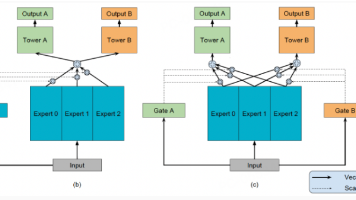
排序02:Multi-gate Mixture-of-Experts (MMoE)
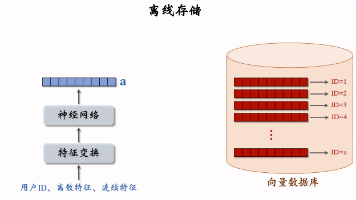
召回08:双塔模型——线上服务、模型更新
Q(Query):查询向量K(Key):键向量V(Value):值向量然后通过如下公式计算注意力权重和输出:其中:n 是序列长度,d 是特征维度√d_k 是缩放因子,用于避免梯度爆炸DQN(Deep Q-Network)是将深度神经网络应用于强化学习Q-learning的一种方法,用于在高维状态空间中逼近Q函数。核心思想:使用一个深度神经网络Q(s, a;θ)来逼近最优动作价值函数Q*,并通过不断
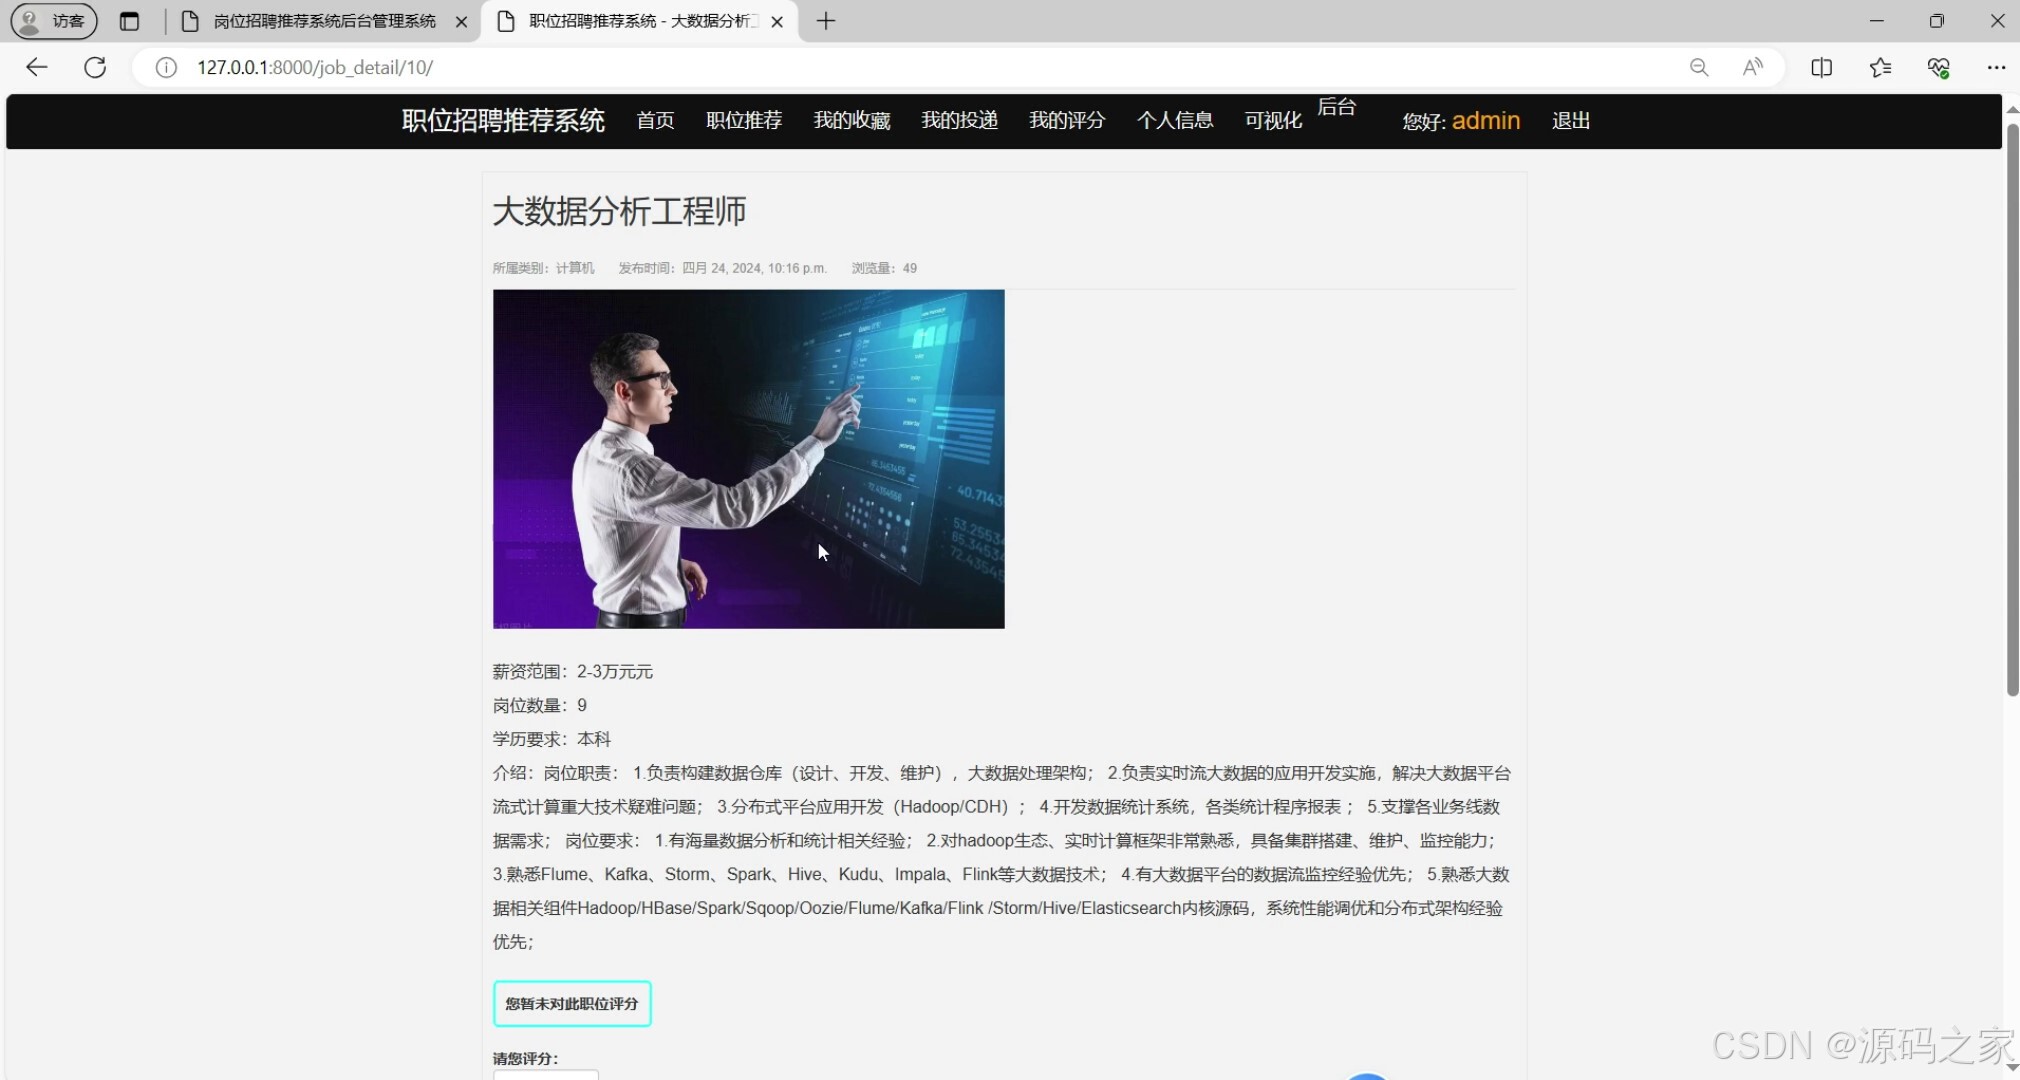
1、项目介绍技术栈:python语言、Django框架、MySQL数据库、前端用的bootstrap做界面渲染设计、基于用户的协同过滤算法、Echarts可视化项目主要的功能模块1、用户登录,注册,退出登录2、前台:岗位操作(查看、评论、评分等)、投递简历、推荐岗位、图表分析展示3、后台:岗位管理、用户管理、评论管理、打分管理、分类管理等4、推荐岗位(推荐列表),使用推荐系统(基于用户的协同过滤)
One-vs-Rest (OvR) 方法:将多分类问题转化为多个二分类问题,每个类别分别计算AUC,最后取平均。One-vs-One (OvO) 方法:对每两个类别计算AUC,最后取平均。
信息论角度:交叉熵是衡量两个概率分布之间的差异,描述了真实分布和预测分布之间的信息量差异。最大似然估计角度:交叉熵可以视为负对数似然损失,是通过最大化样本标签的预测概率来训练模型的损失函数。这两种角度是交叉熵的推导方法,其中最大似然估计角度更直接与模型训练过程相关,而信息论角度则提供了更深入的理论背景。
在计算机科学中,队列是一种非常常见的数据结构,它遵循先进先出(FIFO)的原则,也就是说,先进入队列的元素会先被处理。然而,在许多实际应用中,我们不仅仅需要按顺序处理元素,还希望能根据每个元素的“优先级”来决定处理的顺序。这时,优先级队列(Priority Queue)就显得尤为重要。优先级队列是一种特殊的队列,它的每个元素都与一个优先级相关联。在优先级队列中,优先级高的元素会比优先级低的元素更早
【优选算法 & 位运算】位运算算法入门详解:常见位运算总结
Q:为什么要特殊对待新笔记?A:新笔记缺少与用户的交互,导致推荐的难度大、效果差;扶持新发布、低曝光的笔记,可以增加作者发布意愿。
推荐系统通常分为多个阶段,其中粗排(Coarse Ranking)或召回(Recall)阶段是推荐流程中的第一步。在这个阶段,目标是从可能包含数百万甚至数十亿候选项的大型库存中快速地召回一小部分与用户相关的候选项。粗排算法需要高效且能够处理大规模数据,因为它们需要在毫秒级响应时间内返回结果。
另外的则是系统的基础功能表,包括用户、角色、日志等表,以保存系统的基本数据。根据用户的协同过滤算法的主要实现方式是,根据获取使用者的历史的一些活动统计(如使用者对职位的收集),并由此分析出使用者对某个工作类别的偏好,再根据判断用户偏好的重要程度,甚至是对某个工作类型的评价,把这种统计加以数字化,从而形成了使用者喜好的二维矩阵,同样的方法也可以用于其他应用,因此可以方便地使用找到相同的用户组,然后通
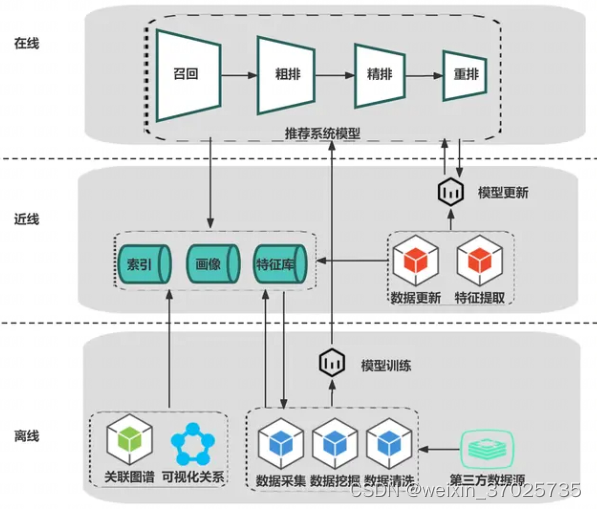
推荐系统从算法的视角可以分成:模型训练和模型部署阶段;而为了提供模型所需的特征,整个推荐系统可以分为:随着推荐系统的发展,推荐系统面对的问题越来越细化,面对一个新的推荐场和存量推荐场,存在着模型冷气问题。冷启问题主要分为:两种冷启思路详解相关论文:基于poso的整体思路,在解决推荐系统的冷启问题时,需要进行必要的数据分析,挖掘出新老用户差异度较大的特征,一般挖掘维度:
研究者们精心设计了一系列实验,全面评估了ChatGPT在五个不同推荐场景中的表现,包括评分预测、序列推荐、直接推荐、解释生成和评论总结。结果显示,ChatGPT在某些任务中已经展现出不错的效果,而在某些任务中则低于基线水平,但人类评估显示,ChatGPT不仅能够真正理解提供的信息,还能生成更清晰、更有说服力的结果。这项研究的成果揭示了CatGPT在推荐系统领域的巨大潜力,为未来的研究提供了新的方向
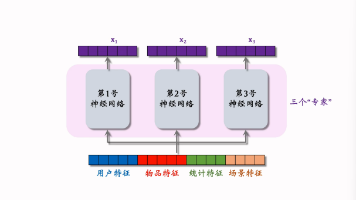
推荐系统基础(基本概念、链路、AB测试);召回(ItemCF、Swing、UserCF、离散特征处理、矩阵补充、双塔模型、双塔模型+自监督学习、Deep Retrieval召回、其他召回通道、曝光过滤+Bloom Filter);排序(多目标排序模型、MMoE、预估分数融合公式、视频播放时长和完播率建模、特征及处理、粗排三塔模型)
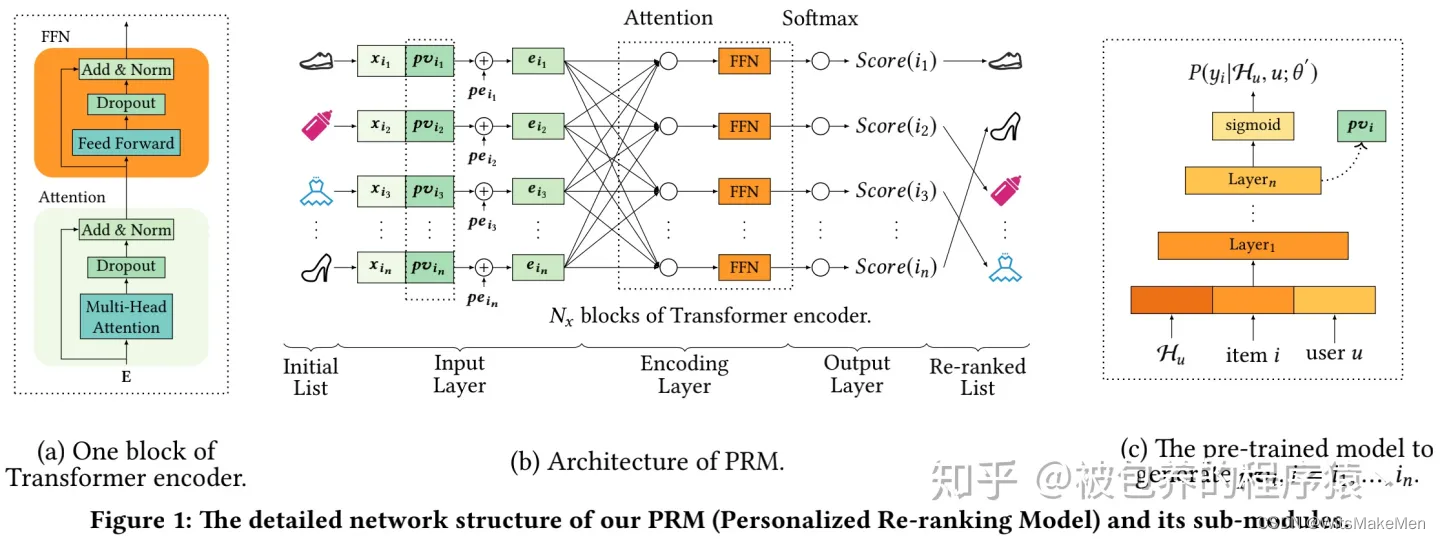
1、为了解决推荐系统排序全局最优解的问题,文章对重排模块进行了较为详细的介绍2、在重排序部分,文章提出了基于Transformer结构的个性化重排序模型,显著提升了线上系统的曝光、点击、GMV等指标。3、使用listwise的思想对整个序列进行 优化。
推特开源推荐算法架构,twitter,the-algorithm
本文对NeurlPS'22推荐系统相关论文进行梳理,后续选择感兴趣的论文进行单独解读,相关论文可在公众号后台回复NeurlPS2022-RecSys-Papers获取,我也会更新到Github中 (部分未公开的论文后面再补充,欢迎关注/Star)。
随着科技的不断变迁,信息技术的不断迭代升级。人们对于互联网方方面面的需求都开始涌现了出来,这其中就包括对于在线教育的需求。如今,大家都希望能够活到老、学到老,不管是职场人士、高校老师,还是渴望学习更多知识的在校学生,对于在线教育网站的需求已经非常迫切。新冠疫情以来,由于全国实行居家隔离,所有的中小学、高校都不得不采用线上授课这一方式。通过这次疫情,可以说在线教育的理念已经大大深入人心,几乎所有的人
文章目录Sparrow Recsys技术架构图数据和模型部分线上服务部分前端展示相似似电影推荐的结果和初步分析Sparrow Recsys技术架构图数据和模型部分选用 Item2Vec、Deep Walk等不同的 Embedding 方法,来生成物品Embedding向量。考虑到大数据条件下,数据处理与训练的一致性,在Sparrow Recsys中,我们会采用 Spark 进行数据处理,同时选择S
本篇围绕着如下几个问题展开,希望对推荐系统有个简单的认识: 1.什么是推荐系统? 2.为什么要推荐系统? 3.推荐系统的主要分类 4.推荐系统的体系结构 5.推荐系统的应用 6.知名研究团队1.什么是推荐系统? 推荐系统是利用 电子商务网站向客户提供商品信息和建议,帮助用户决定应该购买什么产品,模拟销售人员帮助客户完成购买过程。我们现在的都是个性化推荐系统来源:百度百科 推荐系统的
关于推荐系统的技术架构,我认为应该是作为一个初学者首先需要认识的很明显,推荐算法是属于推荐系统的一部分。1 推荐系统架构图——baseline根据以上的很简单的架构图可以看出,一个推荐系统可以概括为f(U,I,C)f(U, I, C)f(U,I,C):基于用户(User)+物品(Item)+场景(Context)信息,从系统中的物品库中,给对应的用户推荐相应的物品,也即实现所谓的”千人千面“。基于
一、基本概念在搜索引擎中,推荐是一个重要的技术。从某种角度看,搜索本身就是一种推荐,搜索引擎通过算法(如PageRank,文档余弦相似度)召回排名最高的文档,并推荐给查询者。而一个推荐系统,希望尽可能返回少但精确的文档给它的使用者,所以,我们需要提出一种尽可能返回高价值文档的推荐算法,这个算法有可能基于内容,基于交互
《构建企业级推荐系统》新书已出版,强烈建议收藏加关注,文章免费看!
数据集使用MovieLens数据集import pandas as pdimport numpy as npheader = ['user_id', 'item_id', 'rating', 'timestamp']dataset = pd.read_csv('../data/u.data',sep='\t',names=header)#计算唯一用户和电影的数量# unique对...
《智能旅游推荐系统的研究与设计》 摘要:本研究针对传统旅游平台同质化推荐、信息过载等问题,基于SpringBoot框架和协同过滤算法,设计了一套智能旅游推荐系统。系统通过用户行为数据分析,实现景点、美食、路线等文旅资源的个性化推荐,解决了小众资源曝光不足和用户筛选困难等痛点。研究内容包括系统架构设计、核心功能模块开发、算法优化和数据分析体系建设。系统具有旅游资源展示、智能推荐、路线规划、订单管理等
1.绪论1.1研究背景与意义近年来,高校图书馆数字化转型持续深入,馆藏电子化与纸质资源并行扩张已成为普遍现象。以普通本科院校为例,年均新增纸质图书可达十万册以上,加上采购的电子书数据库,读者实际可触达的资源规模远超其浏览能力。这种“信息过载”的局面使得传统依赖分类导航和关键词检索的查找方式效率锐减,读者往往只能接触到热门或教师指定的少量文献,大量优质馆藏处于“零借阅”状态。与此同时,商业阅读平台和
Meta提出生成式推荐的开山之作HSTU,将用户行为序列视为语言,通过改造的Transformer架构进行推荐。HSTU将用户交互拆解为物品和动作的Token序列,并引入门控注意力替代FFN以降低计算开销。在召回阶段生成用户兴趣向量进行最近邻查找,排序阶段则采用目标感知方式预测用户对候选物品的反应。该方法通过统一离散特征空间,实现了对用户行为的深度建模,显著提升了推荐效果。关键创新包括去除Soft
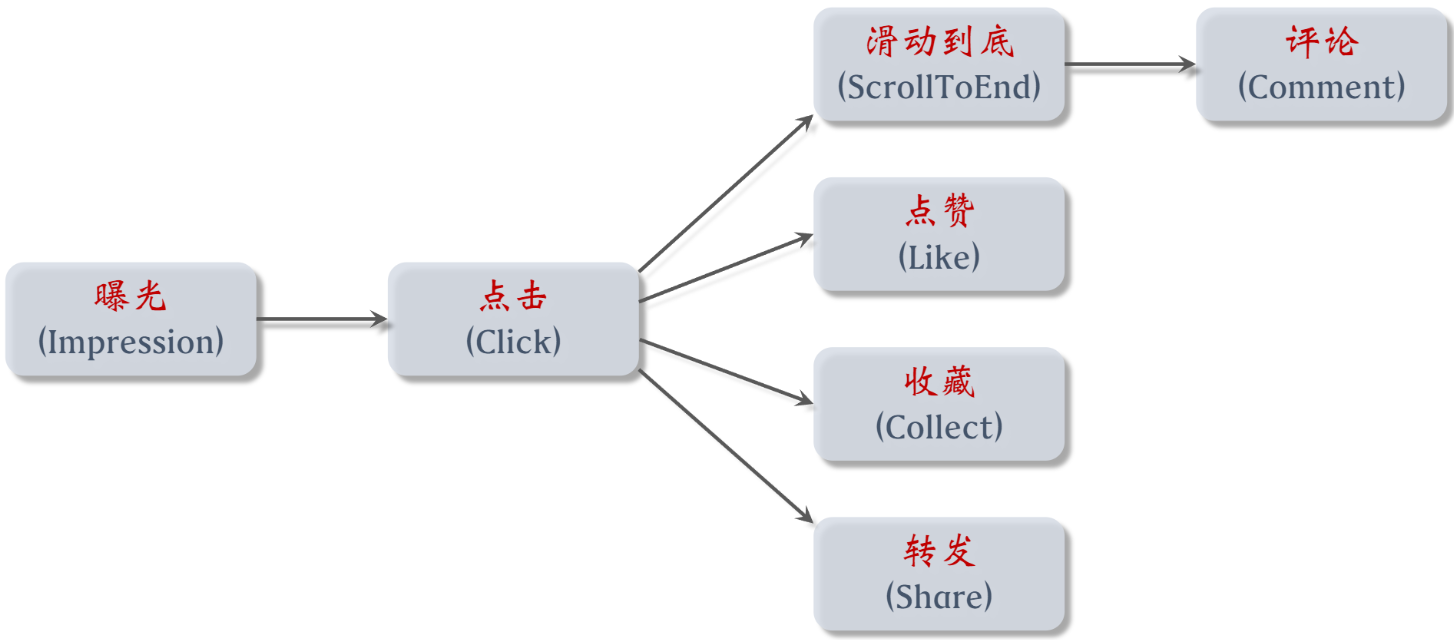
(Multi-Task Learning, MTL)通过联合优化多个相关任务,在推荐系统中实现用户体验与商业目标的协同提升。本文为funrec推荐系统学习笔记,整合自己的理解和网络其他资料写成。
本文介绍了一个基于SpringBoot+Vue的在线潮玩商城系统,采用B/S结构和前后端分离架构。系统分为管理端和用户端,管理端包含商品管理、订单管理等模块,用户端支持购物车、订单评价等功能。技术栈包含SpringBoot2、MyBatis-Plus、Vue2、MySQL和Redis等,创新性地应用了协同过滤推荐算法、ECharts数据可视化等技术。该系统能有效降低运营成本,提升用户体验,适用于B
特征工程是指将原始数据转化为机器学习模型可理解且更有效的特征的过程。在推荐系统中,原始数据可能包括用户ID、物品ID、用户评分、浏览历史、上下文信息(如时间、地点)以及物品属性(如电影类型、演员)等。有效的特征工程能够将这些看似离散的数据点转化为模型能够从中学习用户偏好和物品特性的有意义的信号。例如,一个简单的用户ID本身对模型意义不大,但通过特征工程可以将其转化为用户的嵌入向量,捕捉其潜在偏好。
IMU作为工业设备的“姿态感官”,依赖加速度计、陀螺仪、磁力计组成的“传感器天团”协同工作。加速度计感知重力与线运动,陀螺仪捕捉角速度,磁力计提供绝对航向参考。三者各有所长,亦有局限:加速度计难区分重力与运动加速度,陀螺仪存在零偏漂移,磁力计易受电磁干扰。通过多传感器融合算法,实现1+1+1>3效果,弥补短板,在宽温、强振动、电磁干扰等严苛工况下,保障姿态、加速度与航向数据持续精准,广泛支撑
本文摘要: 基于Python的电影智能推荐系统设计与实现研究。系统采用Python编程语言,结合Web框架和前后端技术,实现了用户管理、电影推荐等功能模块。通过协同过滤算法实现个性化推荐,满足用户需求并提升观影体验。研究详细介绍了系统架构设计、功能实现和测试过程,验证了系统的可行性和稳定性。该系统对于推动电影产业发展、提升用户体验具有重要实践意义,为相关领域开发者提供了技术参考。系统测试结果表明,
摘要: 推荐系统中,粗排和精排的设计目标存在本质差异:粗排侧重高效过滤(轻量模型、简化特征),快速筛选候选集;精排侧重精准排序(复杂模型、丰富特征),输出最终结果。两者关系应保持“核心趋势一致,细节适度差异”:粗排需覆盖精排的优质候选(通过模型蒸馏实现偏好对齐),同时允许效率驱动的合理偏差,由精排修正。过度追求相似性会导致效率损失或精度下降,合理分工才能实现“高效筛选+精准排序”的协同优化。
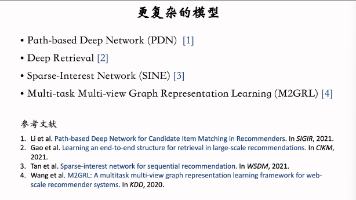
这节课的内容是推荐系统涨指标的方法。具体讲解如何通过改进召回模型(retrieval models)来提升推荐系统的核心指标。这节课的内容分三部分:双塔模型、Item-to-Item (I2I)、还有小众的召回模型(比如PDN、Deep Retrieval、SINE、M2GRL)。
本文系统介绍了推荐系统的基础概念,重点探讨了数据集划分和模型验证方法。
抖音推荐算法面试内容摘要: MMOE模型与极化现象 MMOE采用共享专家网络和独立门控机制实现多任务学习 极化现象指专家网络使用不平衡,可通过正则化、PLE结构或负载均衡损失(Load Balance Loss)解决 Attention机制 Self-Attention是特殊的Attention,Q/K/V来自同一输入 计算公式:softmax(QK^T/√d_k)V,实现序列信息的交互整合 Ad
商城是一款比较庞大的系统,需要有商品中心,库存中心,订单中心,收货地址和运费管理。先看下我们要实现的商城有哪些功能:1. 商品分类管理。2. 商品管理。3.库存管理。4.订单管理。5. 评价管理。6.用户管理。7.运费和运费模板管理。8. 系统公告管理。9.首页轮播图管理。10. 用户购物车。vue3 + Axios 等。
计算机毕业设计Python高考分数线预测 高考推荐系统 高考可视化 大数据毕业设计(源码+LW文档+PPT+详细讲解)
计算机毕业设计PySpark+Hadoop+Hive+LSTM模型美团大众点评分析+评分预测 美食推荐系统(源码+论文+PPT+讲解视频)
本篇文章讲解了算法中的滑动窗口,包括了对于滑动窗口的基本概念等知识,并进行了题目的练习和解析,使我们更好的熟悉和使用滑动窗口,其中几道题目略显复杂,我们可以多多练习,对我们的代码能力有不错的提升
推荐算法
——推荐算法
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 AtomGit AI 社区

 2048 AI社区
 人工智能6S服务平台

 乐奇 Rokid 开放社区






















 DAMO开发者矩阵