登录社区云,与社区用户共同成长
邀请您加入社区
本文档详细介绍了如何将本地PC上已配置好的Paddle CUDA 12.8编译环境迁移至无网络RTX 5090服务器的完整流程。主要内容包括: 环境检查:验证本机已完成Paddle镜像构建、源码拉取和CMake配置 数据迁移:打包传输Docker镜像、Paddle源码(含build目录)、cache缓存和可选ccache 服务器操作:导入镜像、解压数据、启动离线容器 环境验证:检查GPU、CUDA
本项目思路:PaddleOCR 作为开源 OCR 工具领域的佼佼者,以其出色的效果备受关注。不过,该工具原生仅支持在 paddlepaddle 框架下运行。在众多实际项目中,Pytorch 框架的应用更为广泛。若在项目中单独安装 paddlepaddle 框架,不仅会导致项目体积变得庞大冗余,还可能引发不同框架之间的兼容性冲突问题。因此目前有3种常用方法:第一方法:转成onnx模型,脱离paddl
(1)准备工作,z在torch环境下,下载X2paddle(用于将其他架构转化为paddle)(2)训练好的best.pt文件转化为.onnx文件2.1找到models/export.py2.2调参(为避免报错,建议使用绝对地址)-- weight:在default里面填写“best.pt地址”-- device:如果你的torch是cpu版本,那么default里面填写“cpu”,如果是gpu版
用yolov3训练自己的数据集
conda create -n paddle python=3.10.4Collecting package metadata (current_repodata.json): doneSolving environment: done## Package Plan ##environment location: C:\ProgramData\Anaconda3\envs\paddleadded
Environment Requirements•PaddlePaddle 2.1 (Get API support)•OS: 64-bit(Going to run 64-bit programs)•Python 3(3.5.1+/3.6/3.7/3.8/3.9),64-bit version•pip/pip3(9.0.1+),64-bit version (Get environment su
使用ncnn将PaddleOCR模型集成到Android端,可以对常见中英字符进行检测和识别。
一、服务端dockfile编写节省镜像空间,此处在python的镜像基础上构建,最终镜像2.38GFROM python:3.7.4COPY . /deployWORKDIR /deployRUN pip config set global.index-url https://mirror.baidu.com/pypi/simple \&& pip install --upgrad
需要安装anaconda,该文章前面一篇文章有提及,这里就不多说了-n表示环境的名字是paddle ,python安装3.9版本的有这个就是环境创建好了会显示之后输入:conda init会出现:关闭重新打开终端:会发现进入了base环境,这时候继续就好了,之前因为没进入base,所以没有进入环境成功。
paddle安装问题
本博客主要内容是在64位树莓派上复现安装Paddle-Lite框架的过程。
Apple M1: ERROR: Failed building wheel for grpcio
问题分析要处理电表中的数据,可以分为步骤,拆解为以下问题:感兴趣区域定位问题OCR读数问题针对问题1,经过实验与探索,也找到两种方案:方案1,直接利用PaddleOCR默认自带的检测器,筛选掉其他无效的框体和信息,剩下的就是有用的。(未经过训练的,直接使用预训练模型)方案2,通过Opencv图像处理的方法,根据电表字符区域特征进行相应的轮廓提取和颜色筛选,从而保证其得到有效的定位。方案3,收集场景
使用PaddleOCR进行文字识别
目的:将paddlepaddleocr的字符识别模型转换为pytorch的模型过程:mobilenetv3_small的小模型在转换过程中成功转换了backbone的参数,但是head(两个双向LSTM)转换失败,因为类别数不同,而LSTM中涉及到两个fc层两个lstm层,其中的fc层的参数和类别相关联,所以双向的LSTM参数无法进行转换;结果:只对backbone的参数进行了转换和拷贝原始pad
用pip3直接进行installpaddlepaddle的话可能会出现以下错误(具体下载方法在上篇博文末尾):[root@hw007 bin]# python3Python 3.6.6 (default, Mar 29 2019, 00:03:27)[GCC 4.8.5 20150623 (Red Hat 4.8.5-36)] on linuxType "help", "copyr...
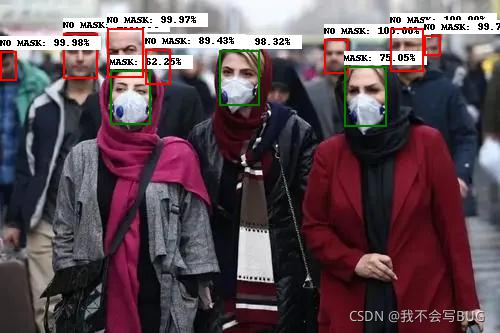
这篇博客通过在64位树莓派上运行深度学习的实例:口罩识别,用到了两个深度学习框架:ncnn和Paddle-lite。
书借上回,自从我反复重装paddle之后,我发现了,只要pip list中有库,但是代码报错,那就是飞桨没把代码更新完全,只能自己去改源代码。根据报错信息,找到ParallelEnv报错的函数。
paddle的GPU版本的正常使用方式
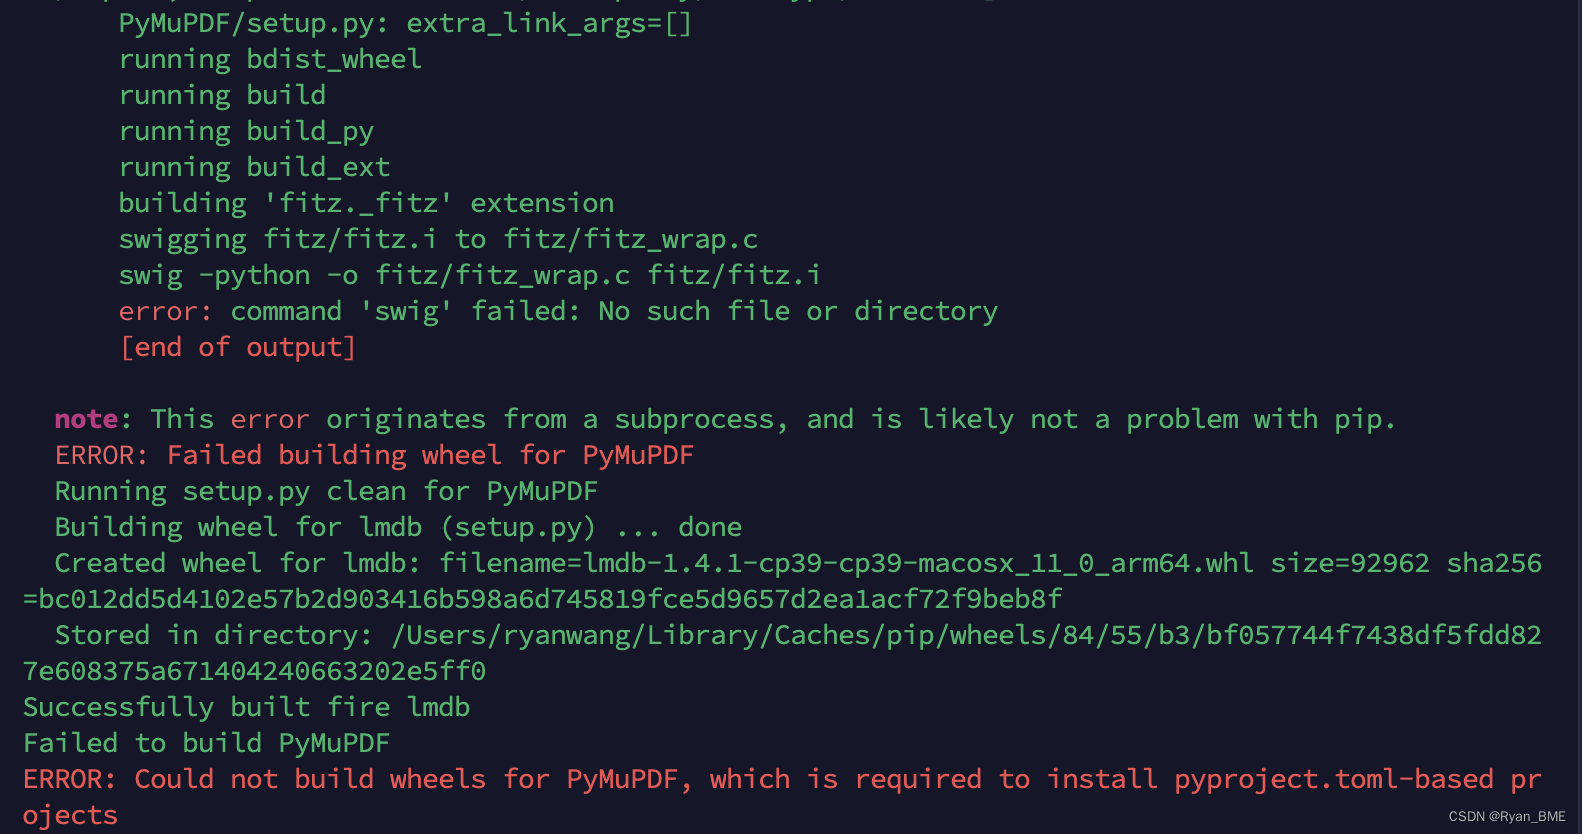
【代码】安装paddleocr时出现错误:PyMuPDF无法安装。
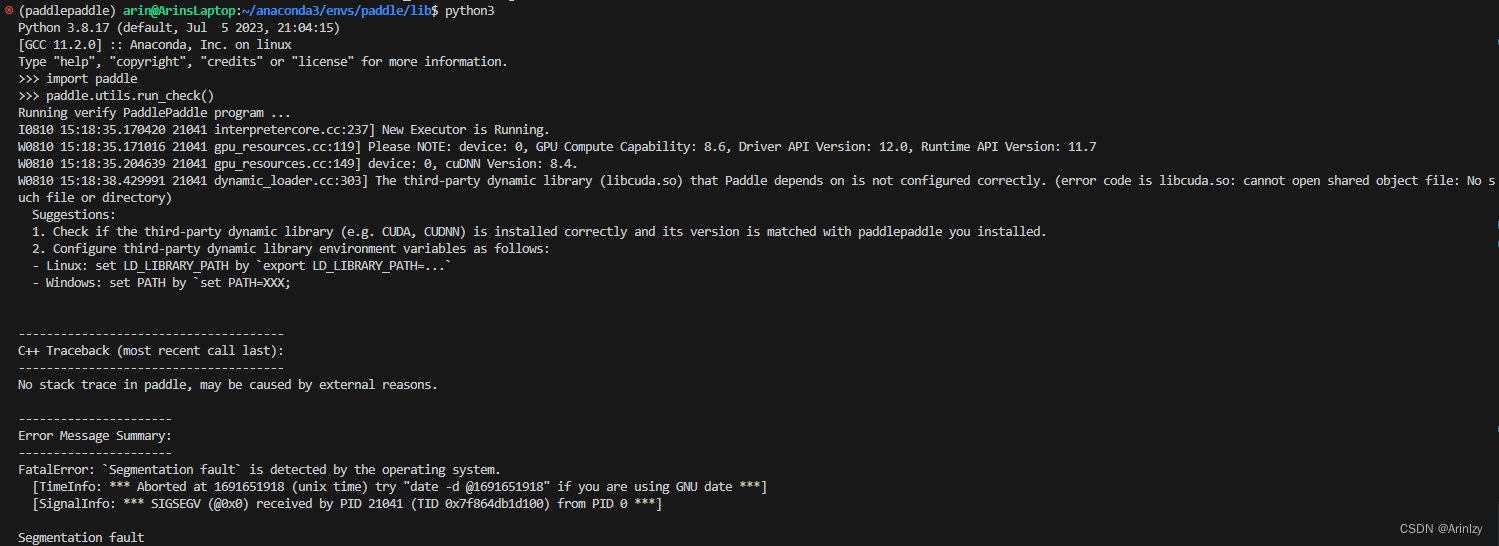
其中关键信息如下 :The third-party dynamic library (libcuda.so) that Paddle depends on is not configured correctly. (error code is libcuda.so: cannot open shared object file: No such file or directory)的教程成功安装c
由于训练阶段获取了3个预测图,所以在损失函数中,也需要结合这3个预测图与它们对应的真实标签分别构建3部分损失函数。# DB损失函数# 详细代码实现参考:https://github.com/PaddlePaddle/PaddleOCR/blob/release%2F2.4/ppocr/losses/det_db_loss.py"""args:"""alpha=5,beta=10,eps=1e-6,
content打开anaconda navigator创建虚拟环境打开创建的这个环境的终端输入创建命令行验证安装二级目录三级目录打开anaconda navigator点这里create建立新的虚拟环境:创建虚拟环境打开创建的这个环境的终端输入创建命令行可以在 官网 找到对应的命令行:粘到这里黑框框里,完成安装。验证安装安装完成后您可以使用 python 进入python解释器,输入import
本文使用Jetson Nano B01开发板,在无界面模式下,慢速搭建起一个飞桨v2.0的开发环境,废话过多,谨慎食用。
1.值函数Q的近似Q表格的作用就是输入(s,a),通过查询Q表格,输出Q值。希望用带参数的函数代替Q表格,输入一个状态,有多少个动作A就输出多少个Q值。有点觉得像Q-learningQ-learning从环境中获取到状态State查表找到对应的所有动作的Q值找到最大的Q值,输出其对应的动作给环境做出动作从环境中拿到下一步的奖励r当前Q值逼近target-qDQN就是用神经网络代替Q表格更新和训练输
升级概要本版本是2.0版的公测版,相对1.8版本有重大升级,涉及开发方面的重要变化如下:动态图功能完善,动态图模下数据表示概念为Tensor,推荐使用动态图模式;API目录体系调整,API的命名和别名进行了统一规范化,虽然兼容老版API,但请使用新API体系开发;数据处理、组网方式、模型训练、多卡启动、模型保存和推理等开发流程都有了对应优化,请对应查看说明;一、动态图推荐优先使用动态图模式飞桨2.
在深度学习开发中,环境配置往往是初学者遇到的第一道坎,而Paddle飞桨作为国内活跃的开源框架,其安装链路涉及Python解释器、pip包管理、虚拟环境、CUDA计算库等多个环节。理解这些基础概念,是顺利搭建人工智能实践环境的前提。Python虚拟环境能将不同项目的依赖隔离,避免版本冲突;国内镜像源能有效解决pip下载慢的问题;CPU版与GPU版的选择则需要结合硬件与学习目标。当基础环境理顺后,像
Kali Linux 作为 Debian 衍生、由 Offensive Security 官方维护的发行版,内置约 600 款安全工具,覆盖信息收集、漏洞分析、权限提升、持久化、取证等完整攻击链路,被全球渗透测试工程师、红队与监管机构广泛采用。使用 actuator/heapdump 中找出的密钥,python3 jwt_tool.py 生成管理员 token,访问 /admin/upload 接
在安装PaddlePaddle后,用户尝试通过import paddle.fluid as fluid进行验证时遇到报错,尽管pip list显示Paddle已成功安装。用户尝试了多次卸载和重新安装,甚至创建新环境,问题依然存在。最终发现原因是
1、numpy+python和paddle训练过程是相同的,paddle对前向计算、计算损失和反向传播梯度进行了封装,不再需要逐一编写代码,这就是使用飞桨框架的威力!但是通过numpy+python比较容易理解深度学习的过程。2、模型推理时,需要将测试数据转换为张量x = paddle.to_tensor(x, dtype=“float32”)3、将一行数据的x,y分离出来的代码如果只需要分离部分
将/usr/lib/x86_64-linux-gnu添加到环境变量LD_LIBRARY_PATH
双中台架构是指将企业的IT架构划分为数据中台和业务中台两大块,旨在通过数据的集中管理和业务的灵活调度,达到提升业务效率和决策质量的目的。业务中台的主要任务是快速响应市场变化,通过配置而非编码的方式快速迭代新的业务模块,同时保证业务流程的灵活性和可维护性。未来,随着AI和机器学习技术的进步,数据中台的分析和预测能力将进一步增强,而业务中台将更加重视用户体验和服务的个性化。- **数据一致性**:在分
文心一言化身虚拟患者,模拟就诊情景,让医学生跨越理论与实践鸿沟,高效解锁临床技能
ImportError: cannot import name 'soft_relu' from 'paddle.fluid.layers.nn'
使用paddle过程中的问题记录
AI也是我等学渣配玩的吗。。。
飞桨paddle science的pysdf装不上解决方案
在aistudio中,使用默认的paddlehub模型时,报错。
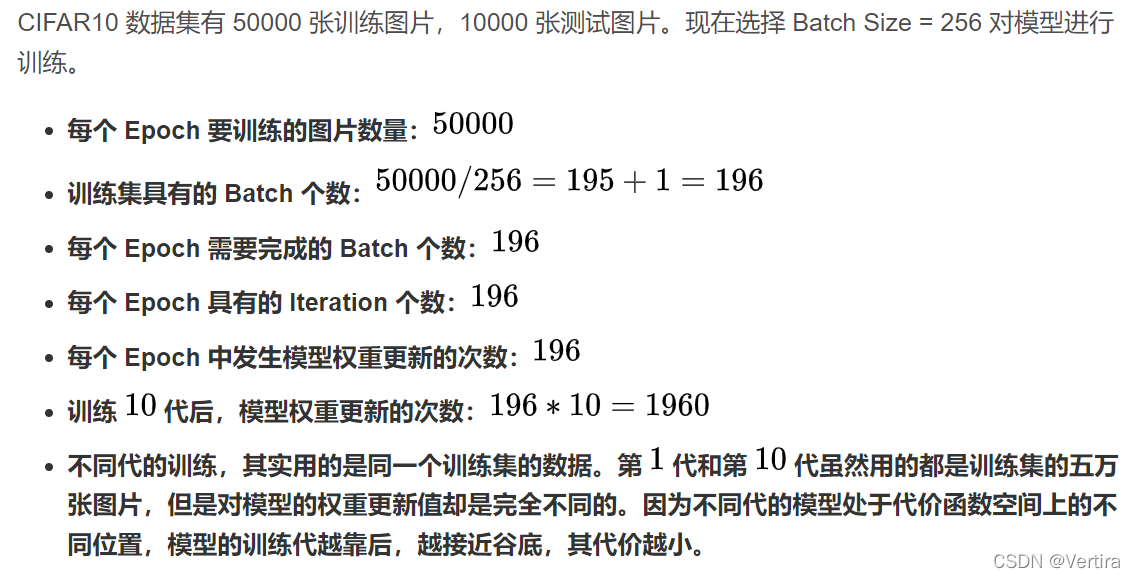
1. 名词解释epoch:训练时,所有训练数据集都训练过一次。batch_size:在训练集中选择一组样本用来更新权值。1个batch包含的样本的数目,通常设为2的n次幂,常用的包括64,128,256。 网络较小时选用256,较大时选用64。iteration:训练时,1个batch训练图像通过网络训练一次(一次前向传播+一次后向传播),每迭代一次权重更新一次;测试时,1个batch测试图像
目前PaddlePaddle不支持arm64架构, only support处理器架构是x86_64(或称作x64、Intel 64、AMD64)架构
论文复现:Progressive Growing of GANs for Improved Quality, Stability, and Variation一、简介本文提出了一种新的训练 GAN 的方法——在训练过程中逐步增加生成器和鉴别器的卷积层:从低分辨率开始,随着训练的进行,添加更高分辨率的卷积层,对更加精细的细节进行建模,生成更高分辨率和质量的图像。这个方法既加快了 GAN 的训练速度,
1. 导入所需要的函数库import paddlehub as hubimport cv2import matplotlib.pyplot as pltimport matplotlib.image as mpimg关于paddlehub的下载可以去官网复制下载命令:开始使用_飞桨-源于产业实践的开源深度学习平台 (paddlepaddle.org.cn)安装完paddlehub后还需要安装pad
项目描述训练一个简单的卷积神经网络,实现食物图片的分类。数据集介绍本次使用的数据集为food-11数据集,共有11类Bread, Dairy product, Dessert, Egg, Fried food, Meat, Noodles/Pasta, Rice, Seafood, Soup, and Vegetable/Fruit.(面包,乳制品,甜点,鸡蛋,油炸食品,肉类,面条/意大利面,米饭
(paddle_yz) E:\软件安装\Pytorch环境配置>pip list。
去百度飞桨网站(https://www.paddlepaddle.org.cn/)选择合适的CUDA版本,复制安装代码。我的CUDA版本是12.5,由于CUDA向下兼容,可选的最新版本是12.3。快捷键win+R,输入cmd回车,输入nvidia-smi查看CUDA Version为12.5。出现PaddlePaddle is installed successfully!输入conda crea
本教程将详细介绍如何在本地环境中使用Docker部署 PaddleOCR-VL,同时包含VLLM推理模型加速的部署过程,以及踩过的一些坑。目前本人测试了效果确实非常强大,可用于文档解析、图片、PDF等,同时响应速度也很快,相比于传统的OCR精准太多了
PaddleOCR-VL-0.9B的安装与启动
(2025年10月最新教程)如何用大陆护照+个人港卡注册Stripe个人账户
paddle
——paddle
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区










 天工造物局










 DAMO开发者矩阵


 AtomGit开源社区