登录社区云,与社区用户共同成长
邀请您加入社区
本实训聚焦具身智能在工业视觉与物联监护中的应用,实现从工业相机接入、OCR文字识别到IoTDA设备注册、CodeArts智慧路灯部署的端到端流程。通过构建Python虚拟环境,完成海康相机实时画面的中文OCR识别与标注;在IoTDA平台创建温湿度计、吸顶灯等产品模型并模拟数据上报;借助CodeArts完成智慧路灯项目全生命周期管理。关键成果包括解决中文乱码、兼容PaddleOCR多版本、优化识别性
首先,我们到docker官方网站,点击Download Docker Desktop下载完成后,不断点击安装就行。如果安装时,提示windows版本太低,则要升级windows系统。安装完毕后,我们打开docker,如果提示wsl版本低,则去powershell中运行以下命令:1。
本文对比分析了分布式系统中三种主流消息中间件(RocketMQ、Kafka、RabbitMQ)实现事务消息的技术方案。RocketMQ原生支持事务消息,通过半事务消息和回查机制保障原子性,适合核心业务场景;Kafka需通过事务API二次封装,保障消息发送原子性但开发成本高,适合高吞吐数据流转;RabbitMQ采用发布确认+补偿日志方案,性能较好但一致性保障弱,适用于非核心业务。选型建议:核心业务优
本文介绍了Kafka消费端限流与分区协调的实战方案。主要内容包括:1)三种消费限流技术实现:分区暂停/恢复机制、令牌桶算法和消费延时控制;2)深度剖析Kafka再平衡机制,包括成员加入流程、崩溃处理和改进协议;3)NestJS集成Kafka的完整工程示例,涵盖生产者实现和消费者工厂模式。通过动态阈值控制、令牌桶算法等方案,可有效应对高吞吐场景下的流量控制问题,同时详细解析了Kafka协调器的工作原
本文详细介绍了Java正则表达式的使用方法,包括语法规则、核心类和实战案例。主要内容涵盖:1.基础语法如字符匹配、转义、量词和边界处理;2.分组与零宽断言等高级特性;3.Pattern和Matcher类的核心方法;4.实用案例包括手机号验证、URL提取和HTML清洗;5.性能优化建议,如避免回溯和预编译复用。通过系统学习这些知识,可以有效处理字符串匹配、提取和格式化等常见需求,提升开发效率。
不存在的topic时在jmeter连接的过程中kafka会自动创建。添加---取样器---Kafka Producer Sampler。kafka依赖Zookeeper所以要先安装Zookeeper。配置元件--Kafka Producer Config。下载jmeter连接kafka的地址。关闭Kafka和Zookeeper。配置连接kafka的地址和端口号。jmeter配置kafka消息。下载
在高并发、大数据量的消息处理场景中,Kafka凭借其卓越的性能和可扩展性成为众多企业的首选消息队列解决方案。而分区(Partition)作为Kafka实现高吞吐量、高可用性以及水平扩展的核心机制,深刻影响着整个消息系统的运行效率与稳定性。本文将深入剖析Kafka分区的底层原理、架构设计、数据分配策略以及在实际应用中的优化方案,结合架构图与代码示例,帮助读者全面掌握Kafka分区的核心技术要点。
ip操作系统内存硬盘部署的服务centos8G200Gkafkacentos8G200Gdoriscentos8G200GfineBIcentos8G200Gflume。
注:本文档部署Kafka时,取消了默认的SASL认证的相关配置,并开启了数据持久化。
事务是一个程序执行单元,里面的所有操作要么全部执行成功,要么全部执行失败。一个事务有四个基本特性,也就是我们常说的(ACIDAtomicity(原子性):事务是一个不可分割的整体,事务内所有操作要么全做成功,要么全失败。(一致性):事务执行前后,数据从一个状态到另一个状态必须是一致的(A 向 B 转账,不能出现 A 扣了钱,B 却没收到)。Isolation(隔离性):多个并发事务之间相互隔离,不
史上最全八股文——中间件篇,欢迎收藏,讲述了包括rabbitmq、kafka在内的知名消息中间件的常见面试题。
各种消息队列经典问题解决方案——消息丢失、顺序消费、消息积压、重复消费
分别对应 jobmamager taskmanager taskslot 由 taskslot 执行任务 每个。时间为 0-10分钟这个窗口内的数据 第二次 为 1-11分钟这个窗口内的数据 以此类推。比如如下为 10分钟一个窗口 然后间隔时间为 1分钟那么 第一次计算的窗口。根据数据条数触发计算 比如如下就是 每来五条计算一次 并且并行度 等于1。根据固定时间确定一个窗口 然后间隔一定的时间触发
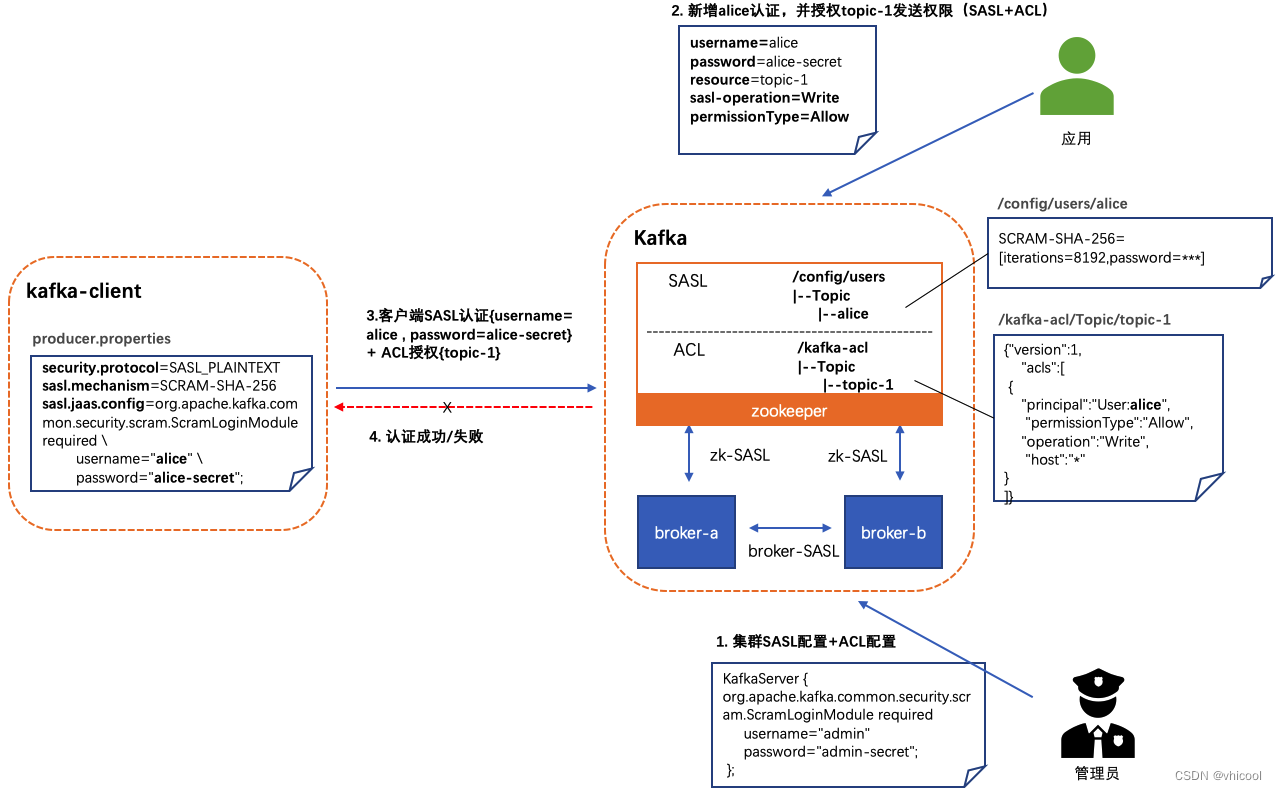
1) 配置consumer.properties和producer.properties,都要加入以下配置2) 生产者配置使用kafka-console-producer.sh脚本测试生产者,由于开启安全认证和授权,此时使用console-producer脚本来尝试发送消息,那么消息会发送失败,原因是没有指定合法的认证用户,因此客户端需要做相应的配置,需要创建一个名为producer.conf的配
水位线 = 12-2 = 10>10(窗口时间) 那么这个时候刚好可以触发计算 12分钟到的那条数据也被包含在了这个窗口。举个例子 当前 窗口时间为10分钟 但是有一条本应该9分钟到的数据 12分钟才到 那么你可以设置。时间为 0-10分钟这个窗口内的数据 第二次 为 1-11分钟这个窗口内的数据 以此类推。比如如下为 10分钟一个窗口 然后间隔时间为 1分钟那么 第一次计算的窗口。允许延迟的时间
关于kafka***** cannot be cast to class java.lang.String
加了重试机制 env.setRestartStrategy(RestartStrategies.failureRateRestart(3,Time.of(5000, TimeUnit.SECONDS),Time.of(5000,TimeUnit.SECONDS)));失败的任务只会重试几次。这里就报了java的最常见错误 空指针,原因就是flink要把kafka的消息getbytes。还有此时ka
kafka启动报错 Invalid config, exiting abnormally (org.apache.zookeeper.server.quorum.QuorumPeerMain)
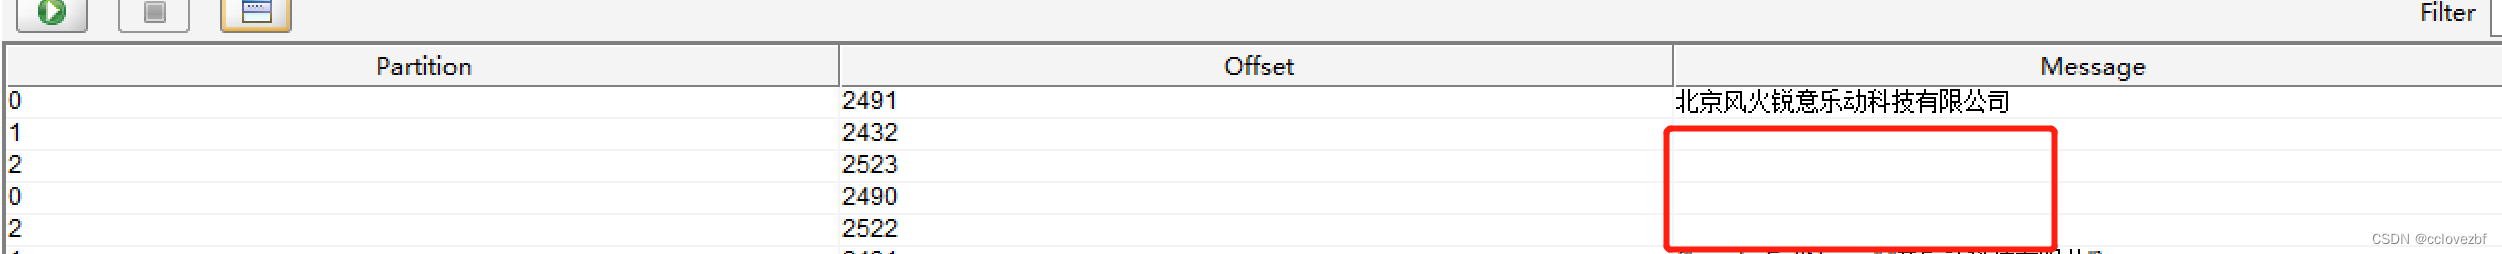
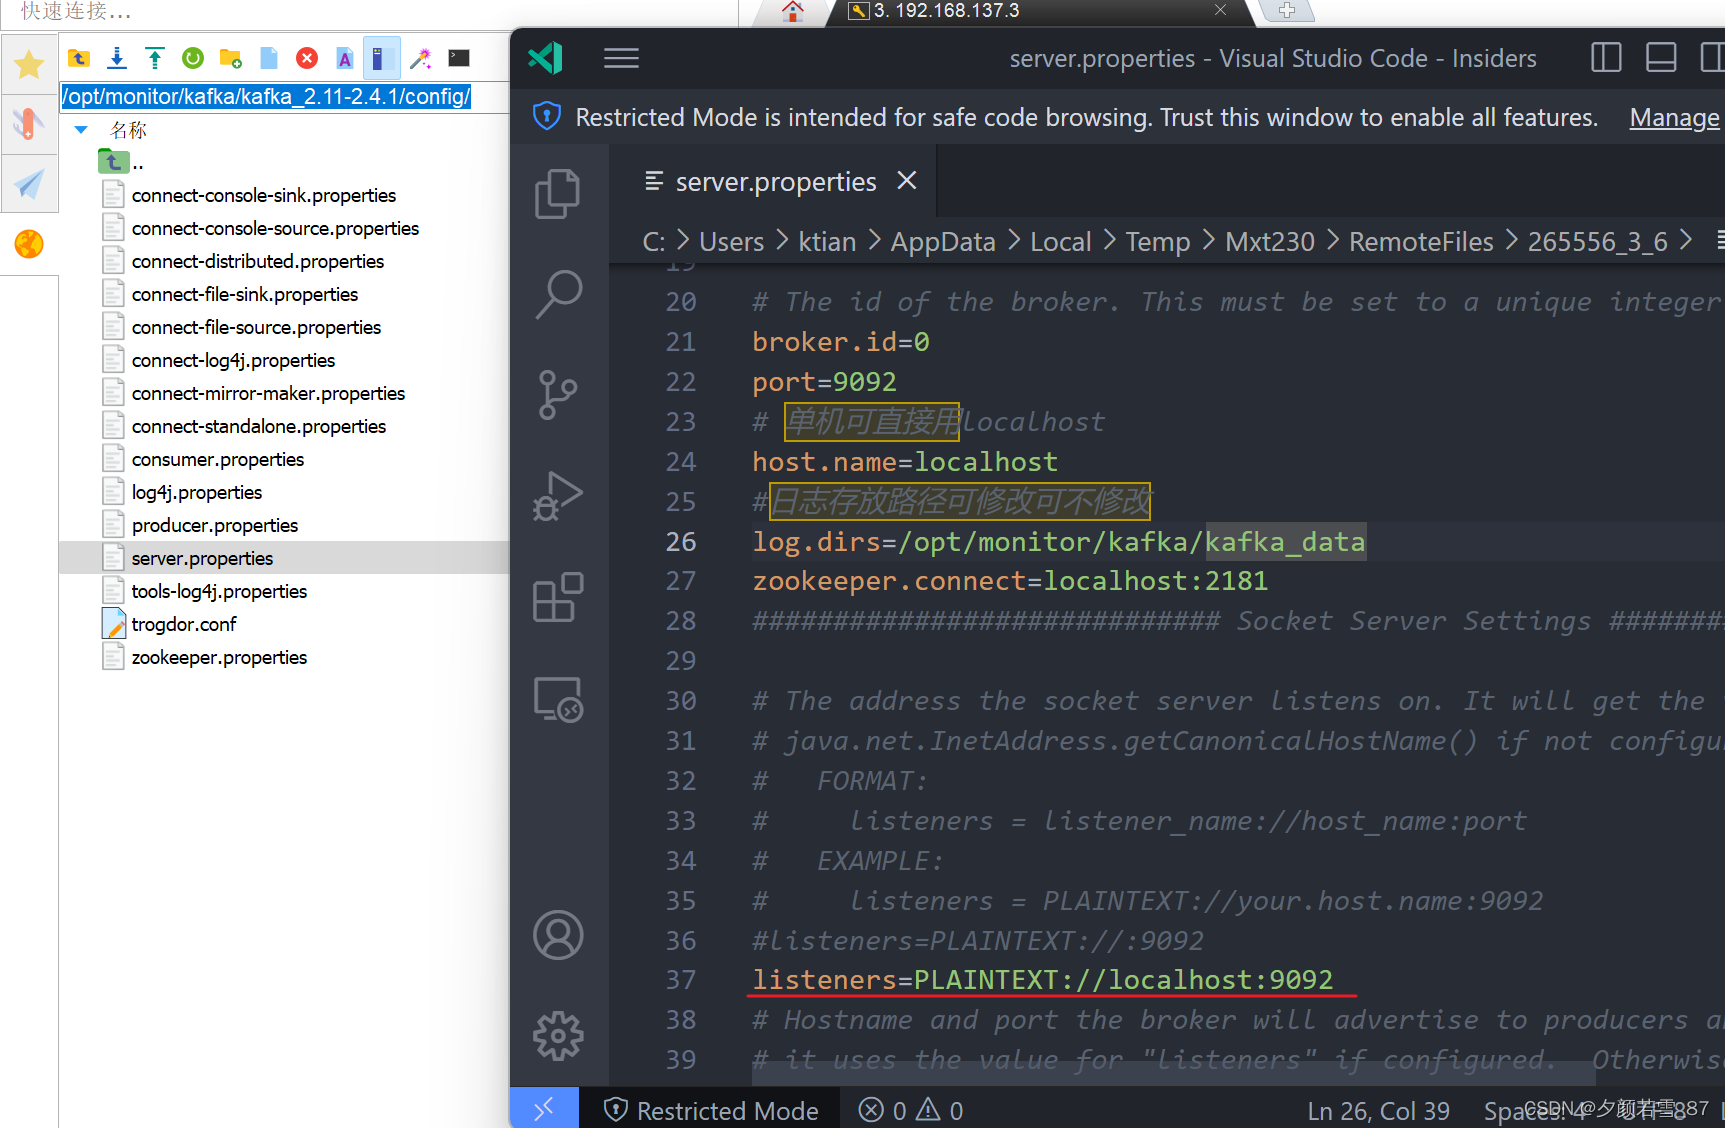
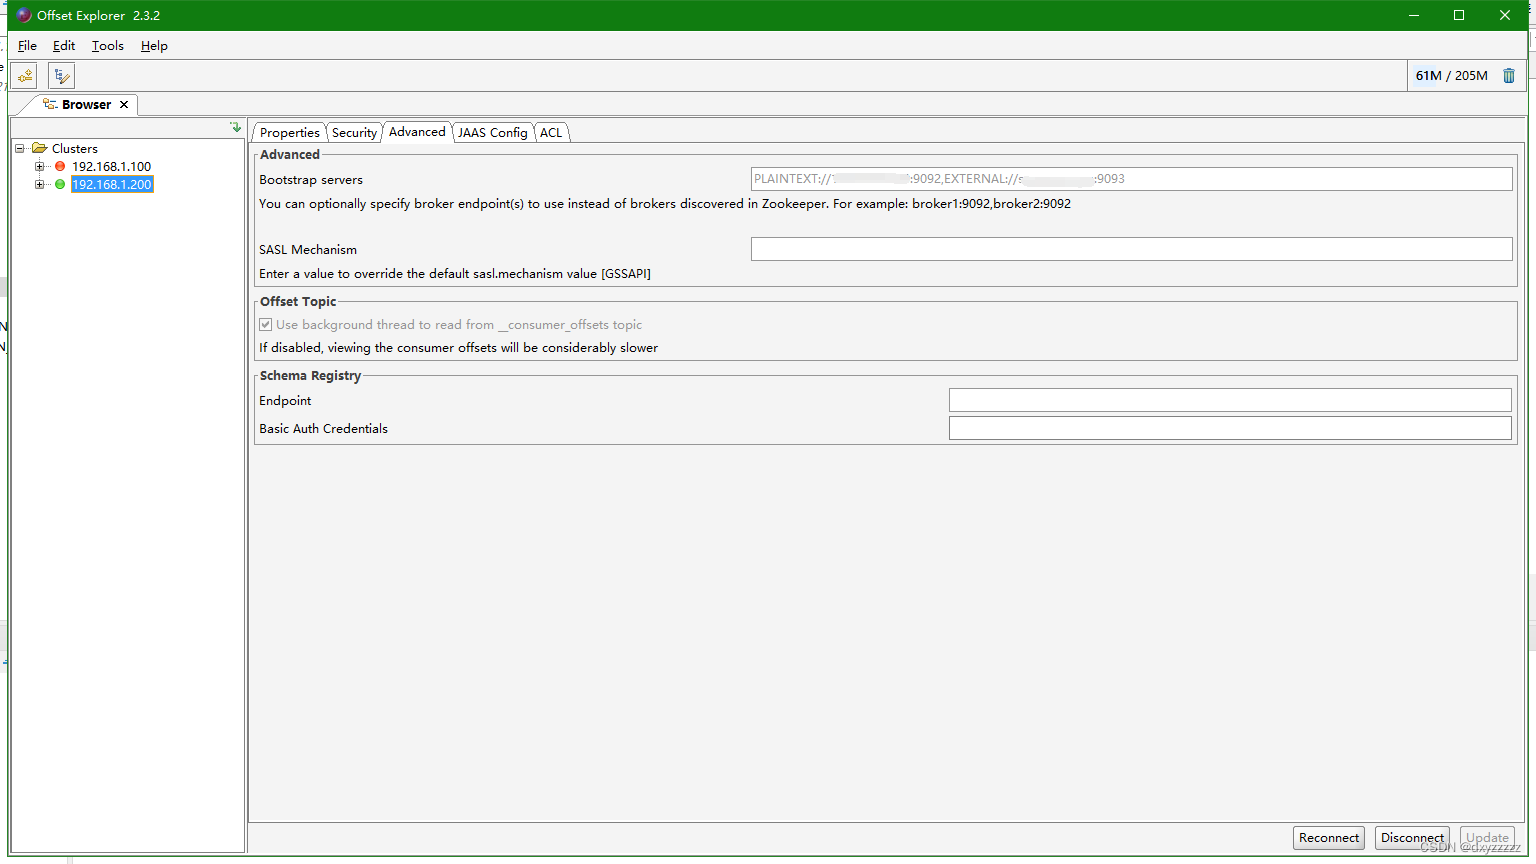
advertised.listeners=啥就复制啥过去 offset Explorer的bootstrap servers填上。大概就是有多个监听 要引导一下,不知道别的工具要不要这样,没找到别的免费工具啊。连自己弄的kafka很正常,连项目用的 一直报错。看看server.properties里。
Flink 是一个分布式数据处理框架,Kafka 是一个高性能的消息队列,HBase 是一个分布式高可用的 NoSQL 数据库。在上面的代码中,我们首先创建一个 Kafka 数据源,从 Kafka 中读取数据。然后,我们将 Kafka 中的数据转换为 HBase 行,并使用 HBaseSink 将 HBase 行写入 HBase 中。需要注意的是,在 HBaseSink 中,我们使用 HBase
flink消费kafka数据开窗丢失数据问题
Kafka 都有哪些特点?- 高吞吐量、低延迟:kafka每秒可以处理几十万条消息,它的延迟最低只有几毫秒,每个topic可以分多个partition, consumer group 对partition进行consume操作。- 可扩展性:kafka集群支持热扩展- 持久性、可靠性:消息被持久化到本地磁盘,并且支持数据备份防止数据丢失- 容错性:允许集群中节点失败(若副本数量为n,则允许n-1个
kafka基于SASL/SCRAM 集合zookeeper SASL,实现安全认证、权限校验ACL。
环境winmysql5.7如果不想看步骤可以直接下载我打包好的文件,修改相关数据库配置就行。
flink sql client:upsert-kafka connector
flink sql sink 到kafka中的分区匹配规则
idea代码如下:package KafkaFlink;import org.apache.flink.api.common.functions.FlatMapFunction;import org.apache.flink.api.common.serialization.SimpleStringSchema;import org.apache.flink.api.java.tuple.Tupl
背景:flink的datastream部署到线上时,发现数据只能写入到kafka的一些分区,其他分区没有数据写入。当把flink的并行度设置大于等于kafka的分区数时,kafka的分区都能写入数据。于是研究了一下源码。FlinkFixedPartitioner源码:package org.apache.flink.streaming.connectors.kafka.partitioner;im
前言篇:为了节约成本,决定通过自研来改造rocketmq,添加任意时间延迟的延时队列,开源版本的rocketmq只有支持18个等级的延迟时间,其实对于大部分的功能是够用了的,但是以前的项目...
这里写自定义目录标题操作流程基础环境准备zookeeper目录一览ZooKeeper常用配置项说明kafka架构java部署zookeeper集群部署zookeeper配置zookeeper启动zookeeper集群查看&连接测试kafka集群部署kafka配置kafka启动kafka测试操作流程基础环境准备名称版本获取方式jdkjdk-8u181-linux-x64.rpmhttps:/
方案一 DataStream方式写入clickhouse方法主入口public class DataClean {public static void main(String[] args) throws Exception {StreamExecutionEnvironment bsEnv = StreamExecutionEnvironment.getExecutionEnvironment(
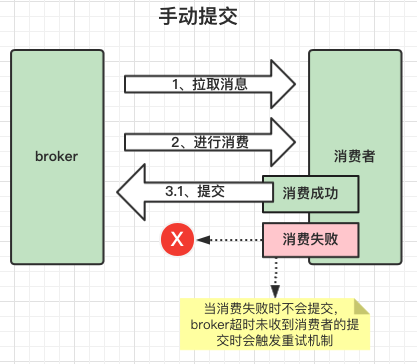
1、防止消息丢失发送方将ack设为1或者-1/all,可以防止消息丢失;如果要做到99.99999%防止丢失,把ack设为all,把min.insync.replicas设为你的集群分区副本的数量即可;# 表示要将消息刷入集群环境的2个副本中后,才会返回ack;min.insync.replicas=2消费方把自动提交改为手动提交,也就是说当我消费成功后才会进行提交。如果设为自动提交的话,那么不管
写在前头:更多大数据相关精彩内容请进我的知识星球,每周定期更新正篇技术路线:实时数据——>kafka——>flink——>mysql1、 实时数据:参考链接,该链接是如何用python写kafka生产者程序2、flink:这里我们直接在本地开发环境Pycharm跑的程序,就不需要安装flink了,感兴趣Linux镜像安装部署flink的可以参考该链接。3、模拟数据为客流数据:客流
前言:最近在做kafka、mq、redis、fink、kudu等在中间件性能压测,压测kafka的时候遇到了一个问题,我用jmeter往kafka发消息没有时间戳,同样的数据我用python发送就有时间戳,且jmeter会自动生成错误的变量key,那我是怎么解决的呢,容我一一道来!一、jmeter怎么往kafka发送数据jmeter往kafka发送数据我之前有写过博客,大家可以参考下,遇到我前言说
flink基本原理与kafka数据处理实践基本原理简介工作原理flink算子说明与代码解析MapFliteFlatMapKeyby分组后的聚合或数值运算Reduceflink的窗口计数窗口countWindow滚动窗口滑动窗口slidingWindowSession窗口EventTime窗口kafka数据处理实践flink数据处理流程flink处理kafka数据功能及环境说明功能说明kafka环境
一、为什么需要配置TLS的MQTT服务器?1.因为配置了TLS的MQTT服务器,可以使得传输数据更安全,满足部分对此需求的客户。二、如何配置TLS的MQTT服务器?1.首先在本地电脑搭建openssl环境,具体操作可以参见该博客https://blog.csdn.net/zyhse/article/details/108186278。2.先区分什么是对称加密和非对称加密,这对理解TLS很关键;对称
用kafka Tool连接kafka时,报错;org.apache.zookeeper.KeeperException$NoNodeException: KeeperErrorCode = NoNode for /broker/ids解决办法:将chroot path 设置为 /kafka
在线监控工具ES-head,不用安装http://www.wgstart.com/elasticsearch-head/index.html
version: '2'services:zookeeper:image: wurstmeister/zookeeperports:- "2181:2181"networks:- "kafka_net"kafka:image: wurstmeister/kafka:2.12-2.3.0ports:...
bin/zookeeper-shell.sh作用是连接zookeeper,并通过命令查询注册的信息,本质上就是zookeeper的语法。bin/zookeeper-shell.sh zookeeper_host:port[/path] [args…]args参数类型如下stat path [watch]set path data [version]ls path [watch]delq...
EndOfStreamException: Unable to read additional data from client sessionid 0x16b0bd525660003, likely client has closed socket简单说明一下这个错误是我在测试kafka时遇到的问题开始按照该网址说明安装kafka,访问Kafka官方下载页面,下载稳定版本2.11-0.10...
目录1、到底什么是连接?2、为什么每次发送请求都要建立连接?3、长连接模式下需要耗费大量资源4、Kafka遇到的问题:应对大量客户端连接5、Kafka的架构实践:Reactor多路复用6、优化后的架构是如何支撑大量连接的“这篇文章,给大家聊聊:如果你设计一个系统需要支撑百万用户连接,应该如何来设计其高并发请求处理架构?(1)到底什么是...
环境为 ubuntu 16.04,ip:192.168.1.100,单机模式0x00.JAVA环境搭建0x01.kafka环境搭建1. zookeeper启动:./zkServer.sh start-foreground2. kafka为了使kafka能够通过ip访问,需要修改`conf/server.properties`文件:advertised.lis...
kafka的高性能、流式响应、对大数据支持是有目共睹的,在我们内部项目product-search有使用CDC的解决方案,而kafka成为该方案的输出源,此时各个业务方只需要去订阅消费即可。1. 问题描述有一天有开发人员找到我:我的consumer端消费kafka为何有时候可以消费到数据,有时候不行?dev环境我自己试了是没有问题的,而test环境就不行,不行的时候系统也没有任何报错信息...
问题描述:主机信息:IPhostname10.0.0.10host1010.0.0.12host1210.0.0.13host13在这三台主机上部署一套zookeeper&kafka集群环境的时候,zk集群进程和端口都起来了。然后在启动kafka的时候,报错了,提示连不上zk。因为该环境要求必须开启防火墙,所以想到应该是因为...
job中使用Kafka DirectStream 读取topic中数据,然后做处理。其中有个测试job,停止了几天,再次启动时爆出了**kafka.common.OffsetOutOfRangeException**。下文记录下异常分析与解决过程。
Kafka和RabbitMQ的核心架构对比:Kafka采用分区副本机制(Leader+Follower),基于JVM实现,依赖Zookeeper或KRaft协调,定位为高吞吐的分布式日志系统,适合日志流和事件源场景;RabbitMQ基于Erlang虚拟机,采用Exchange-Queue路由模型,支持多协议,属于消息队列路由器,更适合任务队列和灵活路由。两者设计哲学不同,Kafka侧重持久化有序日
这种轻量级的设计在2025年的混合云部署实践中展现出独特价值,特别是在跨地域、多可用区的复杂网络环境下,NameServer的简单可靠成为系统稳定性的重要保障。无论是轻量级的NameServer设计,还是灵活的消息模型,亦或是完善的事务支持,都体现了阿里系技术产品对实际业务场景的深刻理解。分区的设计是Kafka高吞吐量的关键。根据行业调研数据显示,在全球财富100强企业中,超过80%的企业在其核心
Zookeeper是一个分布式协调服务,专门为分布式应用提供高效可靠的协调、同步、配置管理和故障恢复等功能。它的设计目的是简化分布式系统的管理,保证多个节点之间的数据一致性和协调工作。Zookeeper 提供了类似文件系统的层次化命名空间,用来存储和管理元数据,确保分布式应用的高可用性和强一致性。Kafka 是一个分布式的基于发布/订阅模式的消息队列(MQ,Message Queue),主要应用
kafka
——kafka
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 乐奇 Rokid 开放社区