登录社区云,与社区用户共同成长
邀请您加入社区
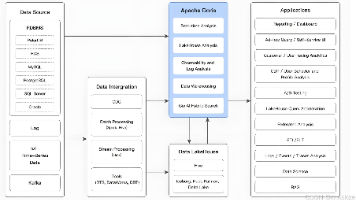
Apache Doris 使用 MySQL 协议,高度兼容 MySQL 语法,并支持标准 SQL。用户可以通过各种客户端工具访问 Apache Doris,它还能与商业智能(BI)工具无缝集成。存算一体架构,由2部分构成:前端(FE):主要负责处理用户请求、查询解析与规划、元数据管理以及节点管理任务。后端(BE):主要负责数据存储和查询执行。数据被分区成多个分片,并在 BE 节点上以多个副本的形式
本文旨在为大数据工程师和架构师提供构建实时推荐系统的完整指南。Flink在实时推荐系统中的核心作用推荐系统的基本架构和关键组件实时特征计算和模型更新的技术实现系统性能优化和扩展性考虑首先介绍推荐系统和Flink的基本概念然后深入分析推荐系统的核心算法和数学模型接着通过完整项目案例展示实现细节最后讨论实际应用中的挑战和解决方案Flink:Apache Flink是一个分布式流处理框架,支持有状态的计
首先需定义与 Doris 表结构对应的 POJO 类。假设 Join 后的结果包含userIdorderIdamount// 无参构造函数(Flink POJO 必须)// 全参构造函数// Getter/Setter 方法(Flink 反射依赖)// 其他字段类似...通过 Flink-Doris-Connector 实现 Join 结果写入 Doris 的核心步骤包括:对象封装、序列化、Sin
【代码】flink执行sql文件代码。
【代码】paimon表做flink维表 实时join。
以下操作会引入状态:(1)聚合:SUM, COUNT, AVG, MAX, MIN 等。(2)窗口:TUMBLE, HOP, SESSION, CUMULATE 等。(3)JOIN:时间窗口 Join、流对表 Join。(4)DISTINCT去重操作 和 GROUP BY 分组操作。(5)OVER 窗口:滑动窗口聚合。(6)TOP N:ROW_NUMBER(), RANK() 等。(7)自定义 U
【代码】Flink CDC 3.1.0 pipeline 多表合一 yaml。
配置相关视频讲解:C语言程序设计入门之环境安装Flink on Yarn启动Session指定队列教程一、整体流程下面是启动Flink on Yarn Session并指定队列的步骤:步骤描述1准备Flink程序jar包和配置文件2启动Yarn集群3提交Flink on Yarn...
flink cdc mysql Elasticsearch
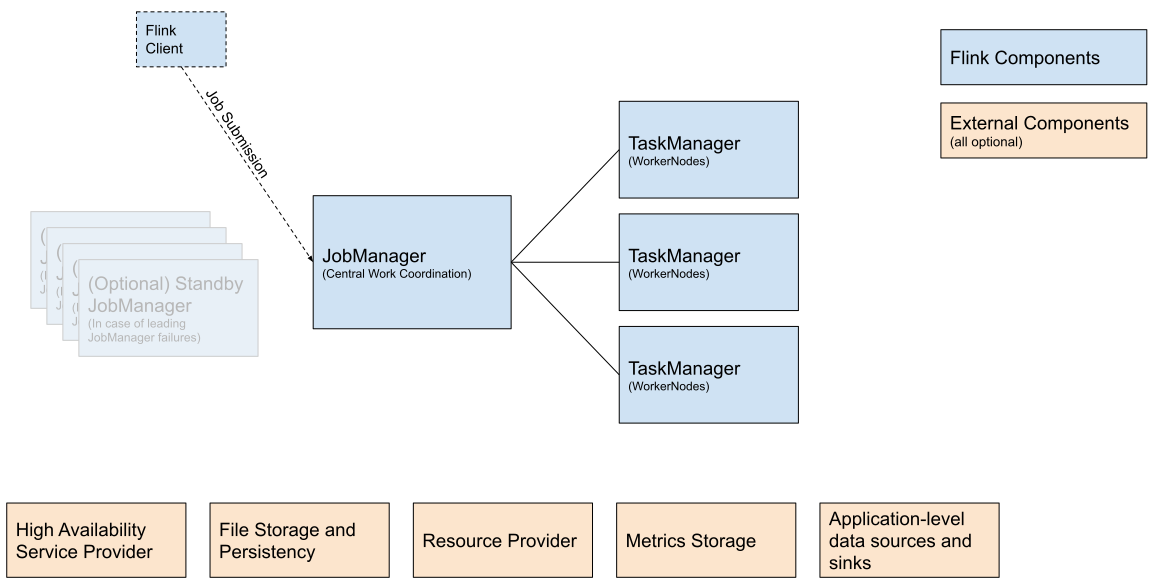
分别对应 jobmamager taskmanager taskslot 由 taskslot 执行任务 每个。时间为 0-10分钟这个窗口内的数据 第二次 为 1-11分钟这个窗口内的数据 以此类推。比如如下为 10分钟一个窗口 然后间隔时间为 1分钟那么 第一次计算的窗口。根据数据条数触发计算 比如如下就是 每来五条计算一次 并且并行度 等于1。根据固定时间确定一个窗口 然后间隔一定的时间触发
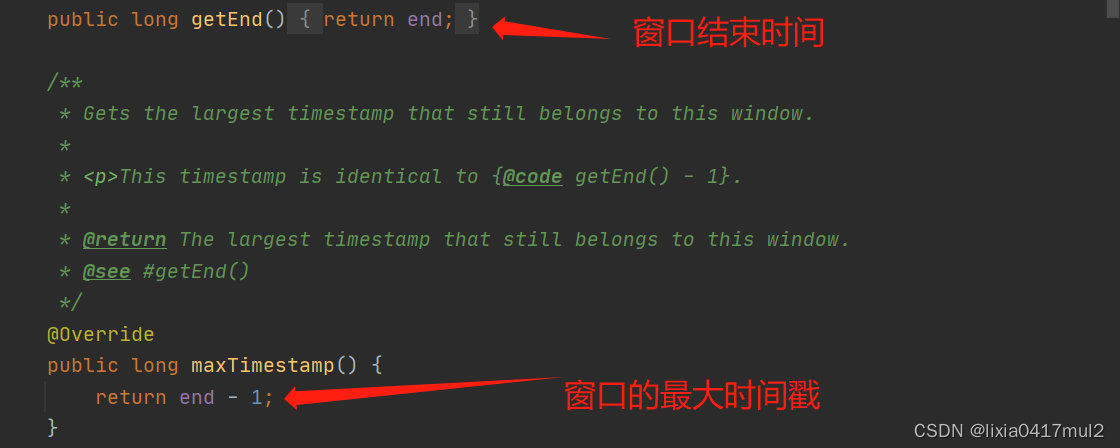
水位线 = 12-2 = 10>10(窗口时间) 那么这个时候刚好可以触发计算 12分钟到的那条数据也被包含在了这个窗口。举个例子 当前 窗口时间为10分钟 但是有一条本应该9分钟到的数据 12分钟才到 那么你可以设置。时间为 0-10分钟这个窗口内的数据 第二次 为 1-11分钟这个窗口内的数据 以此类推。比如如下为 10分钟一个窗口 然后间隔时间为 1分钟那么 第一次计算的窗口。允许延迟的时间
在Apache Flink中,`Row` 是一个通用的数据结构,用于表示一行数据。`Row` 可以看作是一个类似于元组的结构,其中包含按顺序排列的字段。在这个例子中,我们首先定义了一个 `RowTypeInfo`,描述了 `Row` 中两个字段的数据类型。然后,我们创建一个 `Row` 对象,设置了两个字段的值,并最后访问了这些字段的值。`Row` 的字段可以是各种基本数据类型,例如整数、字符串、
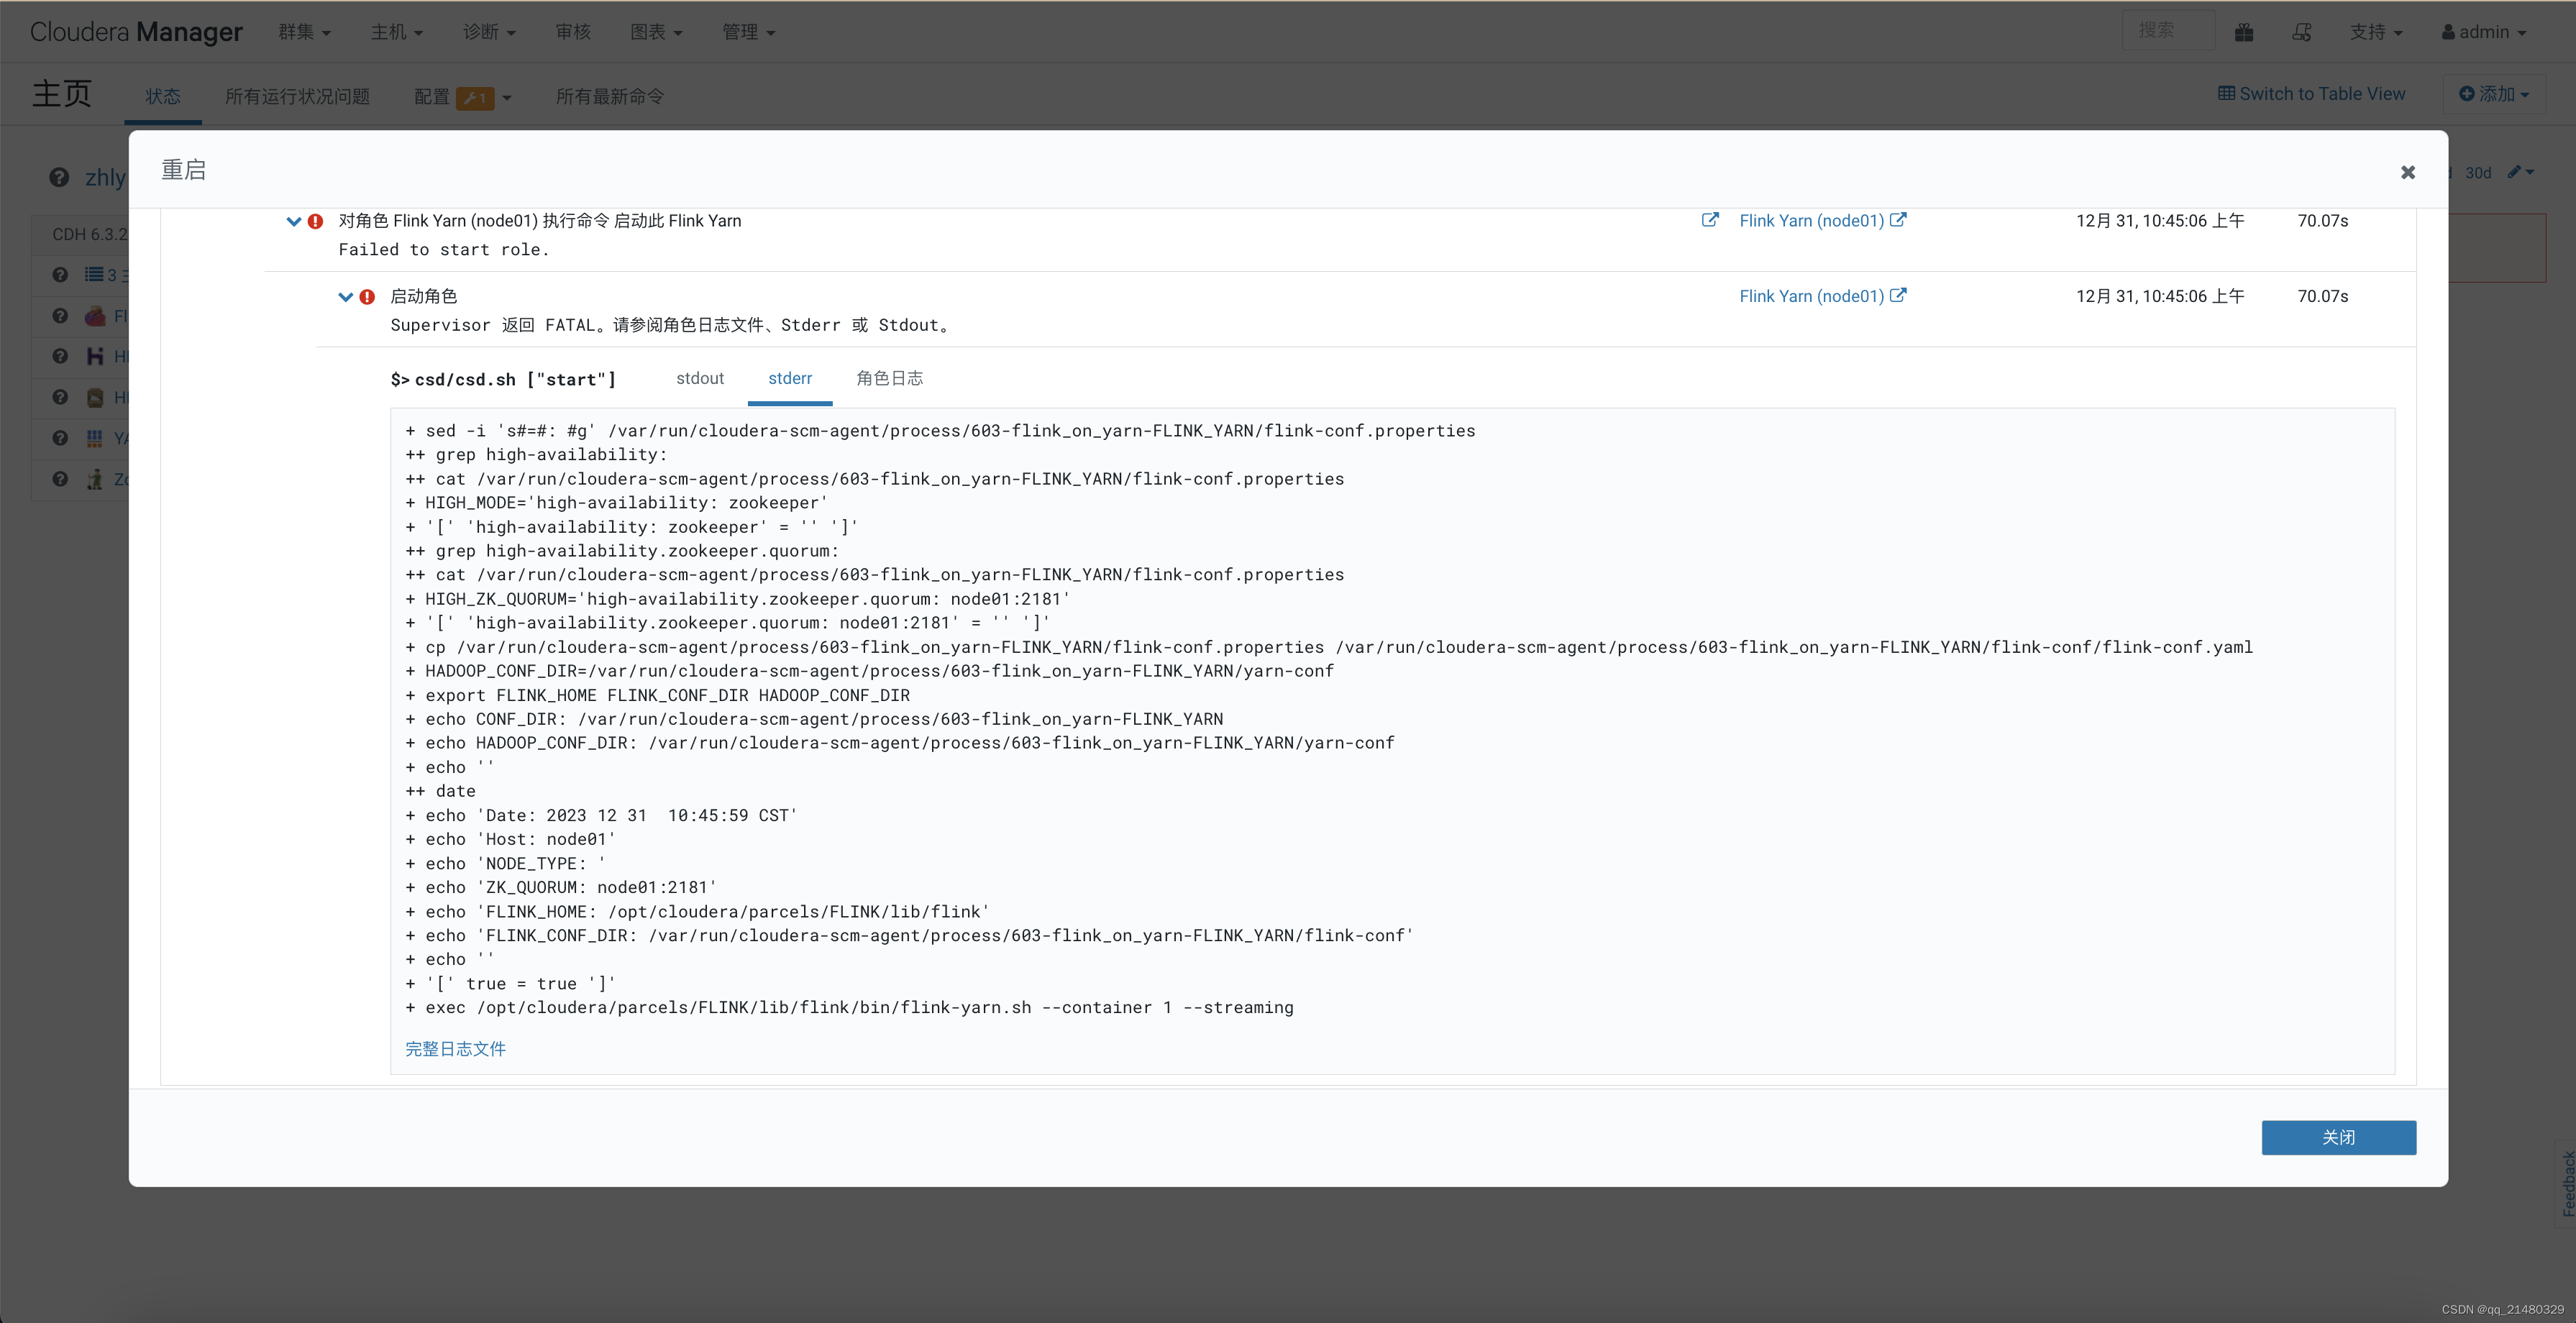
CDH 6.3.2集成flink 1.18.0 zookeeper版本不匹配
Buffer pool is destroyed 异常
窗口分配器
Release Announcement Version 1.2.2Apache IoTDB v1.2.2 已经发布,主要增加了 flink-sql-iotdb-connector 插件、tsfile 文件级级联传输、count_time 聚合函数等新特性,优化了 Limit & Offset 查询性能、ConfigNode 重启逻辑等,并提升压缩效果、删除操作效率、对齐序列合并速度...
在centos虚拟中安装flink,并通过windows访问其webui,很容易出现的坑,一个是flink-conf.yaml配置文件相关配置,还有一个是防火墙
加了重试机制 env.setRestartStrategy(RestartStrategies.failureRateRestart(3,Time.of(5000, TimeUnit.SECONDS),Time.of(5000,TimeUnit.SECONDS)));失败的任务只会重试几次。这里就报了java的最常见错误 空指针,原因就是flink要把kafka的消息getbytes。还有此时ka
类似这种字段映射(异常1,在flink sql中来源表和目标表的对应字段的类型不一致)或 在来源表插入值后,作业报转换异常(异常2,在flink sql中来源表的字段类型配置错误)等,却没有指明是哪个字段的问题时,可以通过覆写RowDataDebeziumDeserializeSchema类型,自己去添加父异常指明有问题的字段名称。异常1,如图:java.lang.UnsupportedOpera
Flink 是一个分布式数据处理框架,Kafka 是一个高性能的消息队列,HBase 是一个分布式高可用的 NoSQL 数据库。在上面的代码中,我们首先创建一个 Kafka 数据源,从 Kafka 中读取数据。然后,我们将 Kafka 中的数据转换为 HBase 行,并使用 HBaseSink 将 HBase 行写入 HBase 中。需要注意的是,在 HBaseSink 中,我们使用 HBase
flink提交任务报错:org.apache.flink.shaded.zookeeper3.org.apache.zookeeper.KeeperException$NoAuthException: KeeperErrorCode = NoAuth for /flink_base/flinkserver-193793206/flink_base目录 对应提交用户没有权限登录zookeeper c
flink消费kafka数据开窗丢失数据问题
本文为 flink 1.16 官网中部署相关部分的内容翻译整理。
Flink是一个分布式流处理框架,可以将数据流从多个数据源加载到内存中,并对数据流进行转换和计算。Doris是一个分布式的列式存储系统,可以将大量的数据存储在列式表中。要在Flink中连接Doris,您需要使用Flink的Doris Connector。下面是一些步骤来连接Doris:在Flink项目中添加Doris Connector依赖。创建Doris连接。设置Doris连接参数,包...
重磅!flink-table-store将作为独立数据湖项目重入apache,项目名 Paimon
本文通过一个具体案例,说明 flink sql 如何实现 connector 加载、source/sink 端操作、数据库连接等。可以帮助大家了解其原理,并在代码中找到落库执行SQL生成逻辑,得到where条件并没有下推到库执行的结论。
CUMULATEflink iceberg
Yarn Session 启动成功后,会创建一个/tmp/.yarn-properties-root文件,记录最近一次提交到 Yarn 的 Application ID,执行以下命令启动 SQL 客户端命令行界面,后续指定的 Flink SQL 会提交到之前启动的 Yarn Session Application。作业执行的顺序不受部署模式的影响,但是会受启动作业的调用方式影响。为每一个应用启动一
flink 1.12.0flink 1.12.0的flink-connector-jdbc死锁DriverManager死锁
本文基于 flink 1.15 官网中对于 flink sql 格式的翻译整理。
本文为 flink 1.14 官网中对 flink sql format 格式的翻译整理。
如图,flink安装好后,Task Slots一直是0.修改过很多地方的设置,如jobmanager.memory.process.size: 5gb。最后修改这个地方:最配置文件最后添加一行,重启服务即可。
因为http的数据一般很少,我这个是看班车的数据 一天差不多是3w多条。需求很奇怪,但是无所谓了。
flink application模式下计算taskmanager内存大小划分。
flink sql client:upsert-kafka connector
flink多种模式的安装部署
如何解决:Code: 210. DB::NetException: Connection refused (localhost:9000)
这里SeaTunnel项目连接ClickHouse用JDBC封装接口。
flinktaskmanager报错Connection refused
flink中维表Join
在本地调试时希望启动Flink Web UI 查看DAG图,watermark等信息,那么该如何做呢?
flink中状态如果不清理就会越来越大,实际上很多状态是可以清理的,比如说我们在计算日活时,使用日期作为key划分流,为了过滤掉重复的用户,在每个key内都维护了一个MapState。而我们实际上只关注当前日期的日活(因为之前的日活我们已经知道了),所有可以将之前日期的状态都清理。手动清理很麻烦,我们可以为状态设置超时时间,当超过这个时间之后,flink会自动清除这些数据:...
flink sql sink 到kafka中的分区匹配规则
自用flinkmaven依赖
flinkflink 版本:flink-1.10.1flink部署目录: /data/flink/flink-1.10.1flinkxflinkx基于flink做的开源数据集成服务,目前改名DTStackflinkx 版本:flinkx_1.10部署目录: /data/flinkx/flinkx_1.10flinkx插件分发脚本需要分发到所有yarn nodemanager节点#!/bin/bas
flink运行模式可以划分为session模式和非session模式,session模式下,不需要在任务运行时像外部申请资源,资源的申请和释放都通过flink自己控制,如yarn-session模式,standalone模式,非session模式的资源控制交给外部系统,如application模式,per-job模式。实际上不同模式下最重要的区别是组件运行时机和资源控制权的问题,大部分代码逻辑相差
Java 开发flink 流/批处理程序文章目录Java 开发flink 流/批处理程序一、安装`pom`依赖,配置打包插件以及入口类二、编写`Flink`程序三、完整的java代码四、测试一、安装pom依赖,配置打包插件以及入口类<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.o
idea代码如下:package KafkaFlink;import org.apache.flink.api.common.functions.FlatMapFunction;import org.apache.flink.api.common.serialization.SimpleStringSchema;import org.apache.flink.api.java.tuple.Tupl
背景:flink的datastream部署到线上时,发现数据只能写入到kafka的一些分区,其他分区没有数据写入。当把flink的并行度设置大于等于kafka的分区数时,kafka的分区都能写入数据。于是研究了一下源码。FlinkFixedPartitioner源码:package org.apache.flink.streaming.connectors.kafka.partitioner;im
flink
——flink
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区