- @weixin_61006262


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文系统解析监督微调(SFT)的核心原理与实践要点:从“指令-回答”数据构建模型响应习惯,强调数据质量(一致性、准确性、多样性等)决定成败;引入LoRA技术实现高效微调,降低显存需求;详解学习率、alpha、rank等参数调优策略;揭示“不完全学习”现象——loss下降不代表全学会,需回测训练集发现问题;最后指出SFT局限:无法对齐回答质量,易引发遗忘。建议以高质量数据为先,结合LoRA与科学评估

这里一定要记住,在根目录里面运行,不要再html文件夹里面,因为nginx自动认为在所有的文件里找conf,html里面是你的项目打包文件,肯定没有conf。大家进入nginx解压包里面是千万千万不要点nginx.exe文件(点了会直接再后台自动运行,我们就没有办法操作了)在进入文件夹后直接在更目录下面输入cmd进入管理员运行处就可以。注意,这里的报错flase是正常的,没有什么问题。这个问题有很

我们在启用nginx的时候文件夹位置就不正确,应该在nginx文件夹位置的根目录下进行,而不是html目录。最后用nginx中的语法,http-server。记得之前的要关掉,不然端口号会占用。但后面的文件的是在登录网站后显示nofound。原因我一直搞不懂,最后查了好多文章终于找到了。开启服务器,是怎样,其实是正常的。

Source: 数据源,Flink 在流处理和批处理上的 source 大概有 4 类:基于本地集合的 source、基于文件的 source、基于网络套接字的 source、自定义的 source。Flink的所有操作都称之为Operator,客户端在提交任务的时候会对Operator进行优化操作,能进行合并的Operator会被合并为一个Operator,合并后的Operator称为Opera
针对问题三,我们选取问题一提取的特征峰数据,对不同的包衣时间段各谱区的吸收值,最优包衣在谱区的吸收值和素片在谱区的吸收值进行Bayes判别。以问题二的聚类结果为基础数据,对问题一所提取的特征峰数据标记初始分组,通过Bayes准则下的判别分析方法,对数据进行判别再次划分类别,通过比对Bayes判别前后样本所属类别与初始分组是否一致,计算判别的准确性。对于解决不确定统计分析的问题,每个类别的样本取得不
主要以安大略湖为核心,其它湖为次要考虑因素的利益相关者的分析。1. Lake Ontario 水位管理模型:1.1 水位控制因素:- 湖泊补给源: 入湖流量 I(t)- 湖泊排水源: 排水流量 O(t)- 湖泊蒸发: 蒸发量 E(t)- 湖泊降雨: 降雨量 R(t)- 湖泊人工控制: 人工控制量 U(t)1.2 水位模型:湖泊水位模型可以采用动态水库模型:2. 利益相关方和目标分析:2.1 利益相
本文通过模糊综合评价算法对2013年到2021年的中医药市场状况做定性分析和评判,旨在通过数学模型寻找到中医药市场现状和所涉及中医药市场影响因素之间的关系、对于中国医药市场现状的分析理解以及近9年中医药市场影响因素对中医药市场的综合影响作用大小变化。其中,影响因素的权重分配对评价结果的影响较大,本文采用熵值法和灰色关联度法的权重集来建立模糊综合评价模型,利用这两种方法计算得到的权重略有不同,但对于
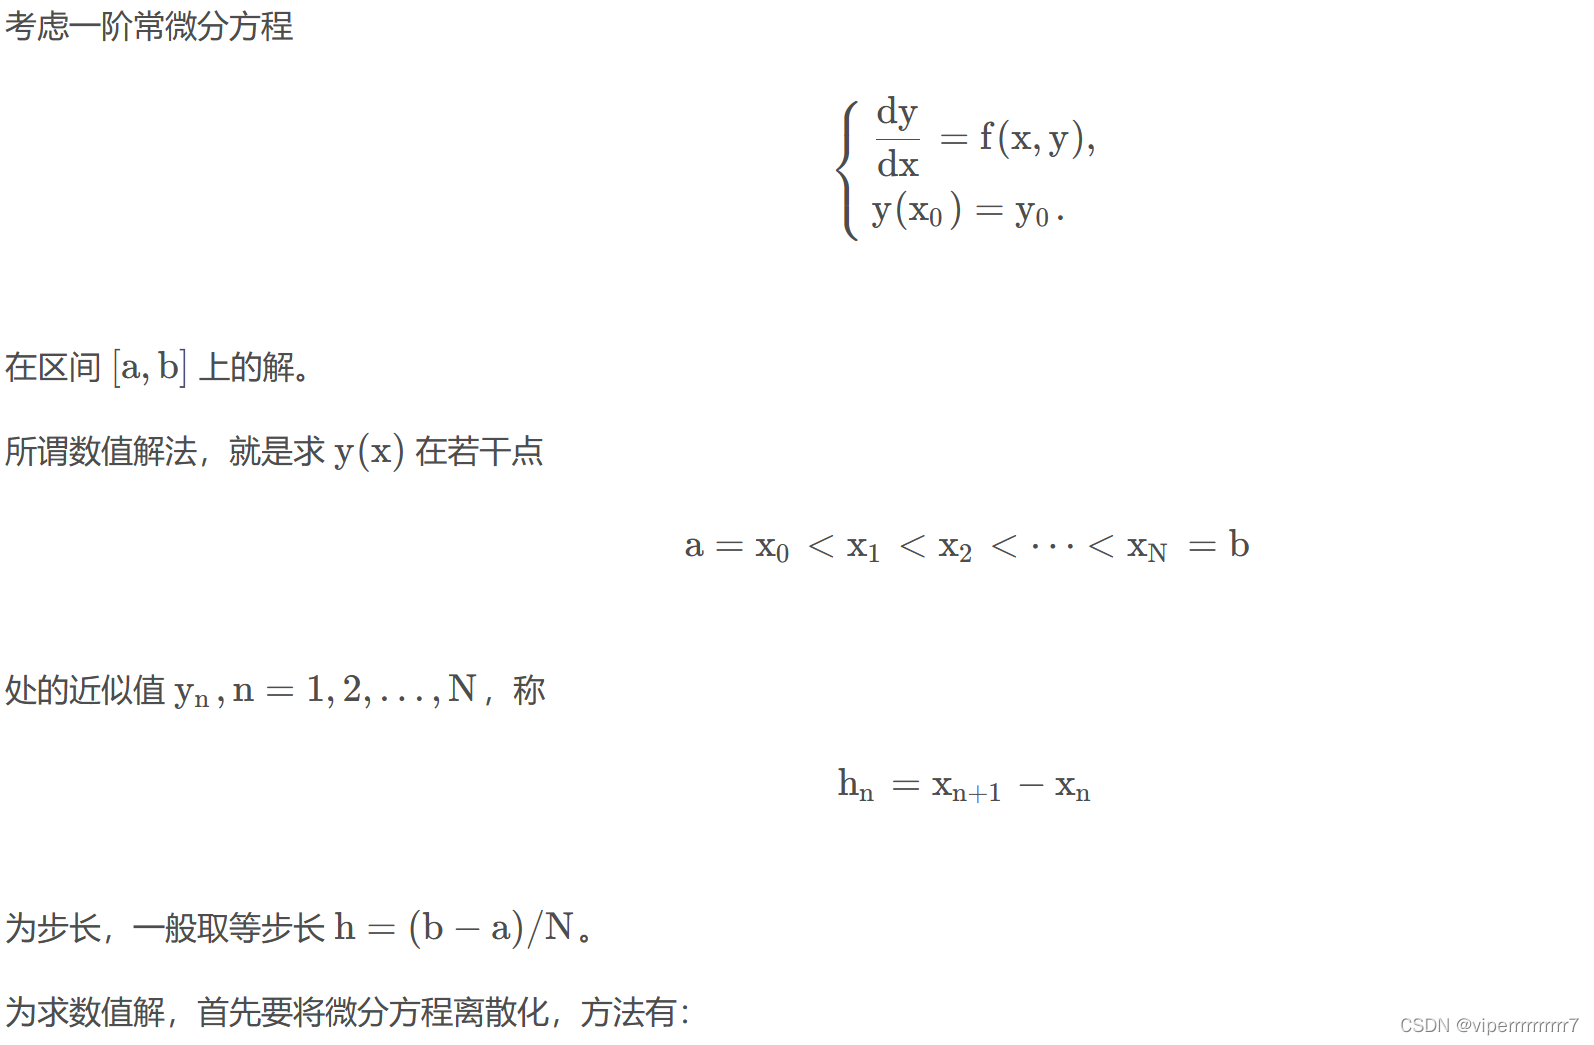
当谈到微分模型时,通常指的是使用微分方程来描述某个系统的动态行为。微分方程是描述变量之间变化率的数学方程。微分模型可以用于解决各种实际问题,例如物理学、工程学、生物学等领域。微分模型可以分为两类:常微分方程和偏微分方程。常微分方程描述的是只有一个自变量的函数的导数,而偏微分方程描述的是多个自变量的函数的导数。常微分方程的一些常见类型包括:一阶线性常微分方程、一阶非线性常微分方程、高阶线性常微分方程
Hive还提供了自己的文件格式和存储机制,例如Hive表的默认存储格式是面向列的ORC(Optimized Row Columnar)格式,这使得Hive在处理大规模数据时具有更好的性能和扩展性。因此,可以说Hive是基于MapReduce的查询和分析工具,它充分利用了Hadoop的分布式处理能力,能够对大规模数据进行高效的处理和分析。所以Hive基于MapReduce的数据仓库工具,它通过Hiv

PEFT(Parameter-Efficient Fine-Tuning,参数高效微调)是一种针对大模型微调的优化技术,核心思想是,而非全量微调,在保持模型性能接近全量微调的同时,大幅降低计算资源消耗和存储成本。