登录社区云,与社区用户共同成长
邀请您加入社区
Data Structure Visualization
个性化推荐系统通过分析用户行为数据,实现"千人千面"的精准内容匹配。其核心算法包括基于用户的协同过滤(UserCF)和基于物品的协同过滤(ItemCF),前者通过寻找相似用户推荐内容,后者基于物品相似度进行推荐。系统评估需兼顾准确度、覆盖率、多样性等指标。冷启动问题通过兴趣收集、热门推荐和内容特征匹配等策略解决。随着算法优化,推荐系统正从单纯提升点击率向平衡用户体验与商业价值的
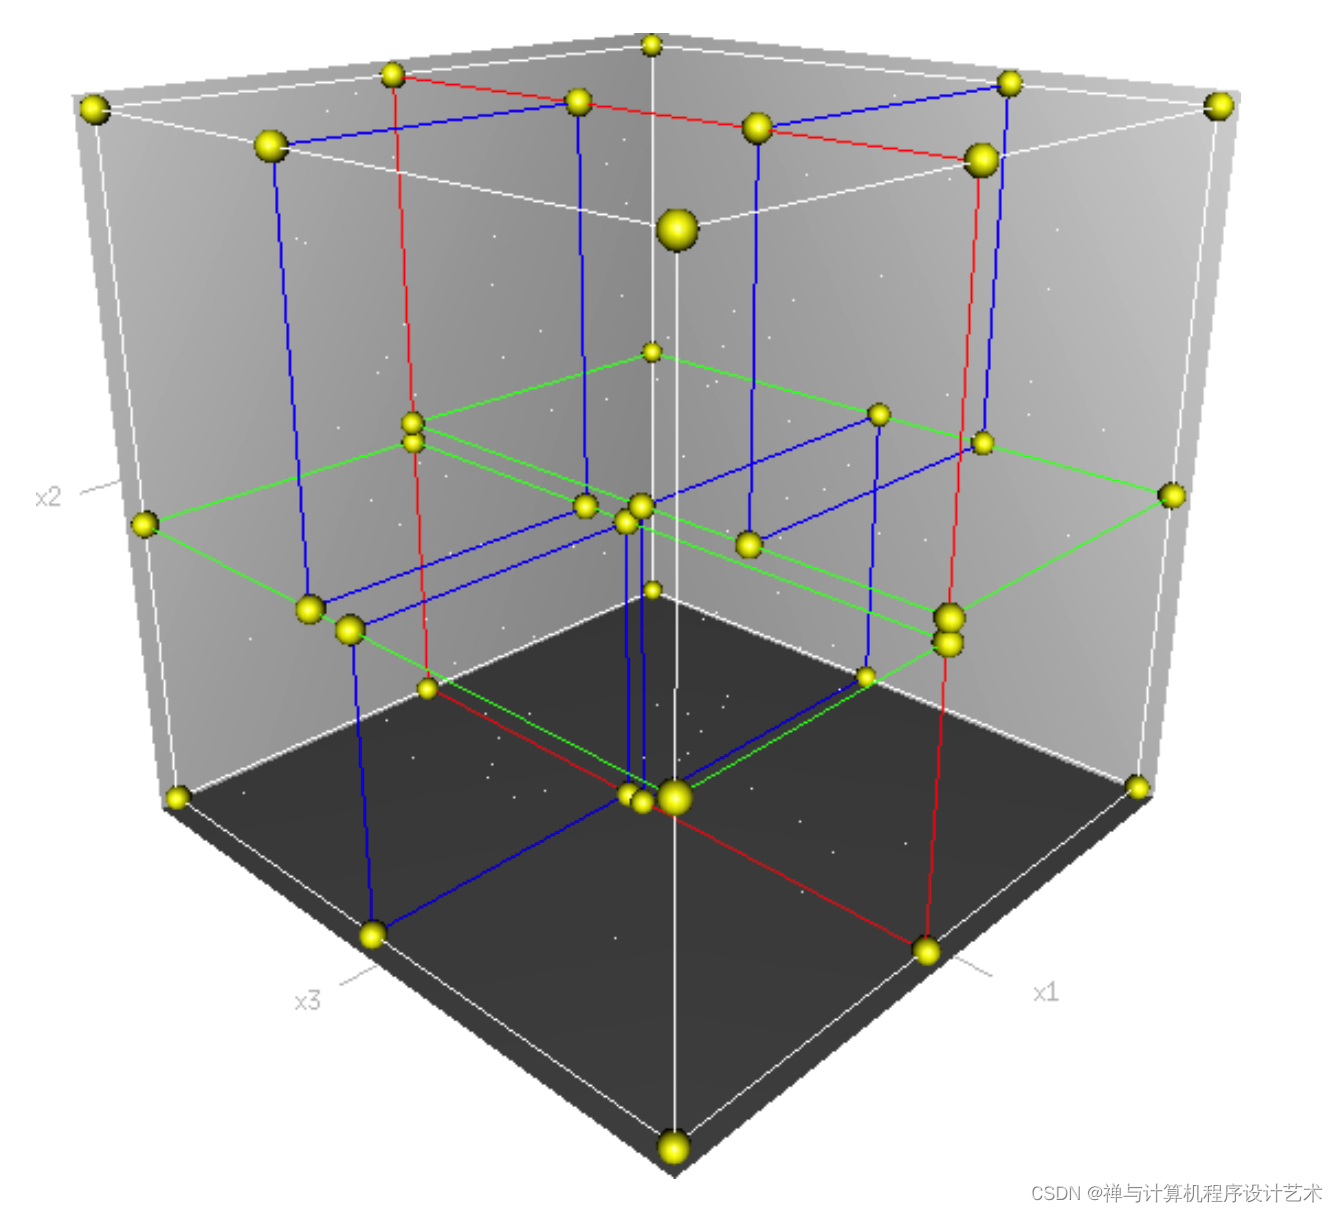
由于K-D树的结构要求,上面的例子中要求每个人的年龄和身高各项数据必须齐全,如果某个人只有年龄或只有身高,就无法使用K-D树索引了。K-D树是将K维空间中的点进行分割的数据结构,D是dimensional(维度)的缩写,K-D树是BSP(Binary Space Partitioning)的一种。很明显,K-D树和BST一样不仅可以精确查找,也更适合做范围查询,但K-D树比BST更强,它能对多个维
1 基本思想基本思想是利用评分矩阵行和列的高度相关性。数据具有内在的丰富关联性,并且生成的数据矩阵通常可以通过各条目均有数值的低秩矩阵很好地近似。潜在因子模型被认为是推荐系统中的最新技术。这些模型利用众所周知的降维方法来填充缺失的条目。降维方法通常用于数据分析的其他领域,以在少量维度中表示底层数据。降维方法的基本思想是旋转坐标轴,从而消除维度之间的成对相关性。降维方法的关键思想是可以从不完整的数据
K-近邻算法(KNN)是一种基于距离度量的监督学习算法,通过计算待测样本与训练数据的最近邻距离进行分类预测。本文介绍了KNN的核心原理、Scikit-learn实现方法、优化搜索效率的KD树结构以及关键参数K值的选择策略。KNN具有简单直观、无需训练等优点,但也存在计算成本高、对特征尺度敏感等缺点。文中通过Iris数据集案例展示了KNN的完整应用流程,包括数据预处理、模型训练与评估。该算法适用于低
想象一下,你走进一个陌生的水果市场,看到一个从未见过的水果,你想知道它是什么。KNN(K-Nearest Neighbors,K 近邻)是一种。假设你在水果市场发现了一个未知水果,你想知道它是。你有一张参考表,里面是一些已知水果的。
K近邻算法(K-Nearest Neighbors, KNN)是一种用于分类和回归的。
最近邻算法作为一种基于实例的学习方法,通过距离度量寻找与待分类样本最近的k个训练样本,并根据这些最近邻样本的类别进行分类。最近邻算法(k-Nearest Neighbors,k-NN)是一种简单且直观的分类算法,广泛应用于分类和回归问题。本文将详细介绍最近邻算法的由来、基本原理、构建过程及其优缺点。最近邻算法是一种基于实例的学习方法,其基本思想是根据距离度量寻找与待分类样本最近的k个训练样本,然后
下面是样本集(部分):409208.3269760.9539523144887.1534691.6739042260521.4418710.80512417513613.1473940.4289641383441.6697880.13429617299310.1417401.0329551359486.8307921.21319234266613.2763690.5438803674978.631
大家好,我是爱酱。本篇我们将系统讲解K-近邻算法(KNN),内容涵盖原理、数学公式、案例流程、代码实现和工程建议,适合新手和进阶者学习。详细内容涵盖:K值选择与模型表现、距离度量的选择与影响、加权KNN,分类跟回归任务都会覆盖到!注:本文章含大量数学算式、详细例子说明及代码演示,大量干货,建议先收藏再慢慢观看理解。新频道发展不易,你们的每个赞、收藏跟转发都是我继续分享的动力!注:本文章颇长近700
论文选题很重要,不是所有能确定出来条件和结果变量且能找到数据的选题就一定适合用fsQCA。建议参考:Fuzzy-set Qualitative Comparative Analysis (fsQCA): Guidelines for research practice in Informati备注:该文章仅是本人自用使用,如果有详细想法,请参照引用文献。
如果选择较小的 k 值,就相当于用较小的邻域中的训练实例进行预测,“学习”的近似误差(approximation error)会减小,只有与输入实例较近的(相似的)训练实例才会对预测结果起作用。如果选择较大的 k 值,就相当于用较大的邻域中的训练实例进行预测。简单来说: 通过距离度量来计算查询点(query point)与每个训练数据点的距离,然后选出与查询点(query point)相近的K个最
学习笔记
利用pycharm将代码同步至码云(亲测有效)
第1关:knn算法概述#encoding=utf8import numpy as npdef topK(i,k,x,y):'''input:i(int):第i个样本k(int):最近邻样本个数x(ndarray):数据特征y(ndarray):数据标签output:topK(list):样本i的最近k个样本标签'''#*********Begin********
车道保持系统(LKA)是自动驾驶中的一个重要功能,它的目标是帮助车辆在车道内自动行驶,减少驾驶员的疲劳。数据采集:通过摄像头、雷达等传感器获取车道线信息。数据处理:对采集到的数据进行处理,识别车道线的位置。决策:根据车道线的位置,计算出车辆需要调整的方向。执行:通过控制转向系统,调整车辆的方向。反馈:实时监控车辆的行驶状态,不断优化控制策略。LQR(Linear Quadratic Regulat
本文介绍了一个基于k近邻算法的文本分类系统,使用20newsgroups数据集中的3个类别(冰球、政治、太空)作为示例。系统包含完整的文本处理流程:数据加载与预处理、TF-IDF向量化、k值调优(k=5最优)、模型训练与评估。实验结果显示模型准确率达96.38%,并通过词云、混淆矩阵等可视化分析验证了分类效果。系统还支持相似文本检索功能,并实现了关键对象持久化保存。该方案具有实现简单、运行高效的特
优点:无训练过程、易于理解、适用性广;挑战:对计算资源依赖高、受高维影响严重;优化路径:标准化、降维、加速邻居搜索、参数调优、类别平衡处理。KNN凭借其“无需训练,拿来即用”的特点,是机器学习中最容易理解和实现的算法之一。虽然它在高维、高频场景中存在计算瓶颈,但通过特征工程、参数调优和搜索优化,KNN依然能够在推荐系统、图像检索、异常检测、文本分类等任务中大放异彩。💡建议初学者掌握KNN作为理解
本文详细介绍 KNN 算法的完整实现过程,包括数据加载、归一化处理、算法实现、数据集划分、性能测试以及可视化展示。KNN算法虽然简单,但在许多实际问题中表现出色,尤其适用于数据分布较为明显的情况。通过本文的代码实现和实验,希望能帮助读者可以更好地理解KNN算法的工作原理及其在实际问题中的应用。
在Scikit-Learn中使用KNN(K最近邻算法),代码体现了机器学习项目的典型工作流:数据准备→特征工程→模型训练→参数调优→性能评估。特别值得注意的是对数据分布保持(stratify)、特征标准化、交叉验证等机器学习最佳实践的完整实现,这些细节处理对模型性能有实质性影响。最终的预测概率输出也为后续的决策阈值调整等业务场景应用提供了扩展接口。
在大数据与 AI 的时代,向量数据库在高效搜索与相似度检索场景中扮演了至关重要的角色。Faiss(Facebook AI Similarity Search)作为一款强大的开源向量数据库,以其优越的性能和灵活的配置选项,成为处理高维向量检索的理想选择。本文将探讨 Faiss 的基本特点与核心技术原理、基础维护,以及基本使用,从而帮助用户搭建出高效的向量数据库解决方案。
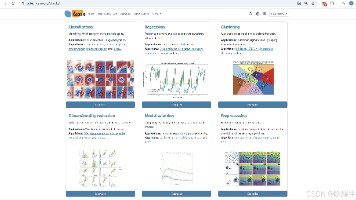
本小节使用 scikit-learn 的 KNN API 来完成对鸢尾花数据集的预测.API介绍。
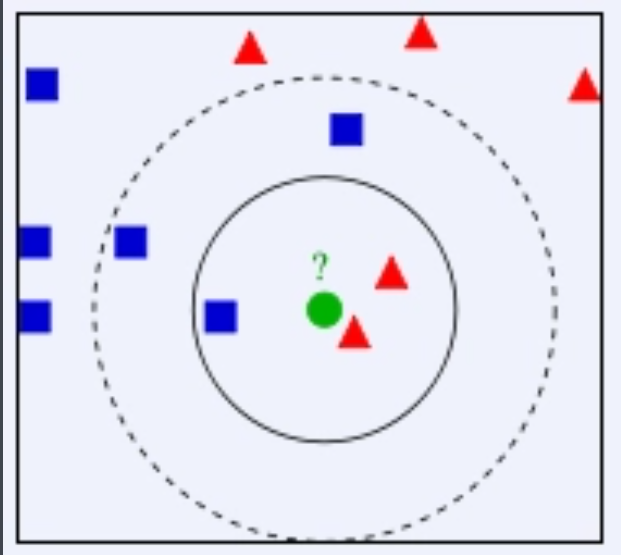
如上图所示,其中和分别代表,而带有问好的绿色小圆圈则表示待分类数据,我们如果K=3,绿色圆点的最邻近的3个点是2个红色小三角形和1个蓝色小正方形,**少数从属于多数,**基于统计的方法,判定绿色的这个待分类点应该归属于红色的三角形一类。如果K=5,绿色圆点的最邻近的5个邻居是2个红色三角形和3个蓝色的正方形,**少数从属于多数,**基于统计的方法,判定绿色的这个待分类点应该归属于蓝色的正方形一类。
sklearn.neighbors是scikit-learn库中用于实现K近邻算法的模块。它提供了用于分类、回归、密度估计等任务的K近邻算法的实现。该模块包含了多种K近邻算法的实现,如基本的KNN分类器、回归器、最近邻图等。你可以使用该模块来构建K近邻模型,并对数据进行分类、回归等任务。
plt.show()3D图:import kNNplt.show()多图:import kNNplt.show()不熟悉的函数:add_subplot:用于指定图像的位置,例如111,指图像分成一行一列,在第一幅图上画scatter:画散点图,必须输入的有x,y坐标,可选项有颜色形状等zero:创建0矩阵归一化:处理不同取值范围的特征值时,通常需要将数值未硬化,如果将取值范围处理为0到1或者-1到
kNN算法概述以及鸢尾花案例的应用
K Nearest Neighbor 算法又叫KNN算法,这个算法是机器学习里面一个比较经典的算法,总体来说KNN算法是相对比较容易理解的算法定义如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别。距离公式两个样本的距离可以通过如下公式计算,又叫欧氏距离二维平面上点a(x1,y1)与b(x2,y2)间的欧氏距离:$$$$三维空间点a(x
K-近邻算法(K-Nearest Neighbor,KNN)是一种基本的分类和回归算法。它的基本思想是通过找出与新对象最近邻的 K 个训练数据,在分类时将新对象归类为出现频率最高的类别。这个算法是机器学习里面一个比较经典的算法,总体来说KNN算法是相对比较容易理解的算法。
K近邻算法(K-Nearest Neighbors,简称KNN)是一种用于分类和回归的统计方法。KNN 可以说是最简单的分类算法之一,同时,它也是最常用的分类算法之一。KNN 算法是有监督学习中的分类算法,它看起来和另一个机器学习算法 K-means 有点像(K-means 是无监督学习算法),但却是有本质区别的。虽然K近邻算法由以下几个有以下几个优点,但也不乏这几个缺点。优点简单好用,容易理解,
小白解释:想象你在一个新城市,你想找到一个好的餐厅。你可能会问附近的几个人 (邻居) 他们的建议,然后选择最多推荐的餐厅。在应用中,k值一般取比较小的值,并采用交叉验证法进行调优。
朴素+贝叶斯,是一种简单经典的分类算法,它的经典应用案例为人所熟知:文本分类(如垃圾邮件过滤)。朴素假设:特征与特征之间相互独立优点:简单的理解和解释,树木可视化缺点:决策树学习者可以创建不能很好地推广数据的过于复杂的树,这被称为过拟合剪枝cart算法(决策树API当中已经实现,随机森林参数调优有相关介绍)随机森林集成学习方法通过建立几个模型组合的来解决单一预测问题。它的工作原理是生成多个分类器/
机器学习里面的knn算法,比较细节得分析了一个 kaggle上面的完整案例,包括处理数据、拟合模型和测试模型,计算准确率等。
机器学习算法系列(二十二)-近似k近邻算法-Annoy(Approximate Nearest Neighbor / ANN)
本篇文章主要介绍了K-近邻算法以及实现方式,并简单实现了约会网站的分析。
最近在Simulink里折腾PEMFC系统模型,把电堆、气体流道、控制策略这些模块搭起来的时候,突然发现这玩意儿跟拼乐高似的——每个零件都得严丝合缝,参数稍微跑偏整车性能就翻车。包含燃料电池汽车的燃料电池动力源功率选型,驱动电机参数匹配选型,蓄电池参数匹配选型,主减速比匹配,以满足最高车速,最大爬坡度,百公里加速时间等动力性要求。说到氢气循环泵和引射器的双模式切换,这策略比想象中复杂。然后根据参数
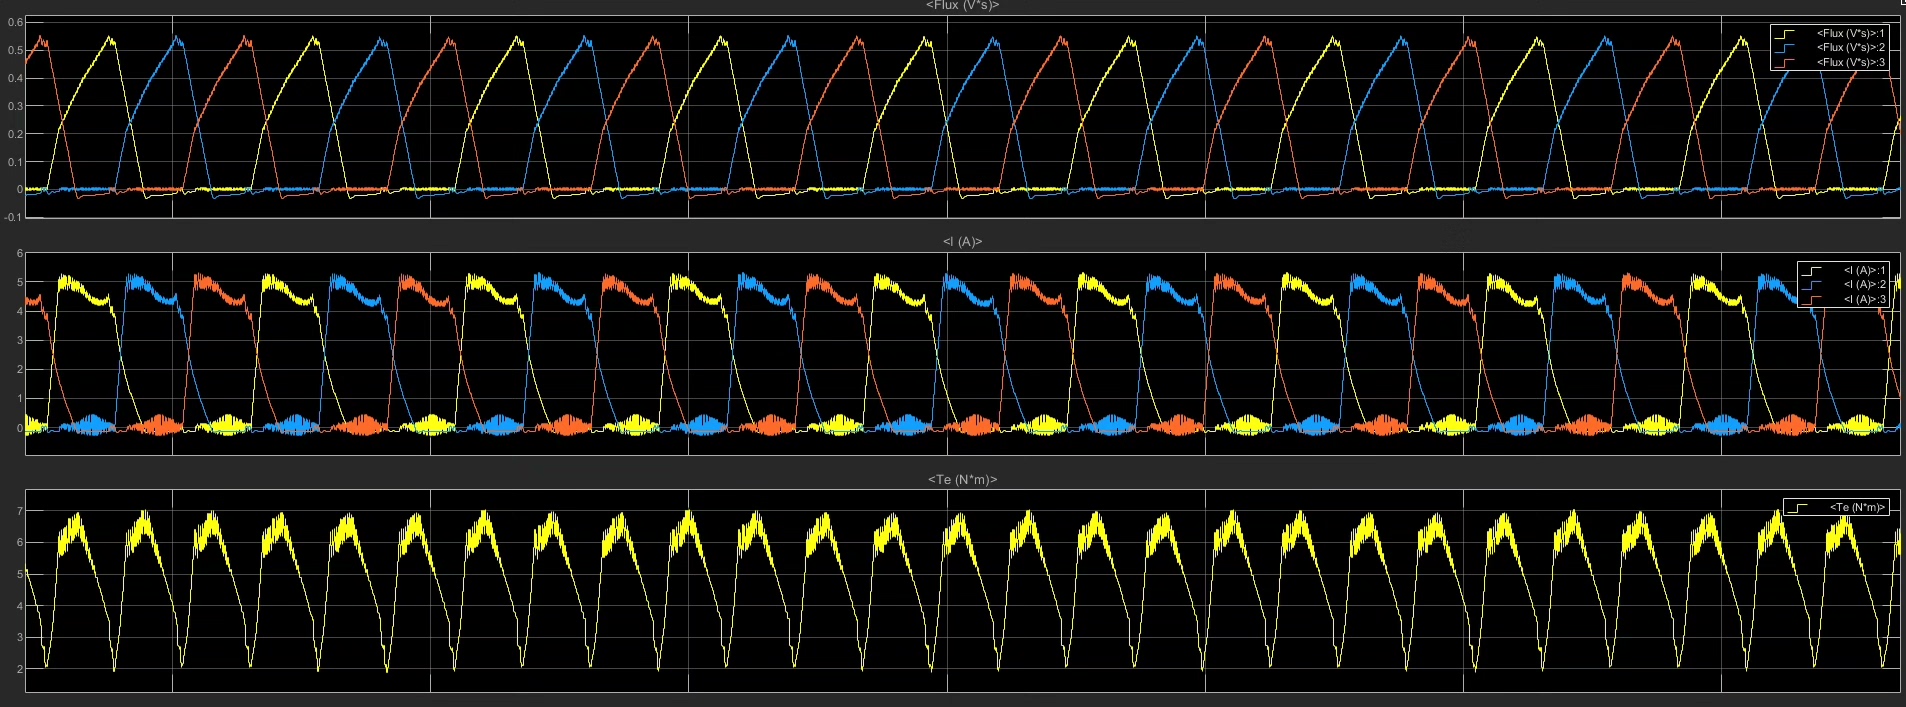
实测数据对比很能说明问题:传统PI控制在突加负载时电流超调能达到25%,而MPC控制在同等工况下超调不到8%,恢复时间缩短40%。不过计算量确实感人,某次测试中MPC的CPU占用率比PI高出3倍,这时候就需要祭出稀疏矩阵优化或者降阶模型这些加速手段了。传统PID控制总在电流脉动和转矩波动上栽跟头,这时候模型预测控制(MPC)带着它的"预判"能力闪亮登场,像极了游戏高手提前算好对手走位。Q管电流跟踪
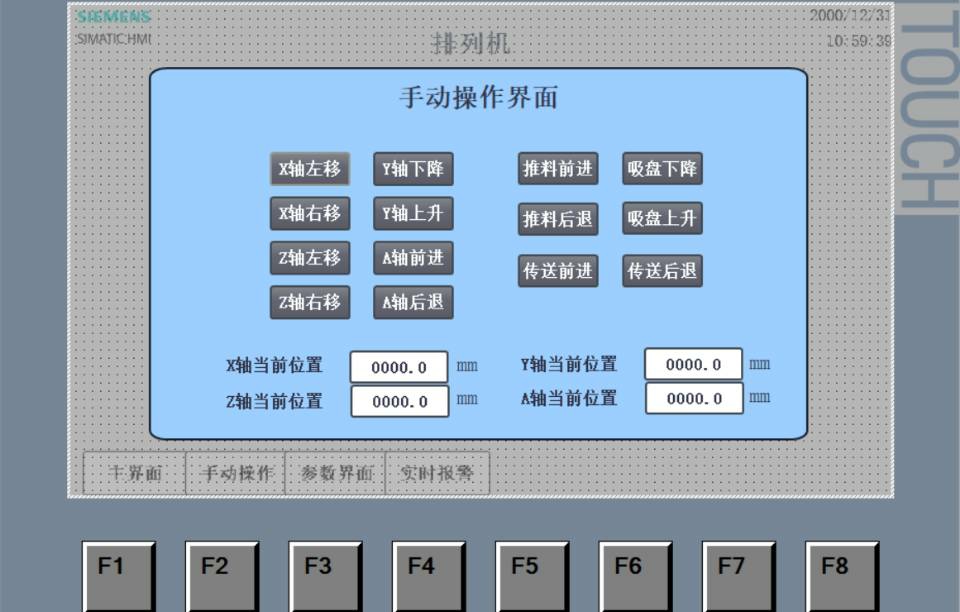
西门子FB284伺服v90profinet程序西门子触摸屏程 序,新能源行业自动排列机,真实项目,V90 走PN 口控制4轴,自己写的RFID读写FBSCL和西门子运动控制FB块开放,直接复制可用,没有密码,详细注释,轴状态全解析,报警代码全解析,RFID 读写,MES 通讯,SCL 语言,CAD电气图。去年接了个新能源电池模组排列机的项目,硬是用V90伺服配着Profinet搞定了四轴同步,顺手
通过本次设计,我们实现了一个功能完善的光伏并网逆变器系统。从硬件到软件,从理论到实践,每一个环节都经过了仔细的推敲和验证。希望这个设计能够为新能源领域的朋友们提供一些参考和启发。TMS320F28335光伏并网逆变器生产资料(另有离网状态),包含(原理图/PCB/源代码,说明文挡),无实物。提升系统的效率优化控制算法增加更多的保护功能如果你对光伏逆变器设计感兴趣,欢迎随时交流讨论!
K近邻算法
Kaggle 是全球最大的数据科学和机器学习社区和竞赛平台,由 Google 在 2017 年收购。它被广泛认为是数据科学领域的“黄金标准”实践平台,无论是对于初学者还是资深专家。核心定位:提供一个环境,让数据科学家、机器学习工程师、统计学家和数据分析师可以协作、竞争、学习,并解决真实世界的数据问题。# 数据集划分"age", # 年龄,连续数值"trestbps", # 静息血压"chol",
创建索引并非越多越好,不当的索引会增加写操作(INSERT、UPDATE、DELETE)的开销,并占用额外的存储空间。选择索引列的关键在于“选择性”。对于大数据表,优先考虑选择性高的列(如用户ID、手机号),并避免在选择性极低的列(如性别、状态标志)上创建单列索引,除非与其他列组成复合索引。如果一个索引包含了查询所需的所有字段(即SELECT的列、WHERE的条件列等都包含在同一个索引中),那么M
深度学习技术已经深度渗透到数字图像处理的各个环节,从底层的特征提取到高层的语义理解,从静态图片分析到动态视频解读,从感知理解到内容生成。它不仅仅是一种工具的创新,更是一种范式的转变,使得计算机视觉系统能够以更接近人类的方式理解和交互视觉世界。随着Transformer架构在视觉领域的广泛应用、自监督学习技术的成熟以及多模态大模型的持续发展,我们可以预见,深度学习将继续推动数字图像处理技术走向更加智
K-近邻算法(KNN)是一种基于实例的监督学习算法,通过计算待分类样本与训练集中各样本的距离,选取最近的K个邻居,统计其类别频率来预测结果。文章介绍了7种距离度量方法,包括欧式距离、曼哈顿距离、余弦相似度等,并分析了Scikit-learn机器学习库的主要模块结构和应用场景。KNN算法简单直观,是机器学习中最基础且常用的分类算法之一。
实验中,不仅成功实现 KNN 核心逻辑,解决了多类别样本的分类问题,还通过代码实践掌握了 ROC/PR 曲线的生成原理与 AUC、AP 值的计算方法,实现了 “基础指标 + 曲线分析” 的双重性能验证。4.2 曲线评估原理 ROC曲线以假正例率为横坐标、真正例率为纵坐标,通过改变分类决策阈值绘制曲线,其曲线下的面积(AUC)可衡量分类器的整体性能表现。定义:在各种阈值设置下,以假正例率(FPR)
本文介绍了KNN算法及其在约会推荐系统中的应用。KNN是一种基于实例的监督学习分类算法,通过计算样本间距离进行分类,具有"近朱者赤"的特点。针对海伦的约会推荐问题,文章设计了包含飞行里程、游戏时间和冰淇淋消费3个特征的分类器。程序设计包括数据模拟生成、特征归一化、K值优化(1-20范围交叉验证)和可视化展示。KNN优点在于简单直观、适应性强,但存在计算量大、内存消耗高、对特征尺
从传统的单体架构到微服务架构的转变,本质是模块化思维的实践升级。Java Module System(JPMS)的引入,通过明确的模块依赖声明(module-info.java)与访问控制机制(requires,exports),解决了传统包粒度划分的模糊性缺陷。某跨国企业基于集群联邦(Kubernetes Federation v2)建立三层架构:边缘集群(美国AWS)、区域集群(新加坡Azur
Hadoop MapReduce教程:WordCount案例详解,小白也能轻松上手!
近邻算法
——近邻算法
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区



 天工造物局

 DAMO开发者矩阵





 AtomGit开源社区


















 码道开发者社区





 亚马逊云科技技术品牌专区