登录社区云,与社区用户共同成长
邀请您加入社区
"用 pandas 按 segment_id 分组算折线距离,numpy 向量化算欧氏距离和加减速补偿,matplotlib 画段距离条形图+耗时饼图+轨迹散点,scipy 做距离分布检验,scikit-learn 聚类轨迹段画像,networkx 建段-点关系网,"我开工程,"数据自包含,合成一批离线编程点位数据,下载就能跑。"完整版用 OOP 封好,"我说,"一个类管点位加载,一个类算段距离,
"用 pandas 按设备+状态分组做时间差聚合,numpy 算占比,matplotlib 画堆叠条形图+甘特时间线,scipy 做状态时长分布检验,scikit-learn 聚类设备状态画像,networkx 建设备-状态转移关系网,"我开工程,"数据自包含,合成一批 FMS 状态日志,下载就能跑。"这条线,两台加工中心加一台机器人,跑了一周,"生产主管老周指着 MES 屏幕上的设备状态条,"M
"用 pandas 读两份标定数据,numpy 算欧氏距离误差向量,scipy 做配对 t 检验验证改善显著性,matplotlib 画误差对比散点+改善幅度柱状图+方向分解图,scikit-learn 聚类找改善不明显的异常点位,networkx 建'点位-方向-改善幅度'关系网,"我开工程,"数据自包含,合成 20 个点位的标定前后坐标,下载就能跑。"不是标定没用,"小赵说,"是没法证明。"a
"完整版用 OOP 封好,"我说,"一个类管设备台账加载,一个类建拓扑,一个类算中心度,一个类算安全影响域,一个类画图,一个类做节点角色聚类。"node_type": ["node_type", "type", "设备类型"],["枢纽型", "执行型", "感知型", "防护型", "辅助型"][:k]* 边 = 关系:有"送货关系"(物料流)、有"喊话关系"(信号流)、有"门禁联锁关系"(安全
"对,"小赵眼睛亮了,"我需要:对每种工件重量,测 10 次抓取力,画散点图,拟合一条'重量→抓取力'的回归线,标出安全边界(比如抓取力必须 ≥ 工件重量 × 2 的安全系数)。lambda x: 1 if str(x).lower() in ("1", "true", "yes", "是", "y", "slip", "failed")"grip_force_n": ["抓取力", "force
"这只是核心逻辑,"我说,"完整版会用 OOP 封装:一个类管数据加载(解析时间戳、坐标列),一个类管数据清洗(去重、插值、滤波),一个类管速度计算(位移/时间 + 移动平均平滑),一个类管突变检测(加速度阈值 + 滑动窗口),一个类管可视化(3D 轨迹图 + 速度剖面 + 突变点标记)。"明白了,"我打开 VS Code,"你需要一个程序:读取机器人轨迹采样数据,用相邻两点间的距离除以时间间隔算
每日统计 = 快递站长的日报表:今天总共派了 480 单,成功 465 单,失败 15 单,失败率 3.1%——其中 9 单是"收件人不在"(吸盘问题),4 单是"地址不对"(定位偏移),2 单是"电话不通"(视觉超时)。一张表、一张图,早上看一眼就知道昨晚的抓取情况。reason_col: ["失败原因", "fail_reason", "reason", "error_code"],workp
"这只是核心逻辑,"我说,"完整版会用 OOP 封装:一个类管设备节点定义,一个类管路径边定义,一个类管拓扑构建,一个类管路径分析(最短路径、连通性、瓶颈识别),一个类管可视化。"nx.shortest_path(G, source="仓库", target="检测台", weight="distance")" 一行代码算出最短路径。需要一个"车间拓扑图构建与路径分析程序",用。machines
"哥们,我们车间炸锅了。"你看,"阿强指着监控屏幕上的拓扑图,"冲压机A过热,它连着传送带B,传送带B停了,焊接机器人C检测不到来料就报警停机,装配工位D等不到零件也停了。"你看,"我指着图,"故障从液压泵出发,沿着'液压泵→冲压机→传送带→焊接机器人→装配工位'这条路径传播,用了67秒瘫痪整条线。"阿强说,"问题是,报警灯亮了,你去看,十台设备有八台亮红灯。* 根因追溯算法:从所有故障节点出发,
"阿杰说,"机器人粗磨完了,零件还在夹具上,得有人取下来放到精磨台上。反过来也一样——工人精磨完了,等着机器人出下一个粗磨件,机器人还在磨呢,工人也只能干等。"你看,"我指着图,"当前方案的问题在于'装夹'这个动作没人负责——机器人干完粗磨,得等工人来取。"我说,"机器人干粗磨是合适的,但装夹这个动作,你让它等人工来取,就成了瓶颈。反过来,有时候机器人还在粗磨,工人已经精磨完上一个,只能干等机器人
"我们车间有句行话:'全网拓扑是给网管看的,产线拓扑是给工程师用的。核心矛盾:"网络管理需要清晰的单产线拓扑以实施隔离和排障"与"全车间拓扑数据混杂,缺乏按产线属性提取子图的能力"之间的冲突。ax.set_title(f"{target_line} 网络拓扑({G.number_of_nodes()} 节点, {G.number_of_edges()} 条边)",。"小陈指着图的一角,"这条线有1
它锁定了打开时间点时刻的分片与 Lucene 段引用,确保后续所有关联该 PIT 的滚动检索看到的是一份完全冻结一致的数据视图,不受后续写入、删除或段合并的影响。在循环滚动中,每次 SearchResponse 会返回一个新的 pit_id(可能与初始传入的值相同或刷新了上下文)。为了兼顾 Scroll 的数据一致性视图 与 search_after 的轻量低内存消耗,Elasticsearch
Python天气预报数据可视化分析系统是一个基于Python Flask框架开发的Web应用程序,旨在为用户提供济南及周边地区的天气数据可视化分析功能。系统通过爬取实时天气数据,结合历史天气数据,为用户提供直观的天气信息展示、数据分析和预测服务。
前端框架:HTML,CSS,JAVASCRIPT,Echarts后端:Django数据处理框架:Pandas数据存储:Mysql编程语言:Python/Scala推荐算法:(1、ItemCF 2、UserCF)数据可视化:Echarts协同过滤算法(Collaborative Filtering)是推荐系统中常用的一种技术,主要用于根据用户的历史行为(如购买记录、评分、浏览记录等)来推荐用户可能感
1、该资源内项目代码都经过测试运行成功,功能ok的情况下才上传的,请放心下载使用!2、本项目适合计算机相关专业(如计科、人工智能、通信工程、自动化、电子信息等)的在校学生、老师或者企业员工下载学习,也适合小白学习进阶,当然也可作为毕设项目、课程设计、作业、项目初期立项演示等。3、如果基础还行,也可在此代码基础上进行修改,以实现其他功能,也可用于毕设、课设、作业等。下载后请首先打开README.md
plt.title(f"质量预测决策边界\n({third_feature}={third_value:.2f})", fontsize=16, fontweight="bold", fontfamily="SimHei")plt.legend(handles=scatter.legend_elements()[0], labels=["合格", "不合格"], loc="upper right"
讲解用于物品推荐系统的协同过滤算法:余弦相似度、皮尔逊相关系数、矩阵分解(SVD),并比较其优缺点。
基于Flask的智能服装搭配推荐系统,采用协同过滤和内容过滤的混合推荐算法,支持虚拟试穿和个性化建议。
推荐系统(基于用户的协同过滤)
等非对称加密算法的原理,并提供Python实现代码及安全性分析。非对称加密算法(Asymmetric Encryption)使用。,解决了对称加密的密钥分发问题。
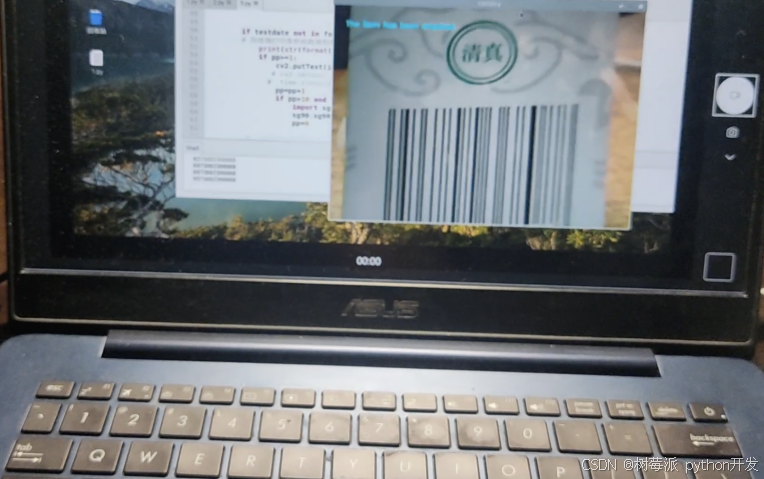
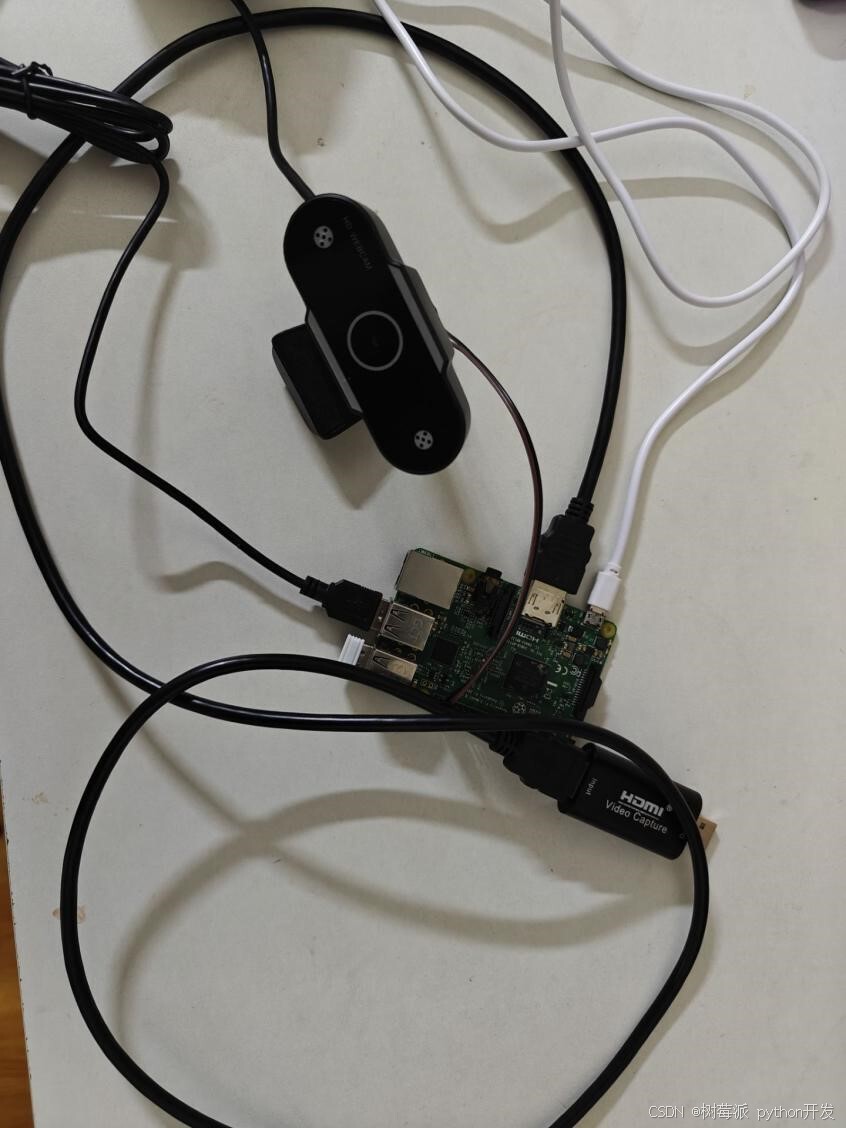
二维码扫码识别整体实物该基于树莓派的无人值守柜台机,结合了多种先进的人工智能技术,包括人脸识别、商品扫描、舵机控制和目标检测,能够实现高效的无人零售服务。通过集成人工智能与自动化技术,这种无人值守柜台机不仅提升了顾客的购物体验,也为商家提供了更智能、高效的库存管理方案。通过本文提供的代码示例和技术架构,您可以快速搭建一个属于自己的智能零售柜台,为无人零售的未来贡献一份力量。#树莓派 #AI技术 #
通过该基于树莓派的疲劳驾驶检测系统,可以大大提高驾驶安全性,减少因疲劳驾驶引发的交通事故。该系统具有较高的实时性和准确性,适合在实际驾驶环境中应用。希望我的设计能够为大家提供一些启发,欢迎大家一起讨论优化方向!
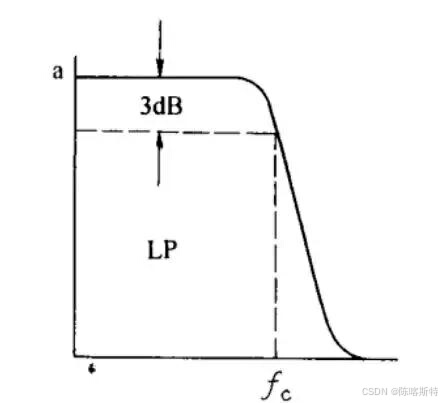
有源滤波器和无源滤波器是电子电路中常用的两种滤波器类型,它们在结构、特性等方面有明显的区别:1)有源滤波器是指使用有源元件(如运算放大器、晶体管等)并且通常包含电源供电的滤波器。它们能提供增益,能够增强信号。无源滤波器仅由无源元件(如电阻、电容、电感等)构成,不需要外部电源,无法提供增益,信号的幅度可能会减小。有源滤波器典型结构:由运算放大器和无源元件(R、C等)组合而成。可以设计成多种类型的滤波
机器学习分类模型是一种通过学习数据集中的特征与标签之间的关系,从而对新的数据进行分类的方法。其基本思想是通过训练数据来构建一个模型,然后利用这个模型对新的数据进行分类。常见的分类模型包括逻辑回归、支持向量机、决策树、随机森林、K近邻等。机器学习分类模型是一种通过学习数据的特征与它们所属类别之间的关系,从而对新的未知数据进行分类的算法。这些模型可以用于解决各种分类问题,如图像识别、文本分类、医学诊断
pandas使用基本介绍
`q_values = tf.gather_nd(q_values, ...)`:按实际采取的动作,**从 4 个里挑出对应的那一个**(`tf.range` 样本索引 + `tf.cast(actions, int32)` 作为列索引,拼成坐标去。- `max_qsa = tf.reduce_max(target_q_network(next_states), axis=-1)`:用 **tar
数据挖掘是从大量数据中提取或“挖掘”出先前未知、潜在有用且最终可理解的知识(如模式、关联、变化、异常和有意义的结构)的非平凡过程。它被视为数据库知识发现(KDD)过程中的一个核心步骤,旨在将数据转化为信息和知识。
文章摘要 本文系统介绍了图数据库的核心概念、技术特点及应用场景。图数据库以节点、关系和属性高效表达复杂网络关系,适用于社交网络、推荐系统等领域。重点讲解了Neo4j等主流图数据库的数据建模方法,包括Cypher查询语言的基本操作和复杂查询示例,并提供了Python连接Neo4j的代码实现。通过社交网络建模实例,展示了图数据库在关系遍历与推荐算法中的优势,为开发者提供从入门到实践的完整指南。(148
摘要:本文介绍了如何使用 Python 的 scikit-learn 库实现决策树模型,涵盖分类和回归两种主要场景。在分类部分,重点讲解了数据准备、模型创建、训练、预测与评估,并指出过拟合、数据质量和特征选择等注意事项,提供了基于鸢尾花数据集的示例代码。对于回归模型,同样阐述了建模流程,并以模拟数据演示了 DecisionTreeRegressor 的应用。文章强调了剪枝、数据预处理的重要性,并展
本文深入探讨了神经网络和深度学习在各种数据分析场景中的应用,并结合统计学原理进行了解读。从基础概念到实际应用,涉及自然对数、负相关、相关系数、类不平衡问题以及如何使用scikit-learn等工具进行数据处理。文章还讨论了何时使用神经网络和深度学习,以及它们的局限性,提供了一个全面的技术和应用视角。
最近在学习李航老师的《统计学习方法》第16章-主成分分析(PCA),结合运用python代码实现,记录一下。
它建立在强大的科学计算库之上,包括 NumPy、SciPy 和 Matplotlib,提供了丰富的机器学习算法和工具,如分类、回归、聚类、降维、模型选择和数据预处理等。Scikit-learn 是 Python 生态系统中不可或缺的机器学习库,其易用性、效率和丰富的功能使其成为数据科学和机器学习的首选工具。在接下来的章节中,我们将深入探讨 Scikit-learn 的高级功能和实用技巧,以帮助您更
又来按时更新帖子啦,现在学习一个更复杂(也就复杂一丢丢)的模型啦,多项式回归,还是一样,带大家了解多项式回归,如何建立模型,如何运用模型,如何使用这个模型来拟合自己的数据集,如何做出预测。代码解析超级详细,适合建模新手学习#
这段文字主要描述了使用 GitHub Copilot 进行数据分析的演示过程。作者通过输入简单的注释,例如“创建数据框并应用过滤器”,GitHub Copilot 自动生成相应的代码。演示涵盖了数据读取、缺失值处理、创建散点图和直方图、以及使用机器学习算法等步骤。具体来说,作者使用 GitHub Copilot 完成了以下操作:读取数据: 使用注释“创建数据框并应用过滤器”,GitHub C...
Scikit-Learn工具包提供了多种聚类算法,涵盖了不同的聚类方法和应用场景。
高斯混合模型(Gaussian Mixture Model,简称GMM)是一种概率性的聚类算法,它假设数据是由若干个高斯分布混合而成的。每个高斯分布对应一个聚类,而GMM的目标就是找出这些高斯分布的参数以及每个样本属于这些聚类的概率。
Scikit-learn,也被称为sklearn,是一个针对Python编程语言的免费软件机器学习库,是一个功能强大、易用且广泛应用的Python机器学习库,为数据科学家和开发者提供了丰富的工具和资源来进行机器学习任务的开发与实践。Scikit-learn起源于David Cournapeau的Google Summer of Code项目,名为scikits.learn。Scikit-learn
【零基础入门学习Python---Python中数据分析与可视化之快速入门实践】本文介绍了如何使用Python进行数据分析与可视化,包括使用NumPy进行数值计算和数组操作、使用Pandas进行数据处理和分析、使用Matplotlib和Seaborn进行数据可视化、数据分析实践案例(数据清洗、探索性分析、特征工程)方面。这些工具和方法可以帮助我们从数据中提取出有意义的信息,并得到洞见,从而有效地支
本文为学校课程《机器学习》中老师给出的一些有关机器学习的简答题的详细解答,可供复习参考,基本答案全是正确的。
矩阵不是很方便观察,可以直接排序median_house_value列,可以看出median_house_value与median_income的相关性挺大的。可以看到rooms_per_household比total_rooms和households的相关性都要高一点,bedrooms_per_room也是,但是population_per_household反而变差了,大概是不适合这种特征组合
项目以购物篮分析为切入,分析某跨国零售商的历史订单数据,为企业在监测业务指标、识别业务问题、商品运营及用户运营提供提供建议
机器学习小白,通过不断跑demo打怪提升段位
本文主要讲解了特征工程,特征工程中的scikit-learn数据集的获取,以及特征抽取中的字典抽取、文本抽取和使用TF-IDF抽取。以及一些基于Python的代码操作。
1.scikit-learn库的产生scikit-learn最初是David Cournapeau在2007年Google夏令营的代码项目中首次实现的。后来Matthieu Brucher加入了这个项目,并开始将其作为论文工作的一部分。2010年,INRIA参与其中,并于2010年1月第一次公开发布scikit-learn的v0.1 beta版本。该项目目前有30多名活跃的贡献者,并已获得...
Scikit-Learn 处理文本数据与官方文档完美匹配的中文文档,请访问 https://www.studyai.cn学习教程的配置项加载 20 newsgroups 数据集从文本文件中抽取特征词袋(Bags of words)使用scikit-learn对文本分词(tokenize)从出现次数到出现频率训练一个分类器构建一个管道流在测试集上评估性能使用网格搜索进行参数调节...
人脸数据集来自英国剑桥AT&T实验室,包含40位人员照片,每个人10张。sklearn.datasets自带此数据集。下载链接:The Database of Faces_AT&Timport matplotlib.pyplot as pltimport numpy as npimport timeim
世界模型 #通用人工智能 #AGI #大模型前沿#具身智能 #机器人 AI #数字孪生 #智能体 #多模态大模型。一、问题在于只预测下一步不够。三、世界模型不是通用仿真器。二、世界模型能做什么。四、工程上的现实难题。
本文介绍了Python数据统计分析的完整流程,包括环境配置、数据获取、清洗预处理等核心环节。首先展示了Python数据科学生态系统(Pandas、NumPy、Matplotlib等)的配置方法,然后详细讲解了从CSV、Excel、SQL和API等不同数据源加载数据的实现代码。文章重点演示了数据探索分析技术,包括基本统计信息查看、缺失值检测与处理(删除、填充、插值等方法),以及针对分类变量的独热编码
scikit-learn
——scikit-learn
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 AI硬件创业社区

 乐奇 Rokid 开放社区


 亚马逊云科技技术品牌专区
 天工造物局








 AtomGit开源社区